Module 03 · Data Visualization
Statistics by Groups分组统计
我们已经掌握了均值和标准差的计算,现在将利用这些知识在不同群体之间进行比较分析。
一、 数据分组比较 (Group Comparisons)
我们继续使用德克萨斯大学(University of Texas)包含 463 门课程的教学评价数据集,重点关注:教学评价得分、美貌评分和年龄。
1. 初步均值对比(基于 463 门课程数据)
- 性别与教学评价:
- 👩 女性讲师:3.9
- 👨 男性讲师:4.06
- 终身教职 (Tenure) 与教学评价:
- 🎓 已获终身教职:3.96
- 🚫 未获终身教职:4.13
- 教职状态与年龄:
- 未获终身教职讲师平均年龄:50.2 岁
- 已获终身教职讲师平均年龄:47.85 岁
二、 核心统计陷阱:样本重复问题
在统计分析中,思考**研究对象(总体/样本)**的定义至关重要。
数据重复导致的偏差
- 现状:数据集中有 463 门课程,但实际上是由 94 位讲师教授的。这意味着许多讲师被重复计算了多次。
- 风险:如果年长的讲师授课数量多于年轻讲师,直接计算 463 门课程的平均年龄会产生偏高误导,这反映的是“课程的平均年龄”而非“讲师的平均年龄”。
- 解决方案:通过**数据子集化(Subsetting)**剔除重复项,使每个讲师仅保留一个观测值(样本量从 463 降至 94)。
数据对比分析(94 位讲师 vs 463 门课程)
| 变量 | 94位讲师(无重复) | 463门课程(含重复) | 结论 |
|---|---|---|---|
| 平均美貌得分 | 0.25 | 0.11 | 差异显著 |
| 男性平均年龄 | 49.4 | (数值相近) | 差异较小 |
| 女性平均年龄 | 44.9 | (数值相近) | 差异较小 |
关键启示:若使用包含多次重复个体的错误数据集,会显著误导美貌评分等变量的分析结果。
三、 数据可视化:从统计到沟通
可视化不仅能帮助我们发现趋势,还能让复杂的数据更易理解。
1. 探索性分析:学分与评价
- 问题:单学分课程的讲师是否获得更高评价?
- 发现:是的。通过柱状图可见,教授单学分课程的讲师平均教学评价略高。
2. 统计价值 vs 沟通价值
- 统计目的:一个简单的条形图可以告诉我们男女讲师分别教授了多少课程,这在统计上是完整的。
- 沟通目的:如果缺乏标题和标签,图表就像一张没有路名的地图。
类比:你可以看到街道、建筑和公路(比例精确、描绘准确),但没有路名,你无法确定方位和目的地。
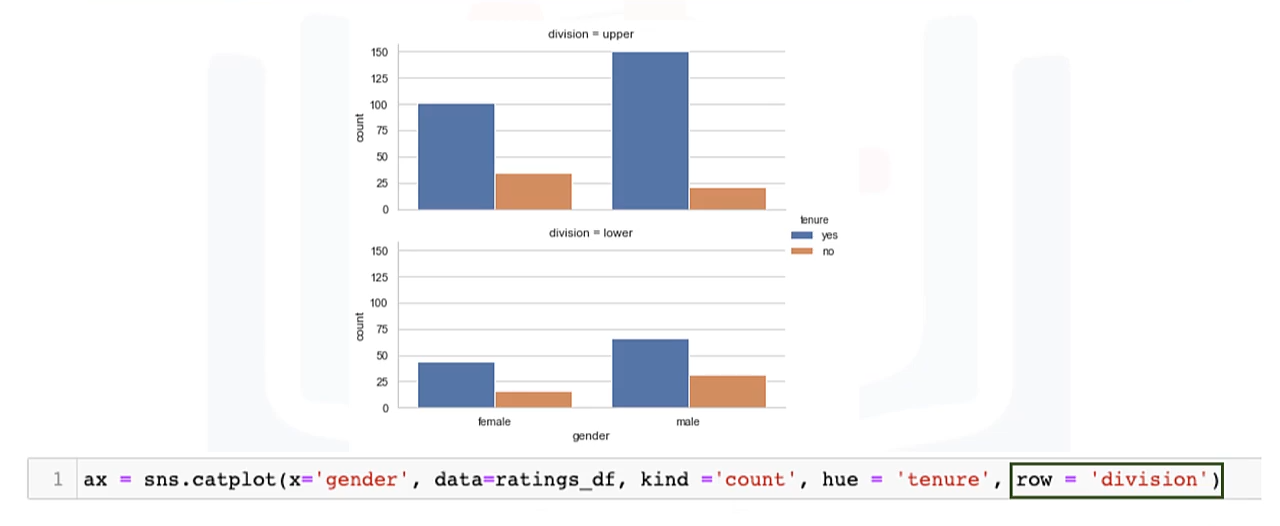
3. Python 可视化进阶(使用 Seaborn)
- 基础绘图:使用
countplot函数并设置title标签。 - 增加维度 (Hue):在 Python 中添加
hue参数,可以同时展示性别和终身教职状态。 - 分面展示 (Rows/Cols):通过指定
rows参数,按“高年级课程/低年级课程”将图表拆分为多行或多列。
四、 多维关系探索:连续变量与类别变量
当我们关注两个连续变量(如年龄与教学评价)的关系,并想加入多个类别变量(如性别与教职状态)时:
多维图表布局
- 坐标轴:X 轴(年龄),Y 轴(教学评价得分)。
- 视觉编码:
- 🟠 橙色圆圈:男性
- 🔵 蓝色圆圈:女性
- 分面板展示 (Faceting):
- 顶层面板:已获终身教职教授。
- 底层面板:未获终身教职讲师。
Python 实现:FacetGrid
在 Python 中使用 FacetGrid 选项:
- 网格设置:为类别变量(教职状态和性别)创建行(row)和色调(hue)。
- 映射函数 (Map):使用
.map将绘图函数应用到每个数据子集。