课程笔记
Course Notes课程笔记
1. 设置机器学习应用程序
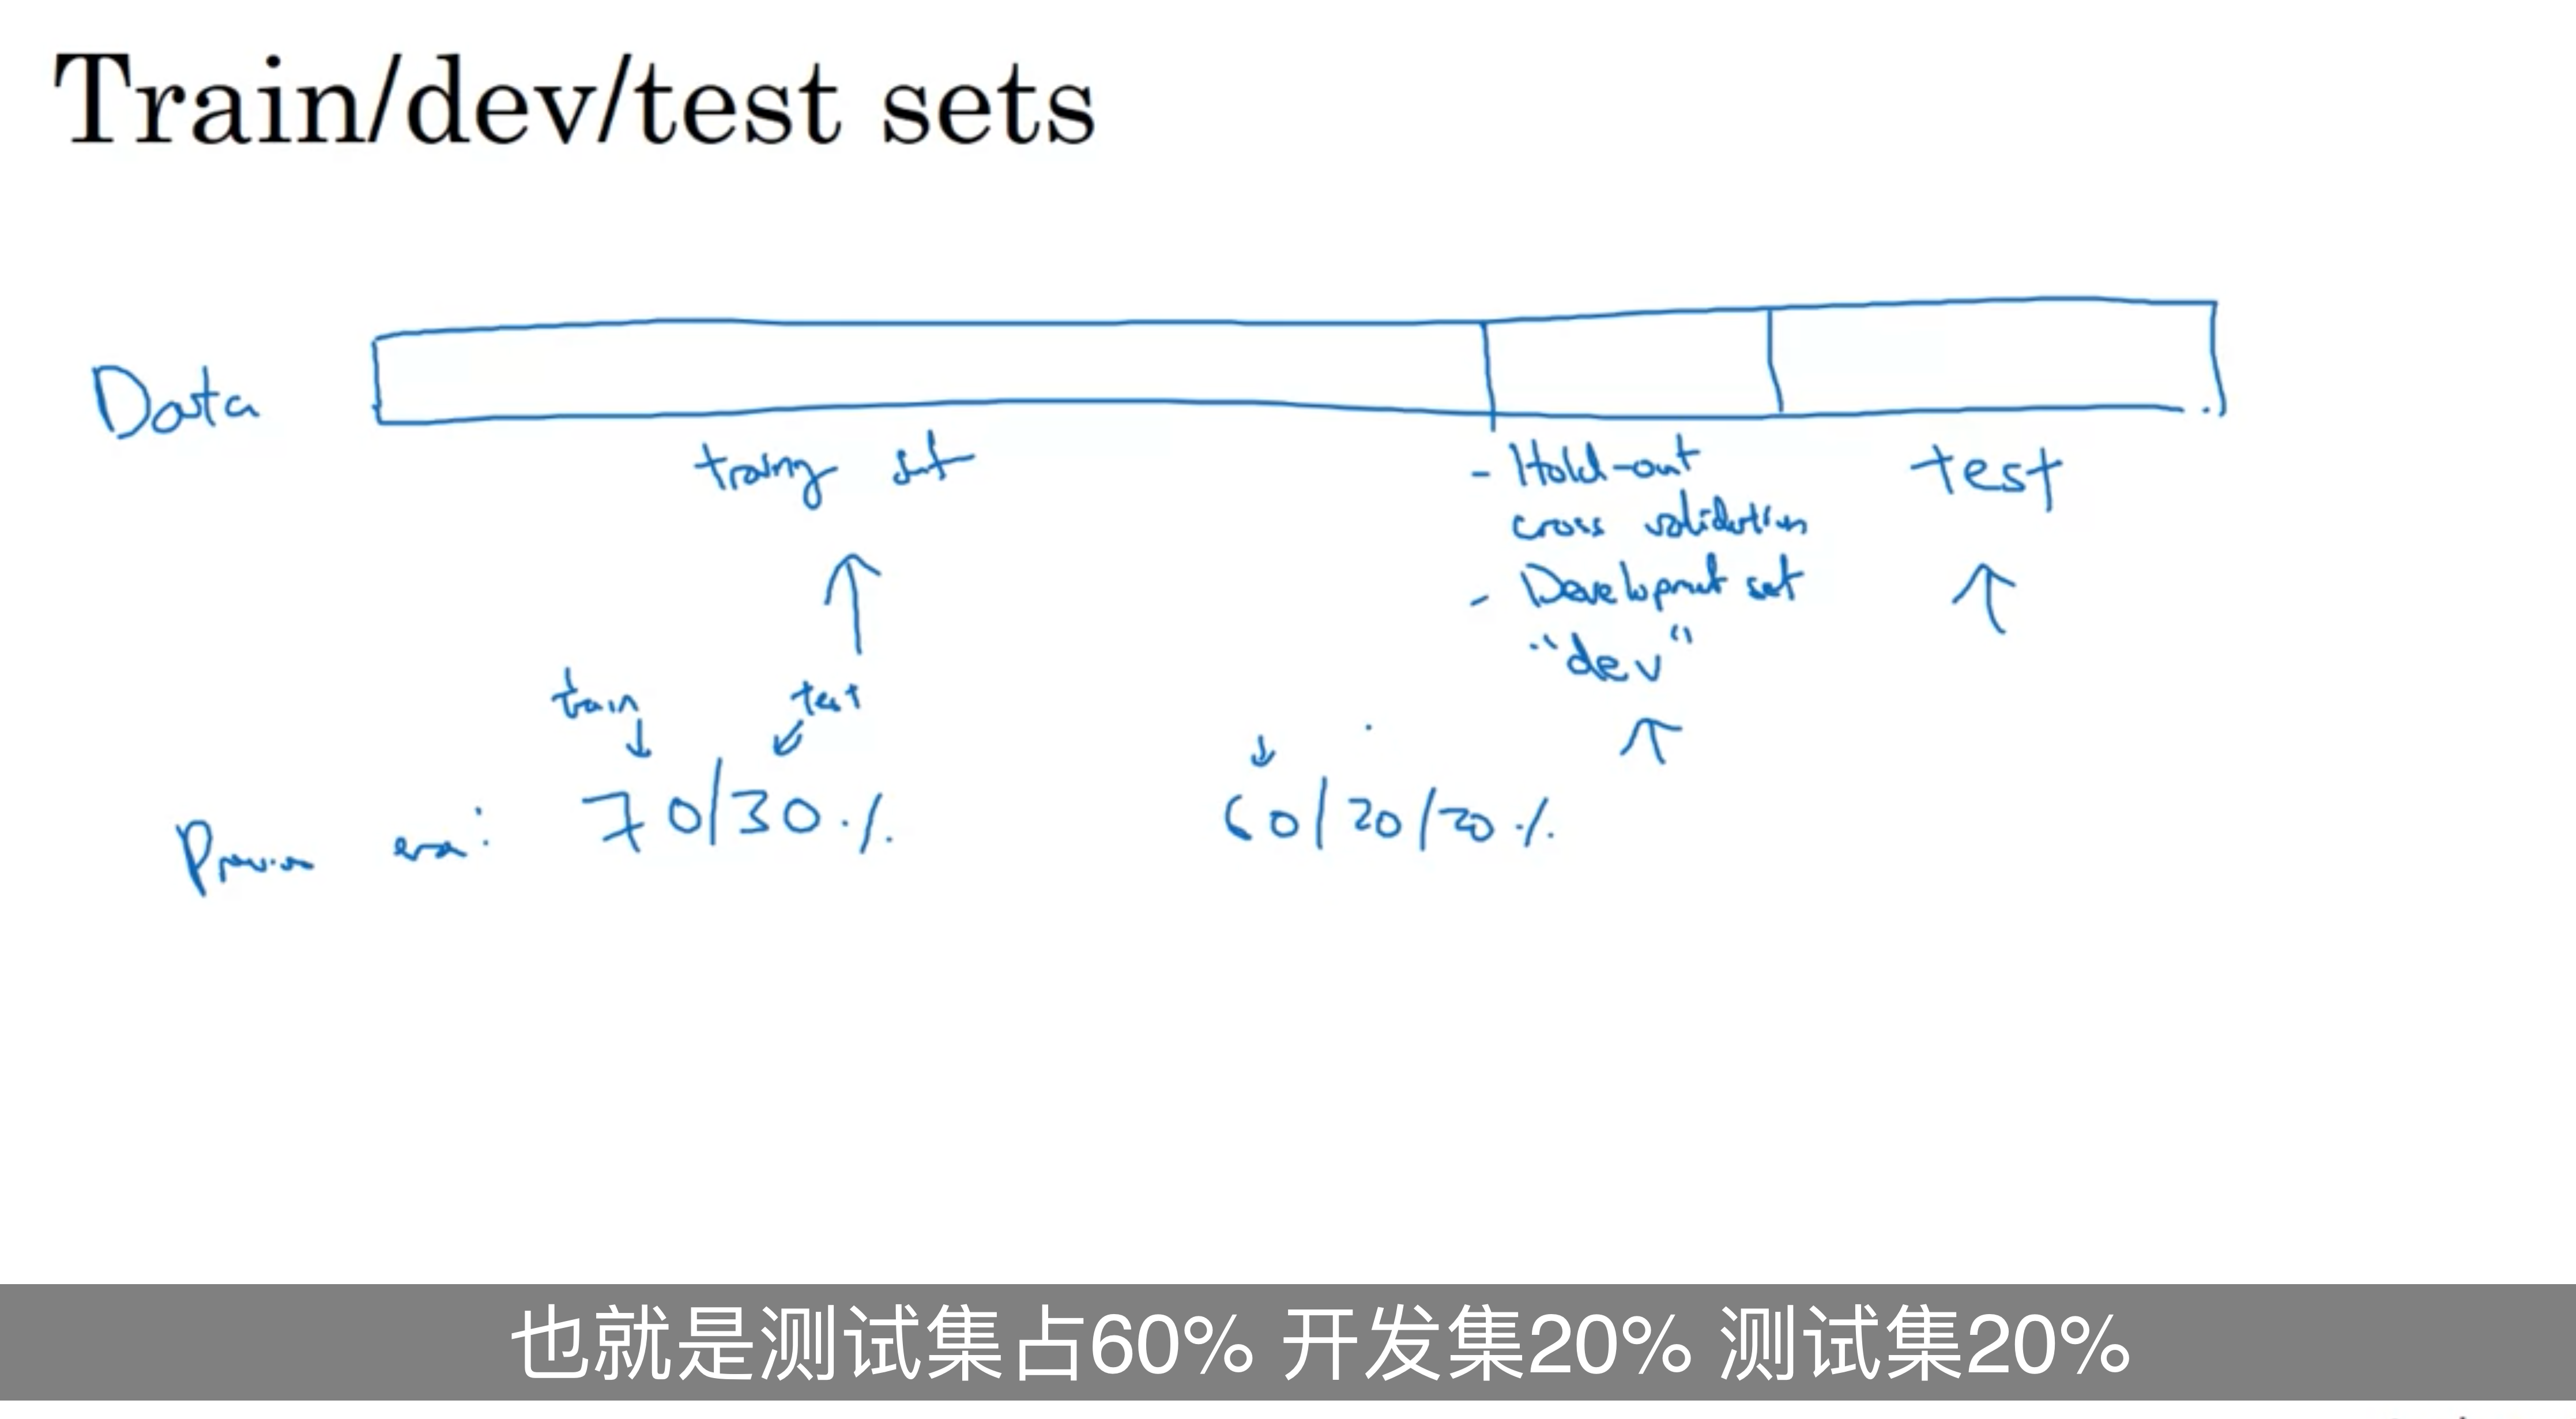
过去:(10000以下总样本)
训练集、测试集:70/30
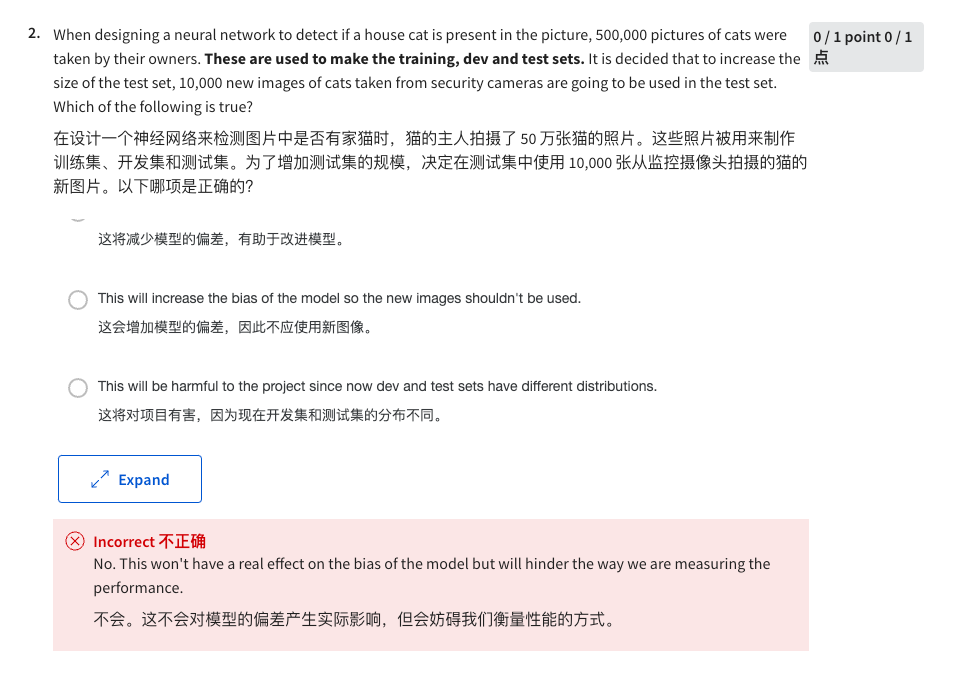
训练集、开发集、测试集:60/20/20
现在:总共100万个样本,保留10000个开发、10000个测试就够了 98/1/1
尽量让(train)dev和test数据分布相同
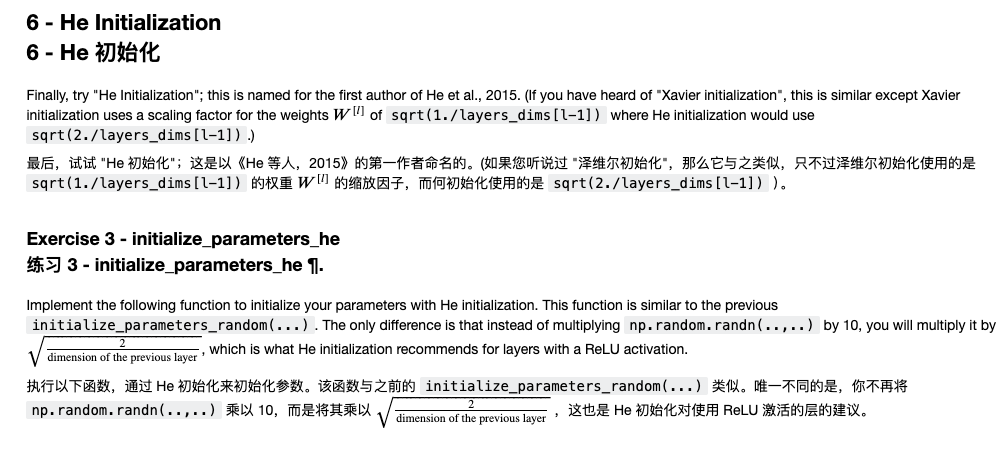
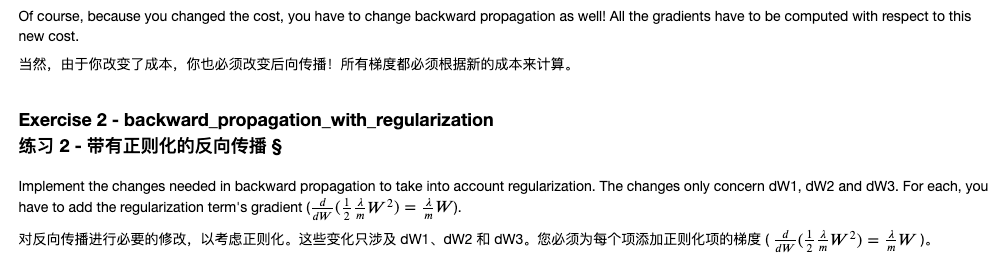
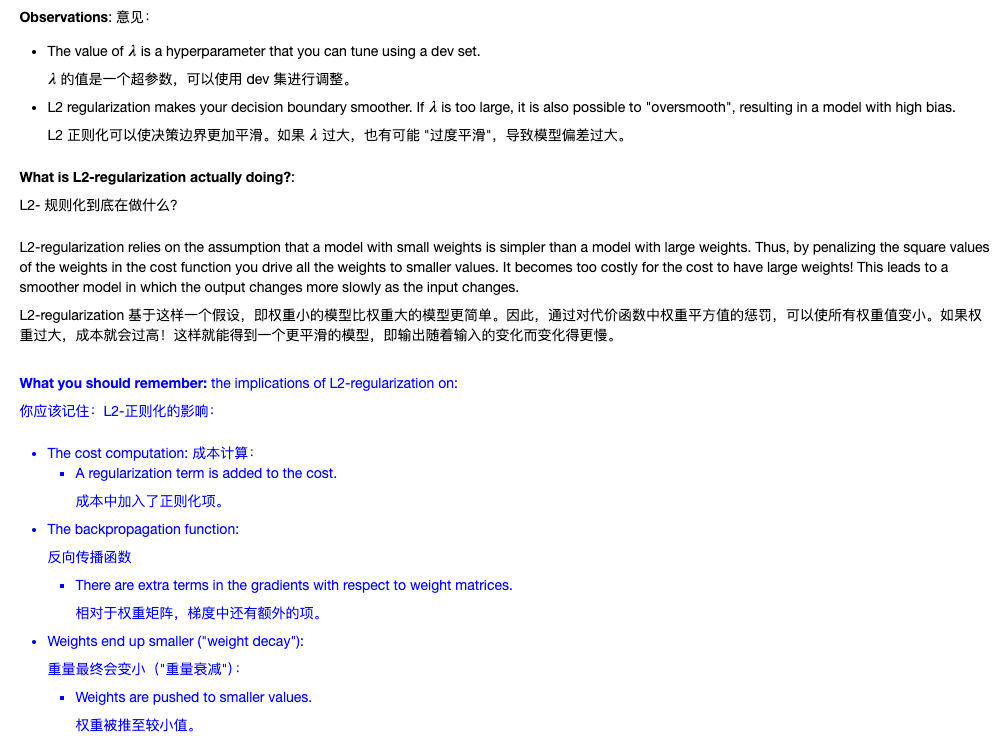
正则化公式:
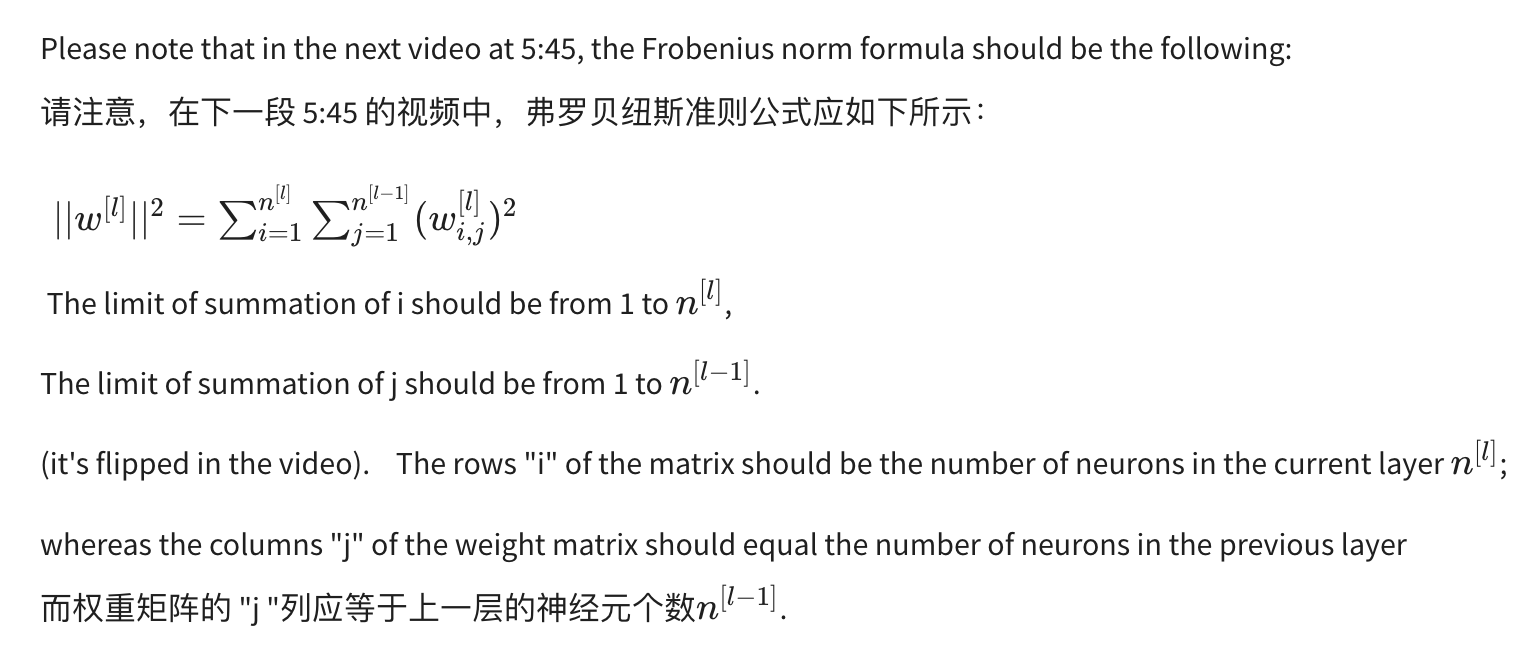
weight decay:
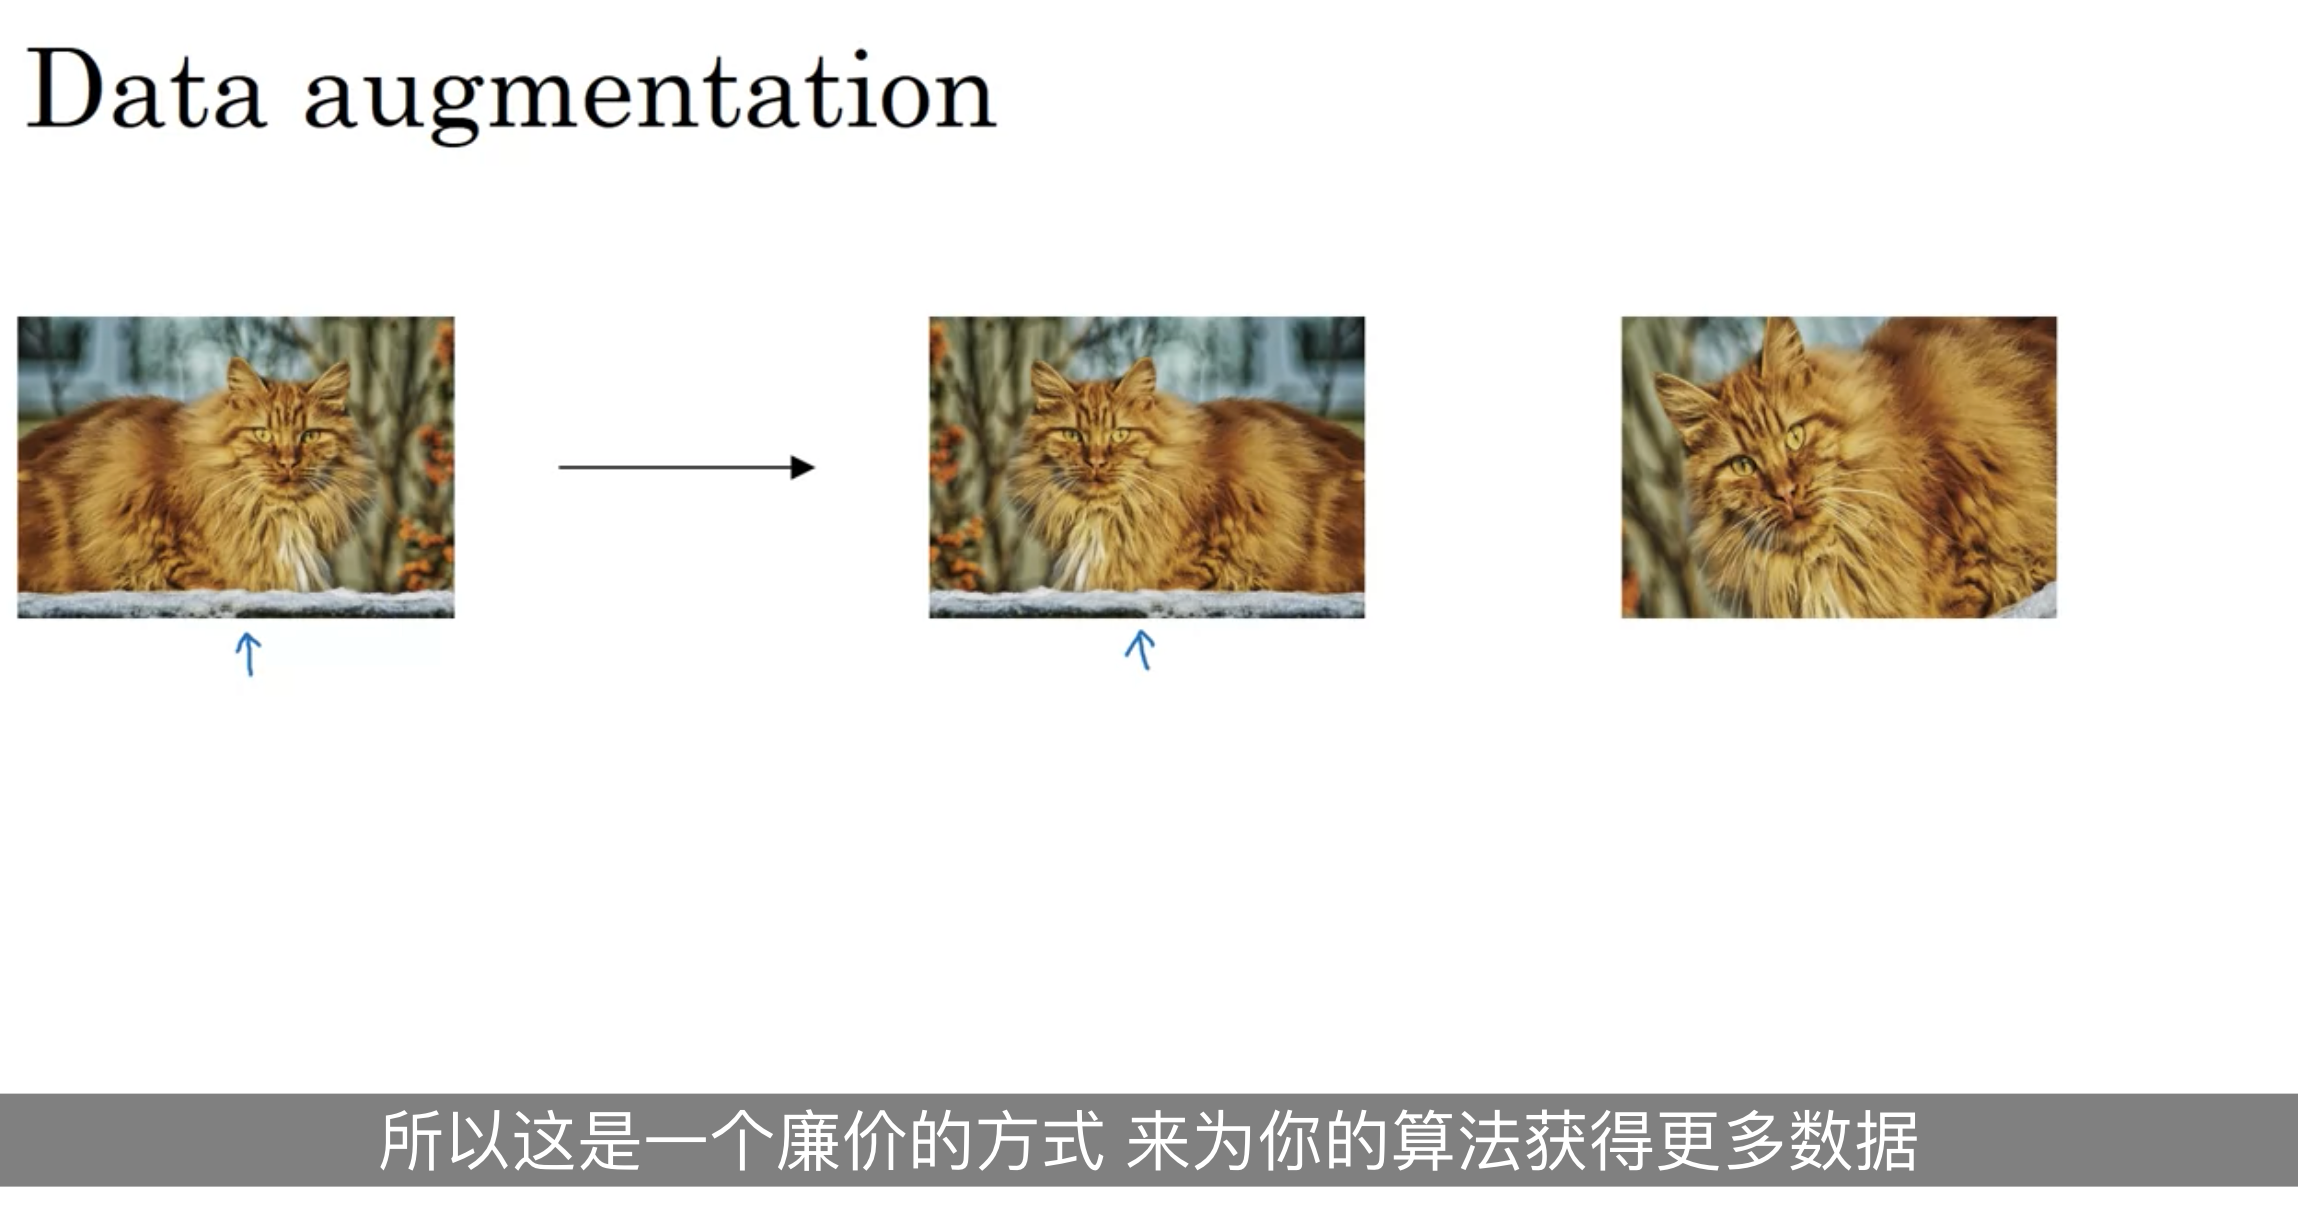
我很疑惑,那为什么不直接限制模型是对称不变的呢、以及旋转不变?
嗷,因为比如一只上下翻转的猫还是猫吗
📄 C2_W1.pdf
错题本:
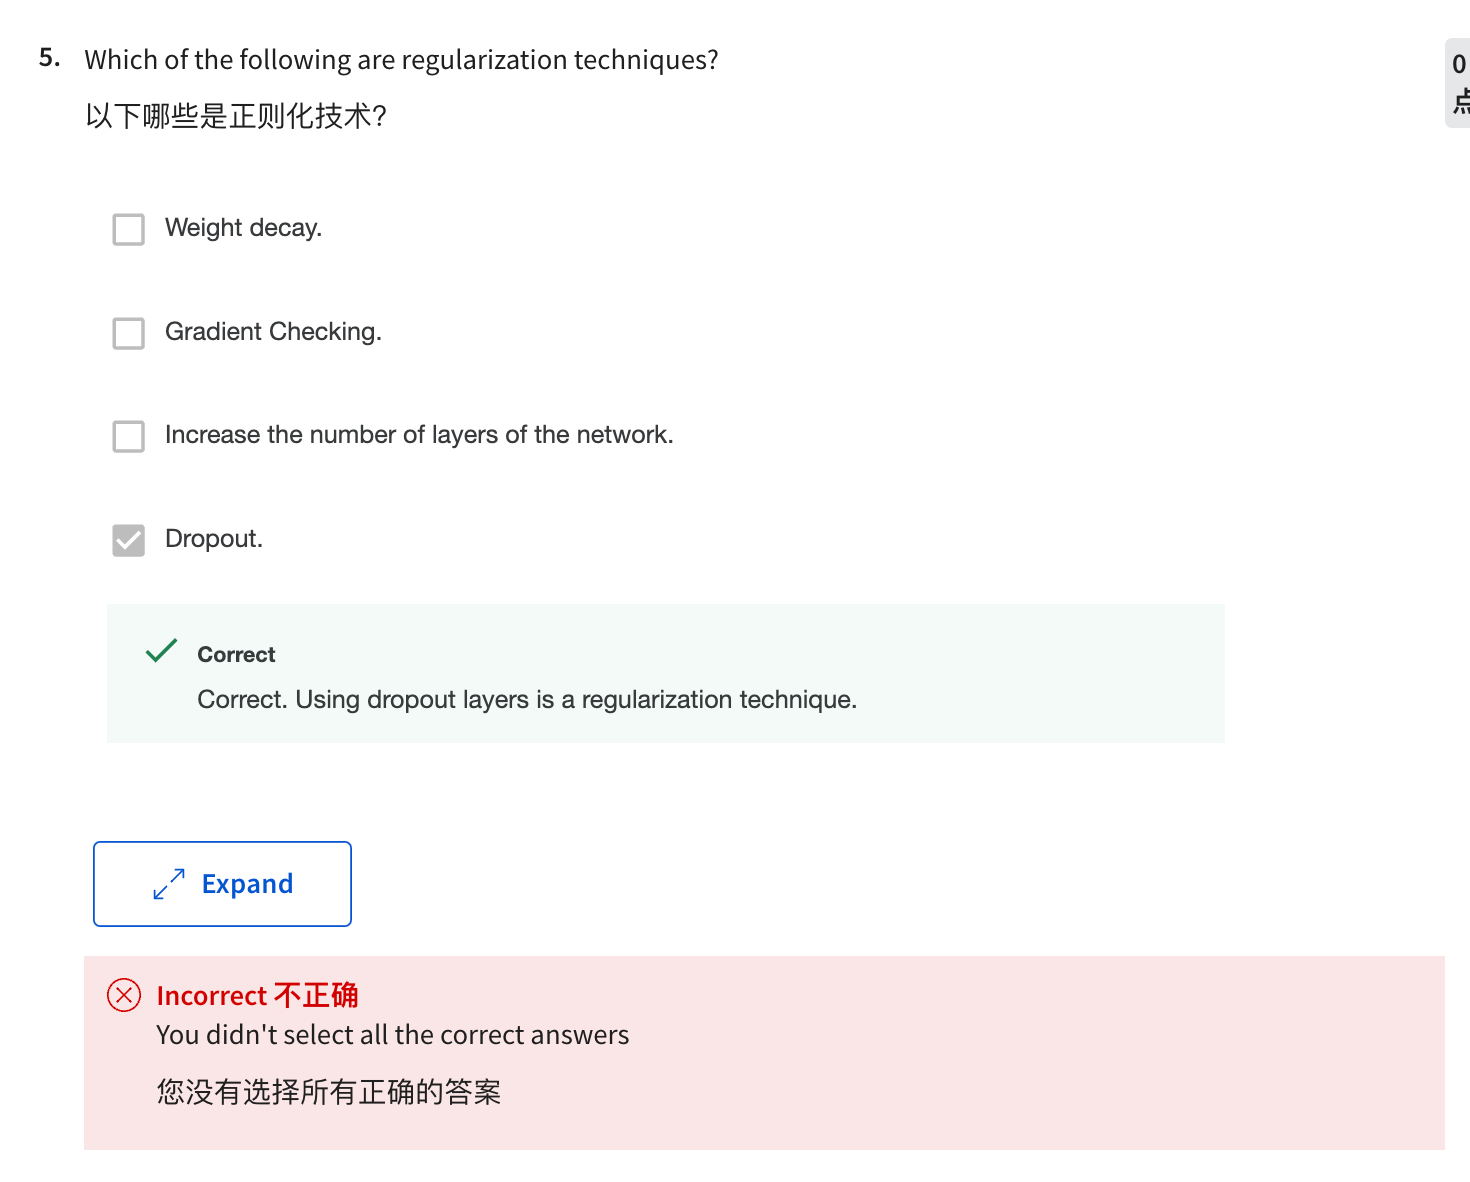
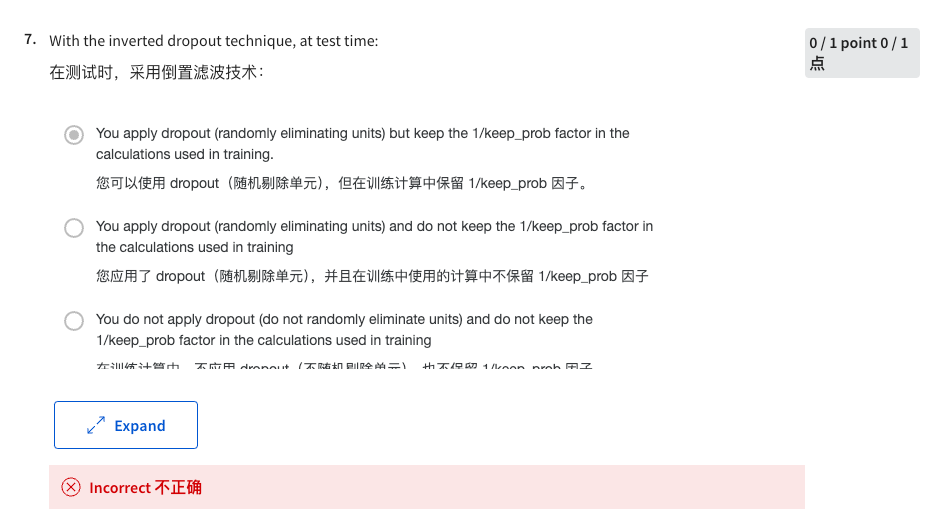
- Weight decay(权重衰减):权重衰减是正则化技术之一,通过在损失函数中添加权重的平方和项,鼓励模型的权重保持较小,从而防止过拟合。
- Gradient Checking(梯度检查):梯度检查是一种用于验证反向传播实现正确性的技术,不属于正则化技术。
- Increase the number of layers of the network(增加网络层数):增加网络层数不是正则化技术,反而可能会导致模型过拟合。
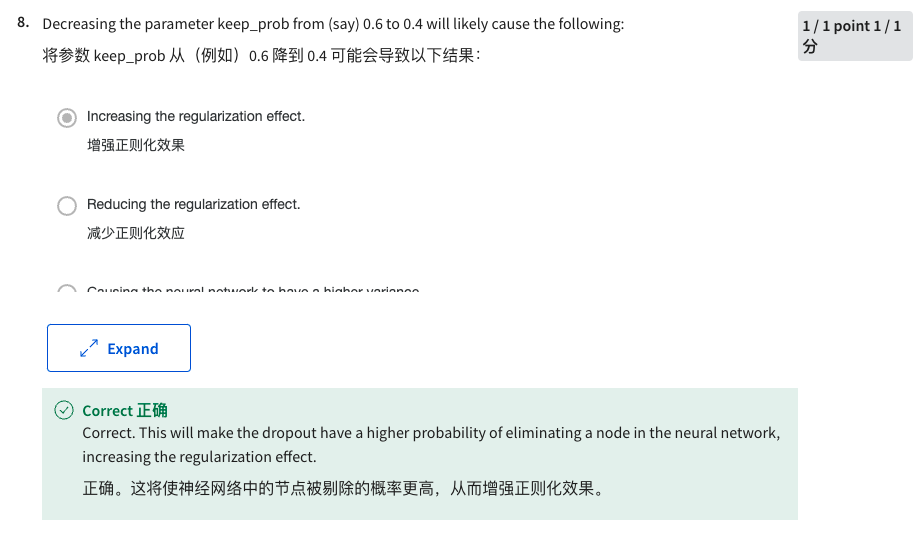
- Dropout(丢弃法):Dropout 是一种常用的正则化技术,通过在训练过程中随机丢弃一部分神经元,防止模型过拟合。
综上所述,正则化技术包括:
- Weight decay
- Dropout
所以,正则化技术的选项是 Weight decay 和 Dropout。
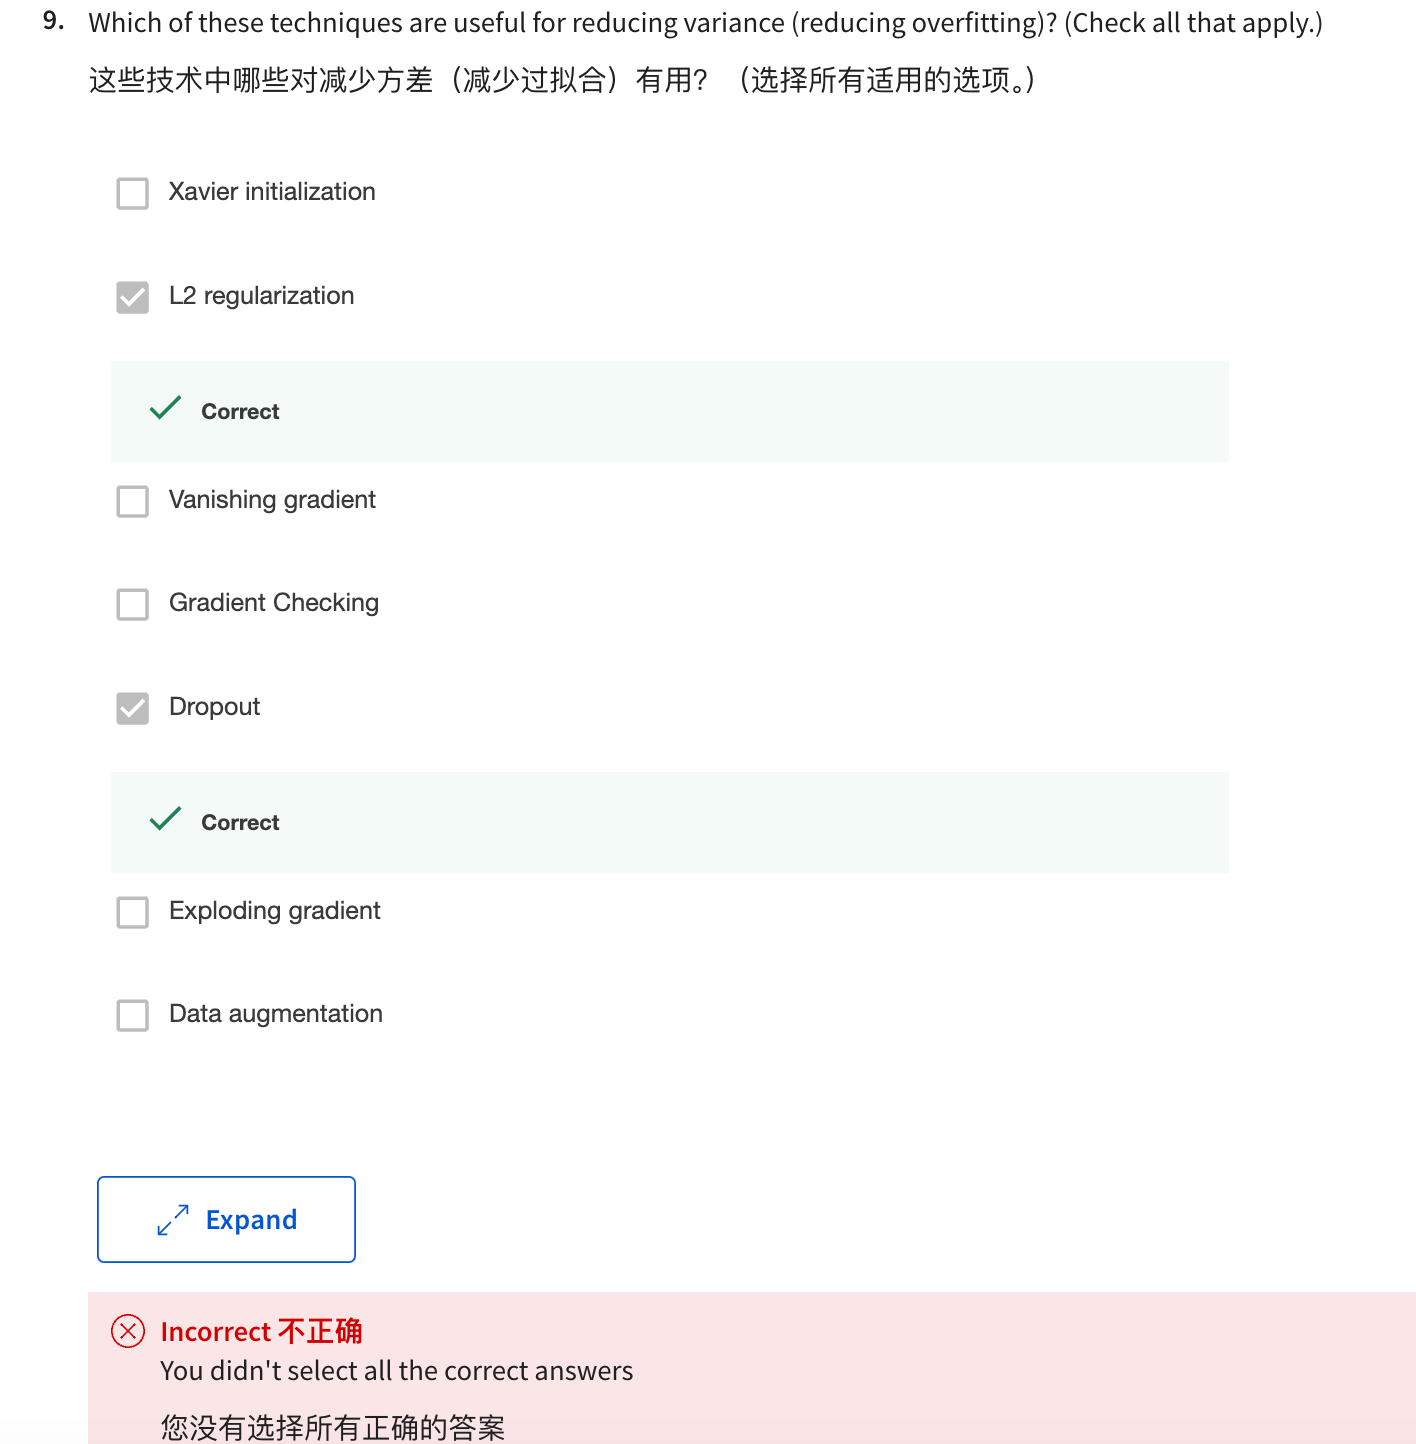
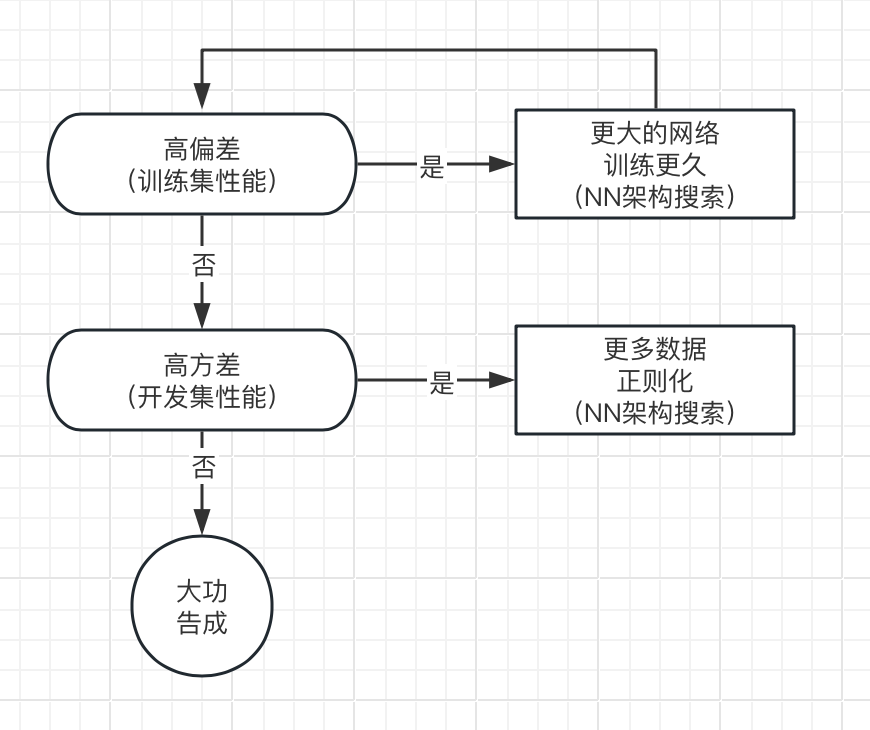
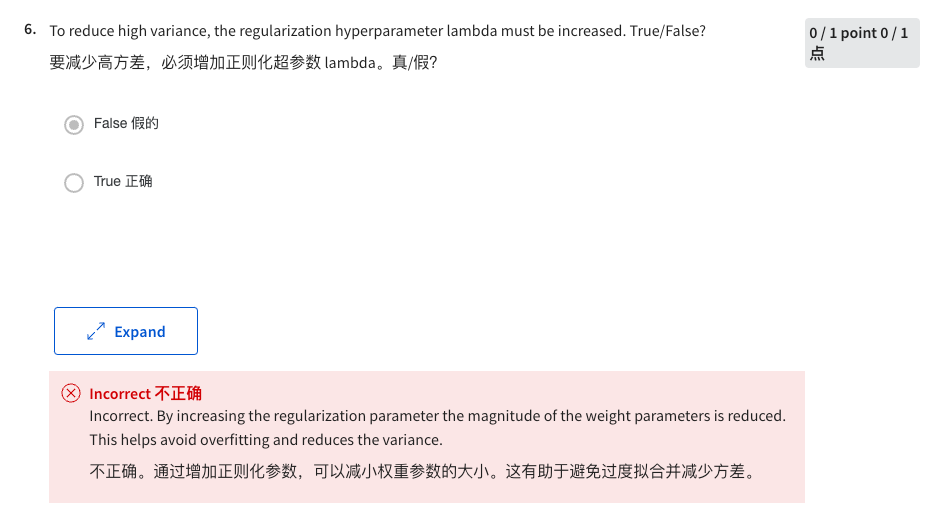
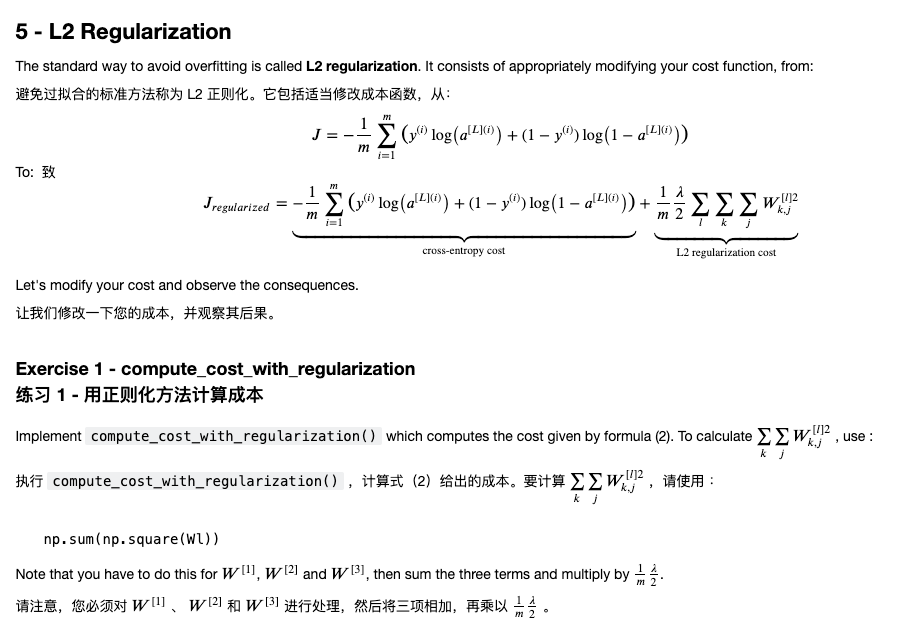
以下技术对减少方差(减少过拟合)有用:
- L2 regularization(L2 正则化):L2 正则化通过在损失函数中添加权重的平方和项,鼓励模型的权重保持较小,从而减少过拟合。
- Dropout(丢弃法):Dropout 是一种正则化技术,通过在训练过程中随机丢弃一部分神经元,防止模型过拟合。
- Data augmentation(数据增强):数据增强通过增加训练数据的多样性,使模型更泛化,从而减少过拟合。
其他选项的解释:
- Xavier initialization(Xavier 初始化):主要用于解决深度网络的权重初始化问题,帮助梯度更好地传播,但不直接用于减少过拟合。
- Vanishing gradient(梯度消失):这是一个问题而不是技术。
- Gradient Checking(梯度检查):用于验证反向传播实现正确性,不用于减少过拟合。
- Exploding gradient(梯度爆炸):这是一个问题而不是技术。
综上所述,减少方差(减少过拟合)的技术包括: - L2 regularization
- Dropout
- Data augmentation
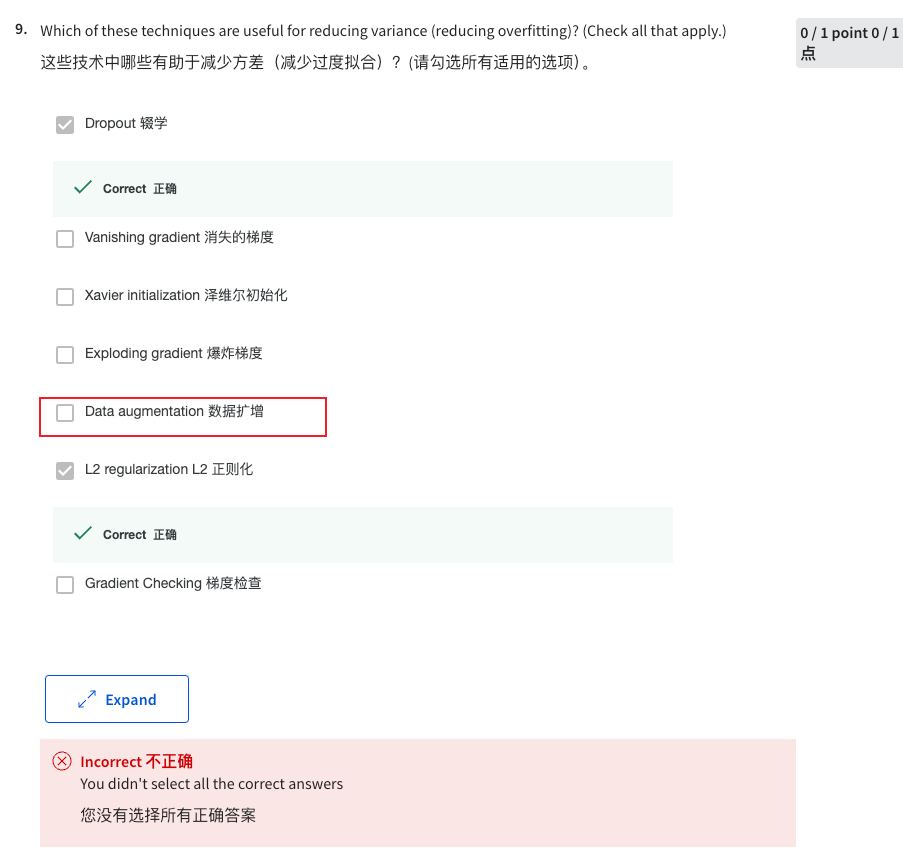
高斯变量:(随机数)
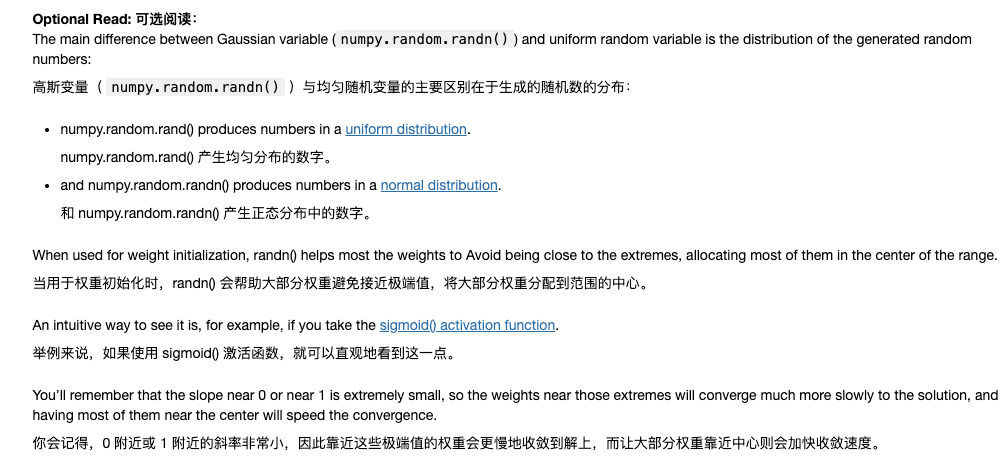
He初始化
一般选择64到512作为mini-batch的大小
这是因为计算机内存的布局和访问方式
所以把mini-batch的大小设置为2的幂数 你的代码会运行的快一些
就像64是2的6次方 2的7次方 2的8次方
2的9次方 所以一般我会把mini-batch的大小 设置成2的幂数
我在上一节中我的mini-batch大小是1000
但我建议你就使用1024
2的10次方
但是1024这个值还是比较罕见的
而这些值更常用些
最后一个提醒是确保你的mini-batch
你所有的X{t} Y{t} 是可以放进你CPU/GPU 内存的
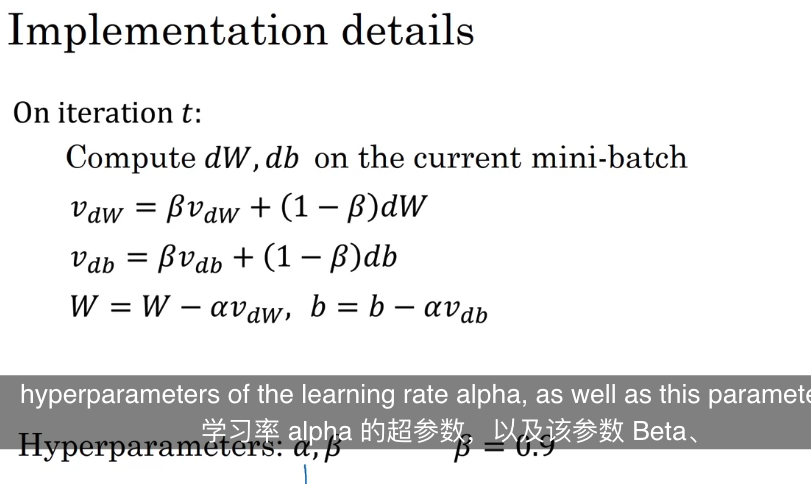
动量
beta = 0.9
实践中不纠正初始偏离
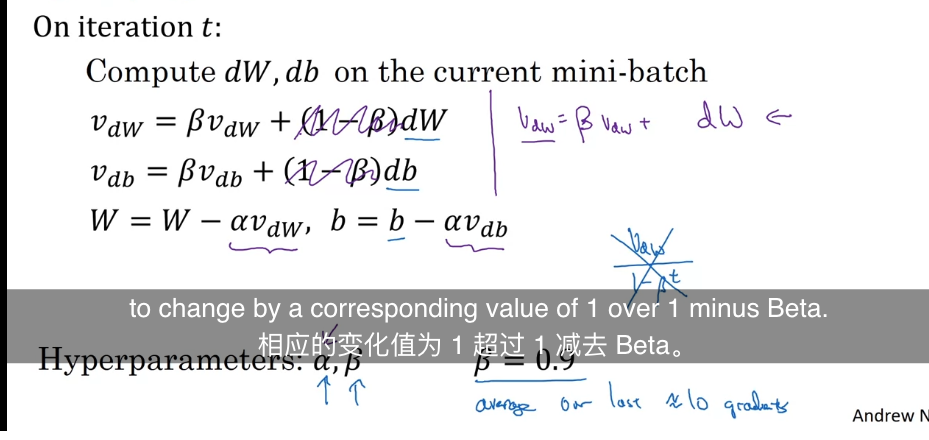
(不建议省略1-beta,但都可以选择)
均方根推进
📄 C2_W2.pdf
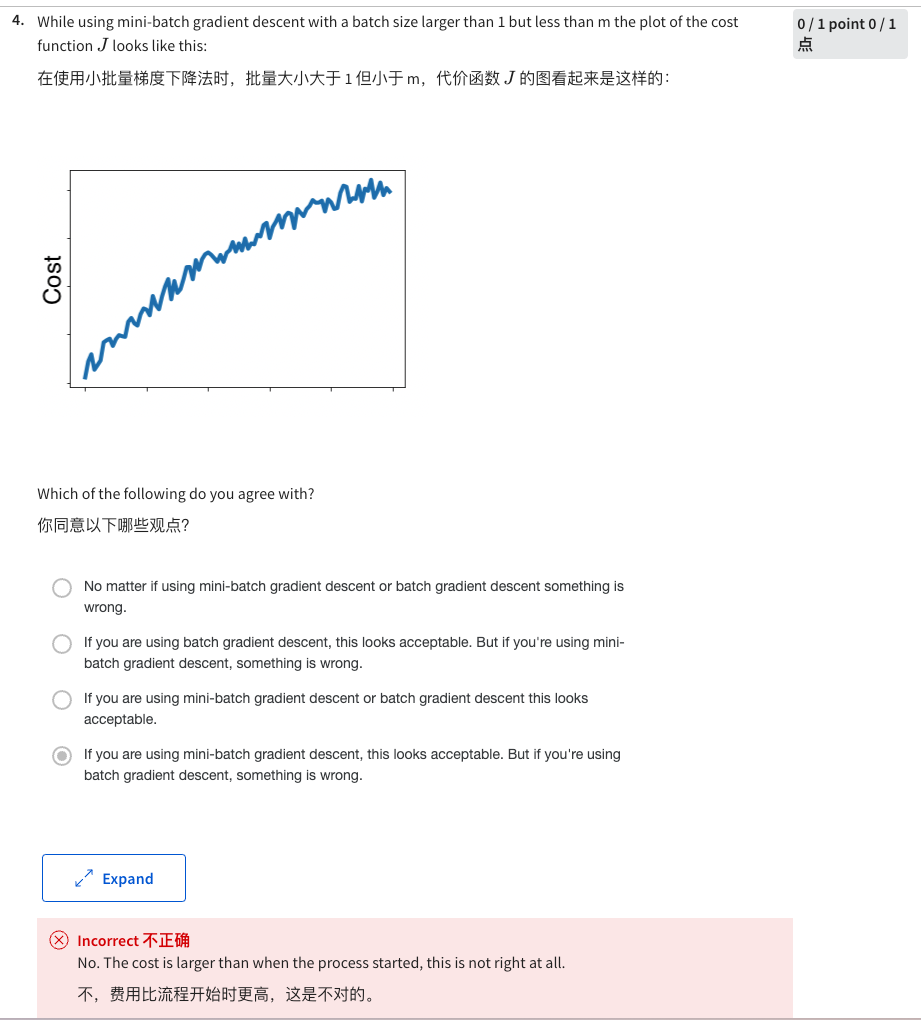
在递增而非下降
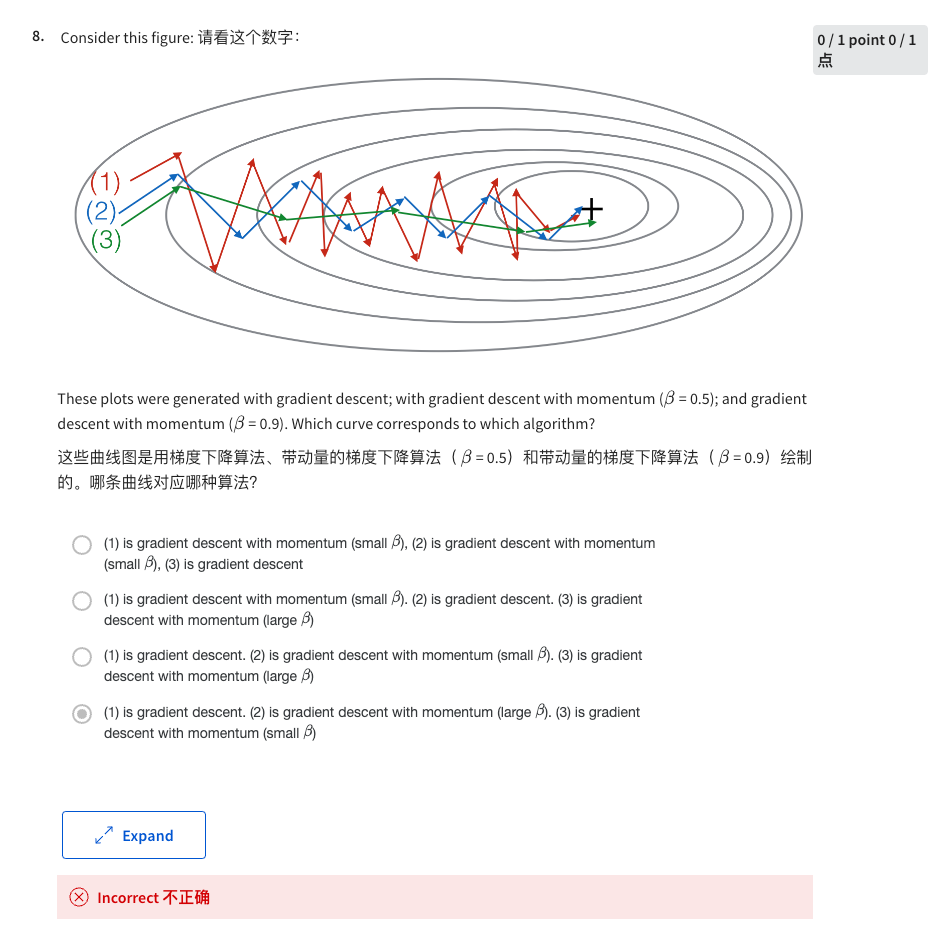
beta越大,相当于对前面更多的数字(梯度,例如前面50天的天气)取样
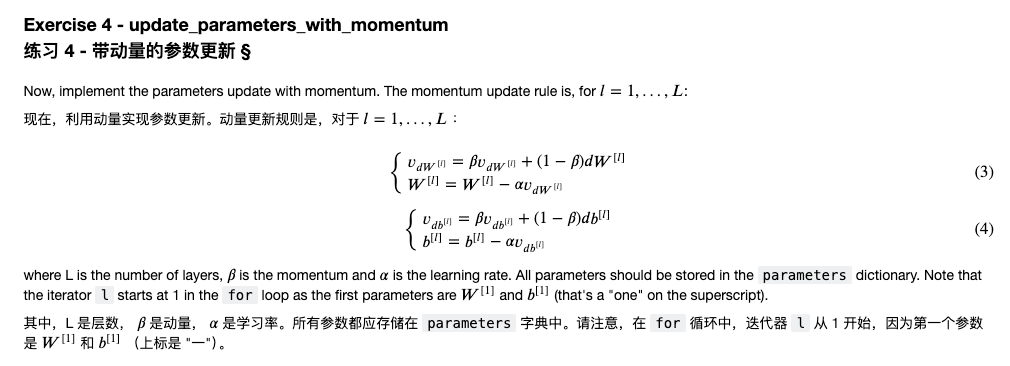
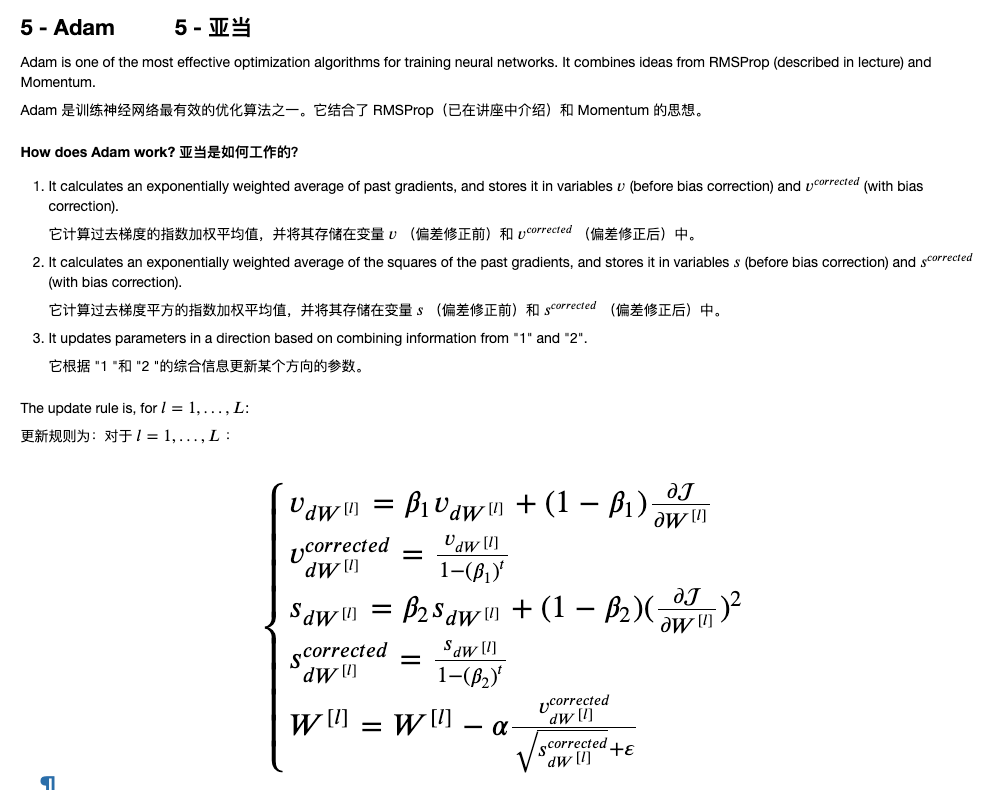
超参数
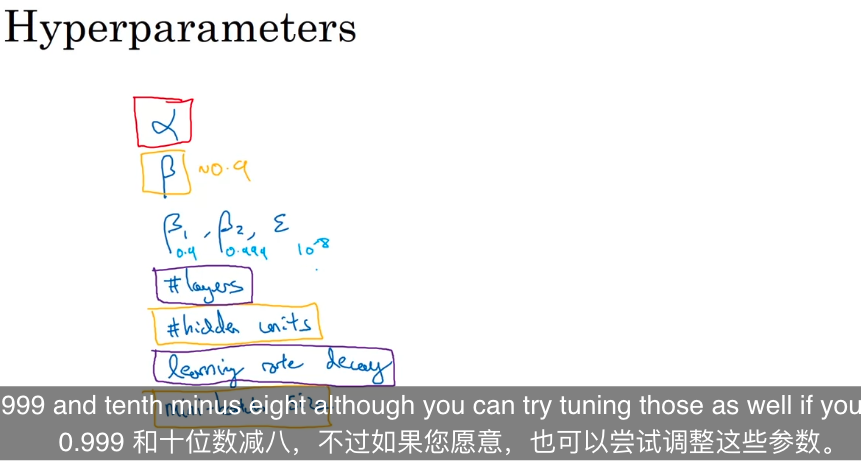
学习率、动量、隐藏单元、小批量大小
层数、学习率衰减
框架
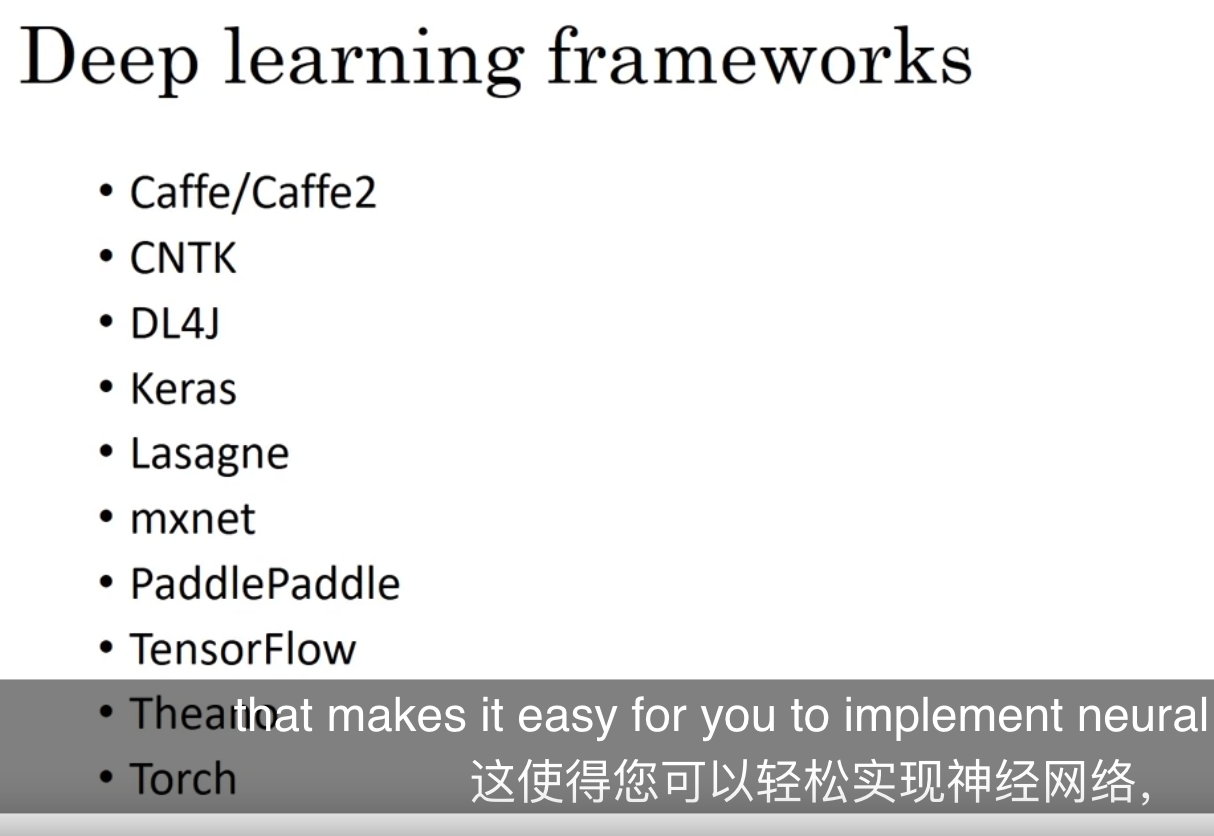
截至2024年,最流行的深度学习框架主要有以下几个:
- PyTorch
- PyTorch近年来在学术界和工业界都非常受欢迎,得益于其动态计算图和灵活易用的接口。
- 在研究社区中有很强的影响力,并且许多新发布的深度学习模型和论文都采用了PyTorch。
- TensorFlow
- TensorFlow仍然是一个非常重要和广泛使用的深度学习框架,特别是在生产部署和大规模分布式计算方面。
- 由于其丰富的生态系统(如TensorFlow Lite、TensorFlow Extended)和广泛的企业支持,TensorFlow在实际应用中占有重要地位。
- Keras
- 虽然Keras现在是TensorFlow的一部分,但其简洁和高效的API仍然吸引了大量开发者。
- 对于快速原型开发和实验非常有用。
- Hugging Face Transformers
- 虽然不是一个传统意义上的框架,但Hugging Face的Transformers库在自然语言处理(NLP)领域极为流行。
- 提供了大量预训练的模型和简化的接口,使得开发和应用NLP模型变得更加容易。
- JAX
- JAX由Google开发,是一个相对较新的框架,以其高效的自动微分和与NumPy兼容的接口受到关注。
- 在研究领域特别是对机器学习算法的研究和优化中得到了越来越多的应用。
这些框架各有其优势,选择合适的框架取决于具体的应用场景和需求。
📄 C2_W3.pdf
  X = tf.constant(np.random.randn(3,1), name = "X")
    W = tf.constant(np.random.randn(4,3), name = "W")
    b = tf.constant(np.random.randn(4,1), name = "b")
    Y = tf.add(tf.matmul(W, X), b)

z = tf.cast(z, tf.float32)
    a = tf.keras.activations.sigmoid(z)

    one_hot = tf.reshape(tf.one_hot(label, C, axis = 0), shape = [C, ])

    W1 = tf.Variable(initializer(shape=(25, 12288)))
    b1 = tf.Variable(initializer(shape=(25, 1)))
    # b1 = tf.Variable(tf.zeros([25,1]))
    W2 = tf.Variable(initializer(shape=(12, 25)))
    b2 = tf.Variable(initializer(shape=(12, 1)))
    #b2 = tf.Variable(tf.zeros([12,1]))
    W3 = tf.Variable(initializer(shape=(6, 12)))
    b3 = tf.Variable(initializer(shape=(6, 1)))
    #b3 = tf.Variable(tf.zeros([6,1]))

Z1 = tf.add(tf.matmul(W1, X), b1)
    A1 = tf.keras.activations.relu(Z1)
    Z2 = tf.add(tf.matmul(W2, A1), b2)
    A2 = tf.keras.activations.relu(Z2)
    Z3 = tf.add(tf.matmul(W3, A2), b3)

    total_loss = tf.keras.losses.categorical_crossentropy(labels, logits, from_logits=True)