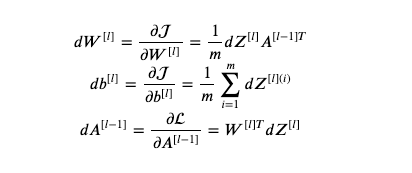课程笔记
Course Notes课程笔记
神经网络课程
ReLU函数
线性整流函数 Rectified Linear Unite
(0, y)
全连接输入层
监督学习
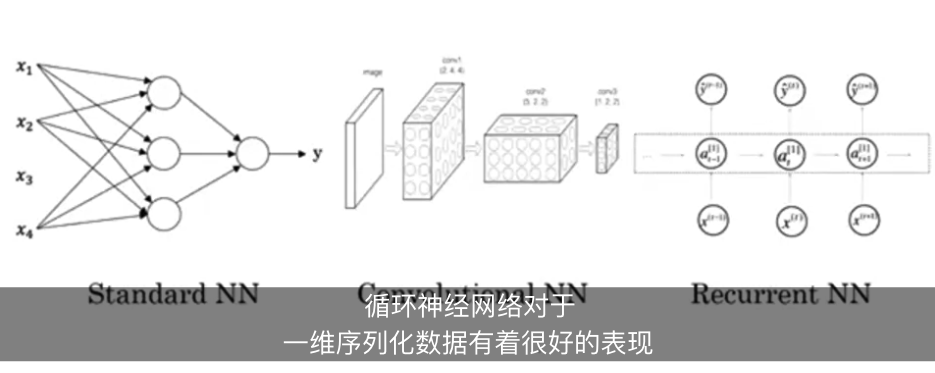
不同领域不同神经网络
标准网络结构
image(CNN)卷积
时序数据(一维时序,RNN循环神经网络
language RNNs
车辆 custom complex
数据结构化、非结构化
支持向量机或逻辑回归等无法利用大数据
NN能随着数据规模提高性能
labeled data
m(训练规模)
sigmoid梯度下降
ReLU修正线性单元
深度学习教父
玻尔兹曼机是一种随机神经网络,也是一种可以用来学习概率分布的生成模型。它由奥地利物理学家路德维希·玻尔兹曼的统计力学理论启发而来。玻尔兹曼机器的特点是通过一个称为“热力学模拟”的过程来更新其状态,该过程通过模拟退火技术来逐步找到系统的能量最低状态。
玻尔兹曼机器主要由两种类型的单元组成:可见单元和隐藏单元。可见单元对应于模型的输入数据,而隐藏单元则帮助捕捉输入数据之间的复杂关系。这些单元之间的连接可以是双向的,允许信息在单元间双向流动,这种连接通常称为“权重”。
这种机器通常用于解决具有多种可能状态的复杂问题,如模式识别、推荐系统等。由于其学习和推断过程计算成本较高,纯粹的玻尔兹曼机在现实世界应用中较少,但其衍生版本如受限玻尔兹曼机(RBM)在深度学习领域得到了广泛应用。
受限玻尔兹曼机(RBM,Restricted Boltzmann Machine)是玻尔兹曼机的一个简化版本,主要用于更高效地学习数据的概率分布。与原始的玻尔兹曼机相比,受限玻尔兹曼机具有以下特点和结构简化:双层结构:受限玻尔兹曼机包括两层神经元:可见层和隐藏层。可见层对应于输入数据,隐藏层则用于捕获数据中的特征或规律。
无内层连接:在受限玻尔兹曼机中,同一层内的神经元之间不存在连接。所有的连接都是在可见层和隐藏层之间的双向连接。这种结构限制简化了学习过程,使得模型更易于训练。
二值状态:与一些其他神经网络不同,RBM中的神经元通常采用二值状态(0或1),代表神经元的开/关状态。
训练算法:受限玻尔兹曼机通常使用一种称为对比散度(Contrastive Divergence,CD)的训练方法。这种方法是一种近似学习算法,通过少量的Gibbs采样步骤来近似梯度下降,从而更新网络的权重。
应用:受限玻尔兹曼机在特征学习、协同过滤、分类等领域有广泛的应用。例如,在深度信念网络(DBN)中,多个RBM可以层叠起来,进行无监督的逐层预训练。
RBM的这些特性使其在处理某些特定类型的问题时非常有效,尤其是在数据的内在结构复杂且难以用其他更简单的模型捕捉时。
后悔:残差网络
当然有人告诉你说这个方法不对的时候,继续做下去。
我有一个很好的原则,来帮助人们坚持他们的想法。
那就是,要么你的直觉是好的,要么不是。
如果你的直觉是对的,你应该继续做下去,最终你会成功的。
如果你的直觉是对的,你应该继续做下去,最终你会成功的。
如果你的直觉不够好,那么你做什么都无所谓了。
对其那些想研究深度学习的人来说,还有其他的建议吗?
大体上说就是,读足够的文献直到你开始产生自己的直觉。
然后,相信你的直觉,然后做下去。
即使别人都说这是无稽之谈,也不要担心。
我想,当别人说这是无稽之谈的时候,你也不会知道这是对知错,直到你继续做下去,从而发现它(是对是错)。
在人工智能的早期阶段,
人们完全相信实现智能所需要的表达方式,
无非是某种形式的符号表达式。
一种被梳理好的逻辑。通过这些逻辑你可以做非单调的事情。
这些事情不是逻辑,但像逻辑。而智能的本质则是推理。
如今,有一个完全不同的看法,
这就是,思想其实是一个表示神经活动的很大的向量。
这与一个思想是一个符号表达这个认识是不同的。
我认为那些认为思想是符号表达的人犯了一个大错误。
输入是一连串的单词,而输出也是一连串的单词。
因此,字符串显然是代表事物的方式。
所以他们认为在输入和输出之间也一定是一个字符串,或是像字符串的东西。
所以他们认为在输入和输出之间也一定是一个字符串,或是像字符串的东西。
我认为之间的东西和字符串一点都不像。
我认为这种“思想一定需要某种语言来表达“的想法 跟那些“对于空间的理解一定需要像素来表达”的想法一样愚蠢。
我认为这种“思想一定需要某种语言来表达“的想法 跟那些“对于空间的理解一定需要像素来表达”的想法一样愚蠢。
必须以像素为单位,像素进入。
如果我们有一个点阵式打印机和人脑连接起来,
然后像素就会被打印出来,但介于两者之间的并不是像素。
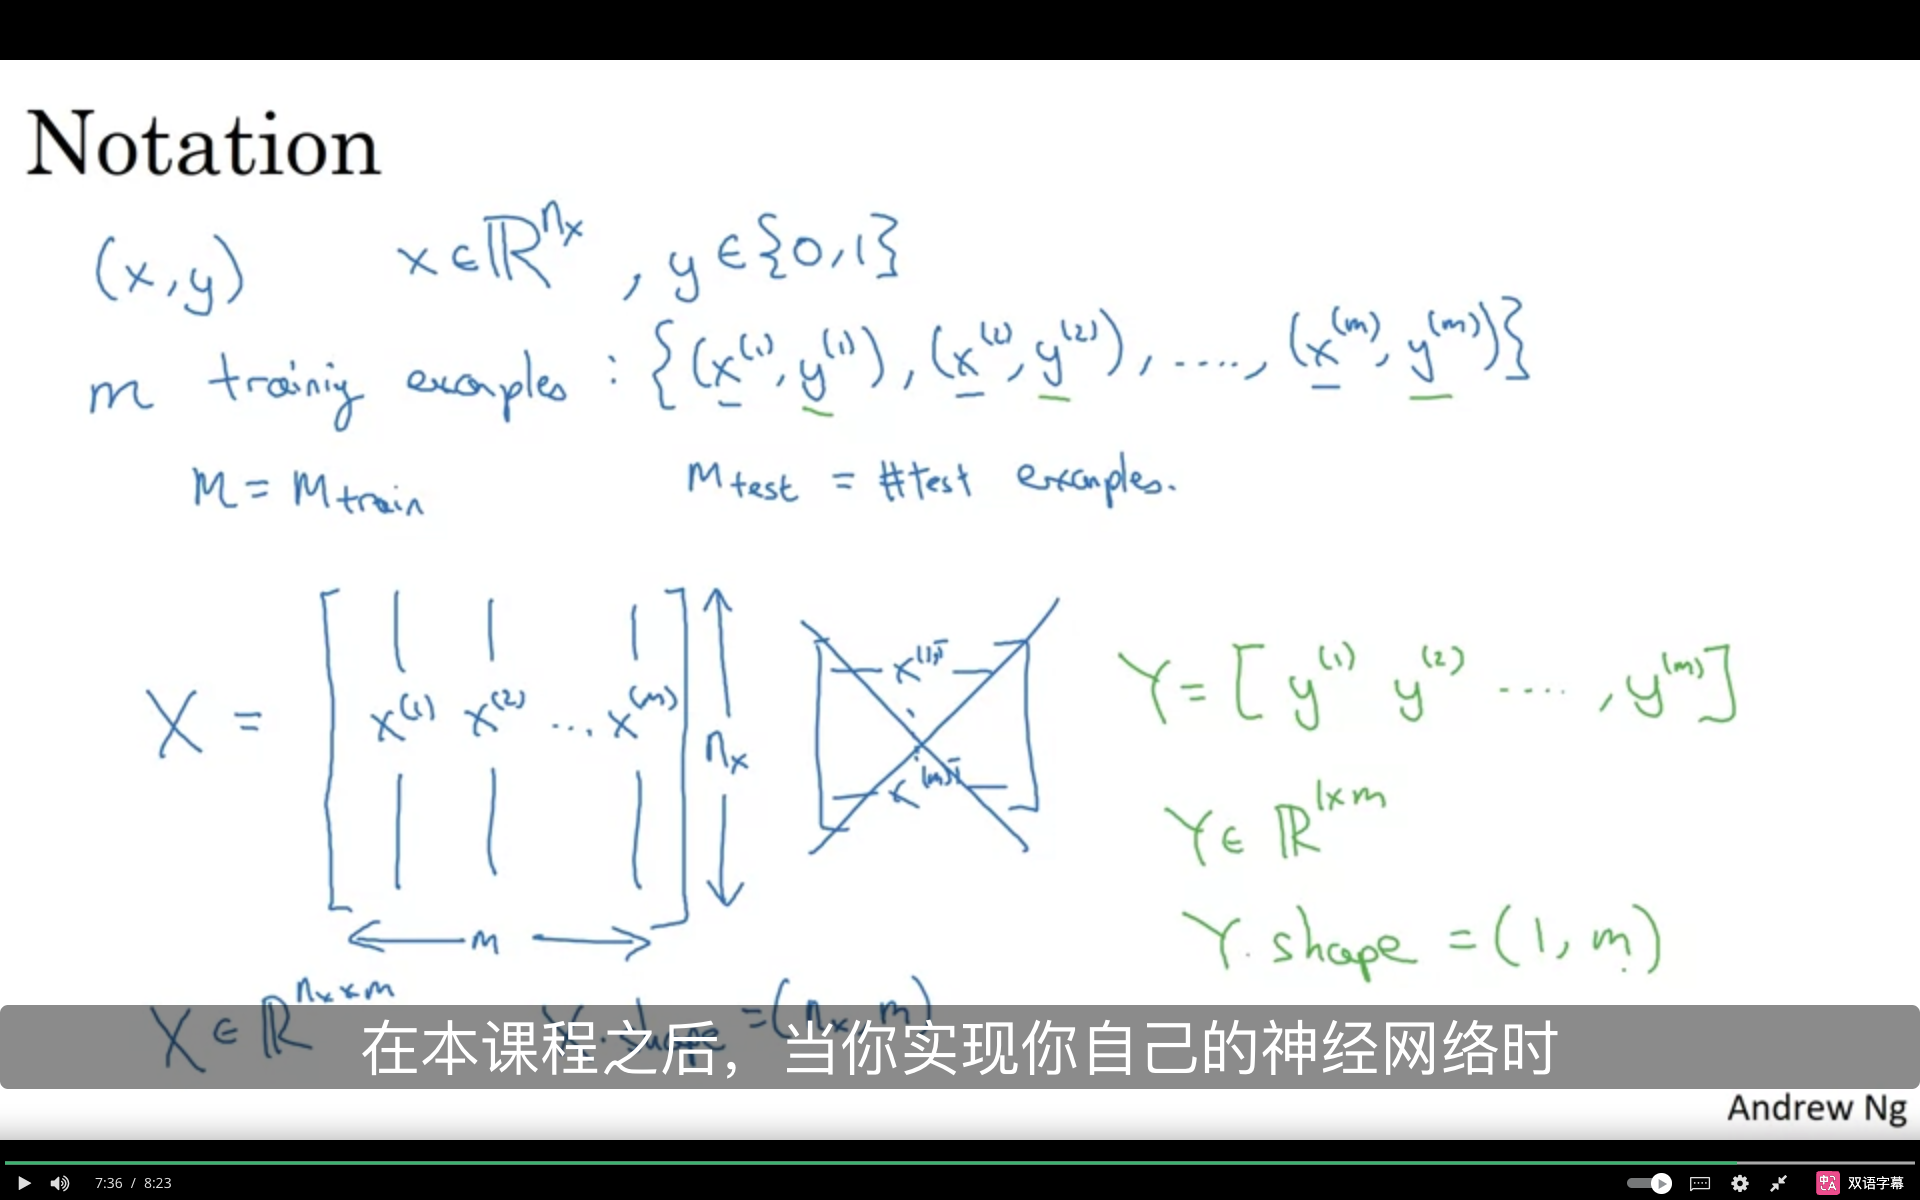
m
for
向前传播 反向传播
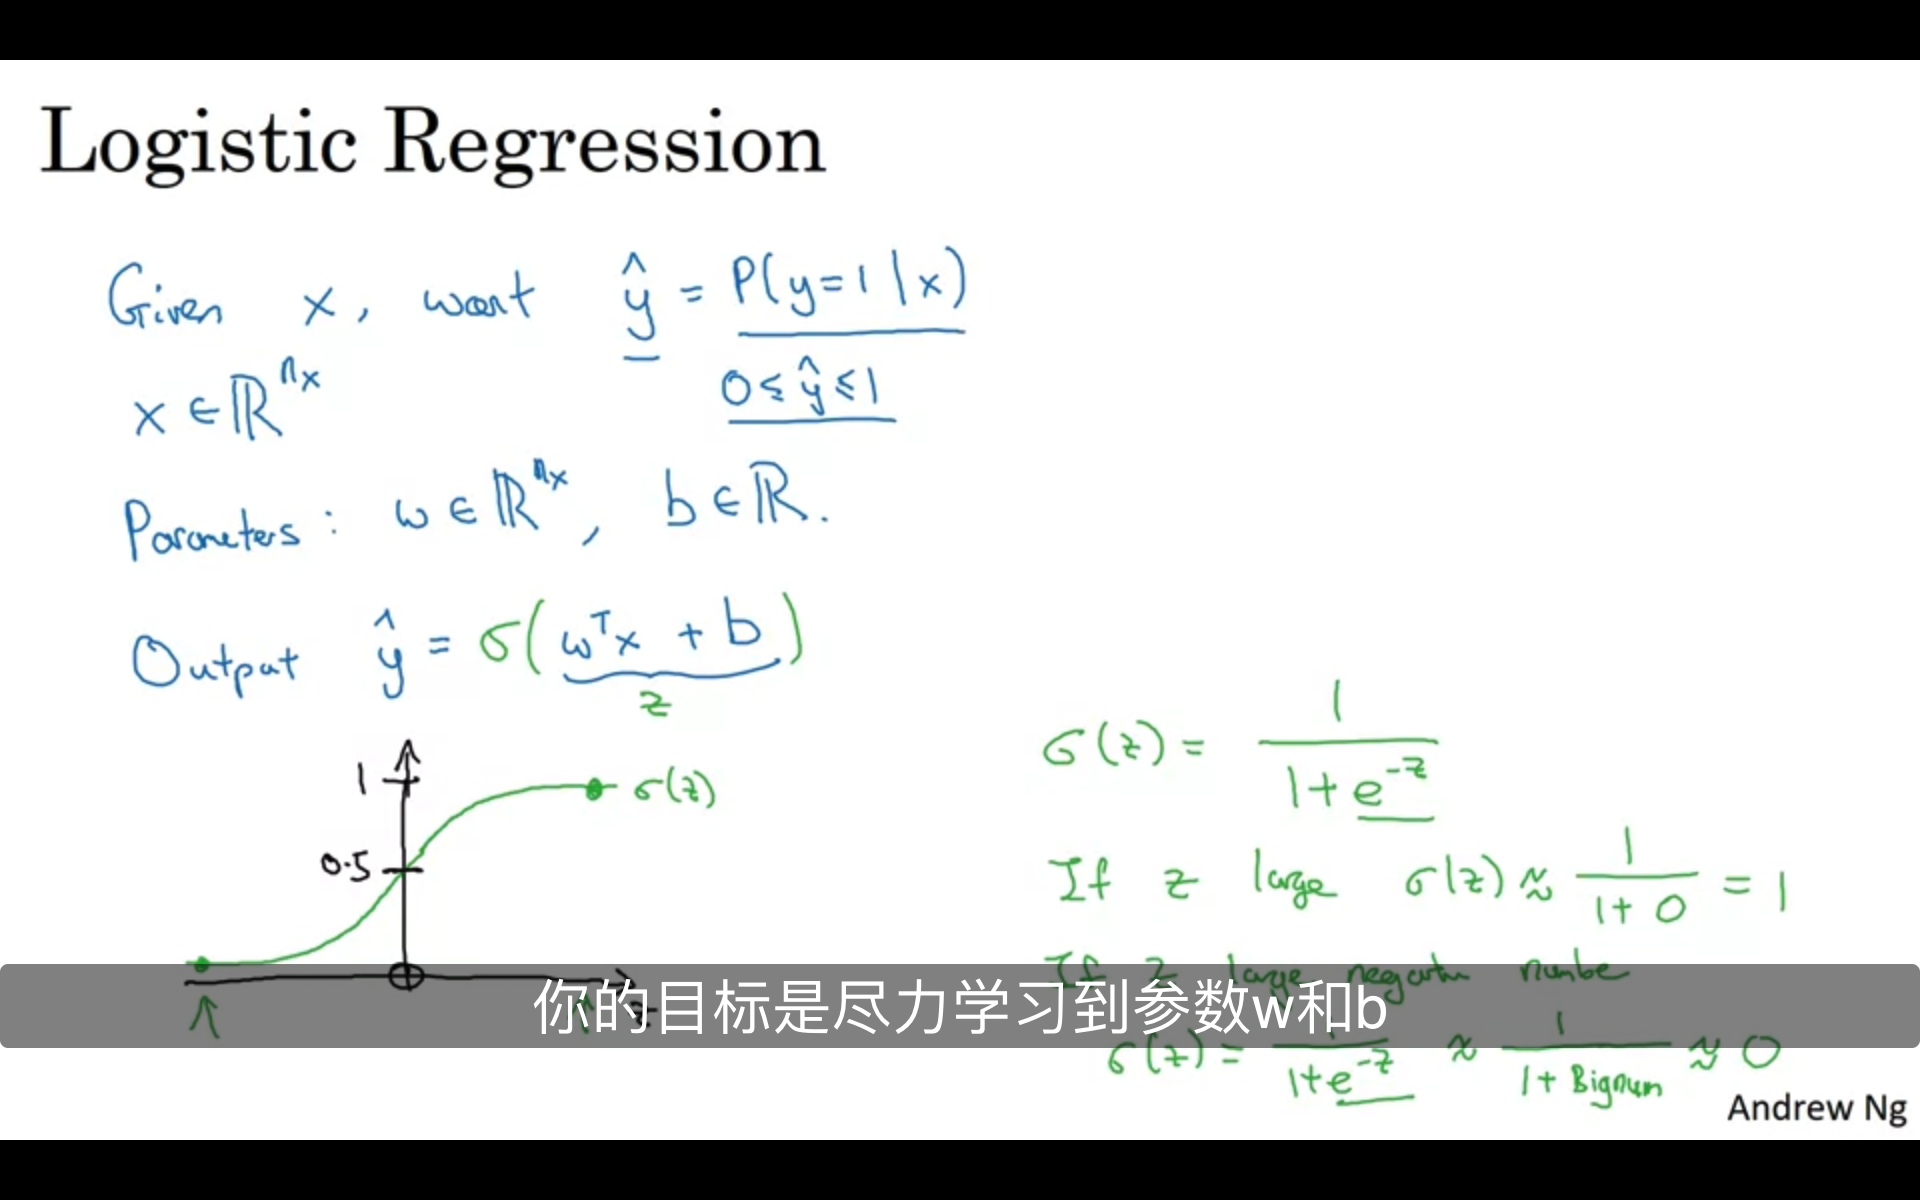
逻辑回归
二元分类问题
逻辑回归
sigmoid函数
损失函数
成本函数
导数
导数的链式法则
v = image.reshape((-1, 1))
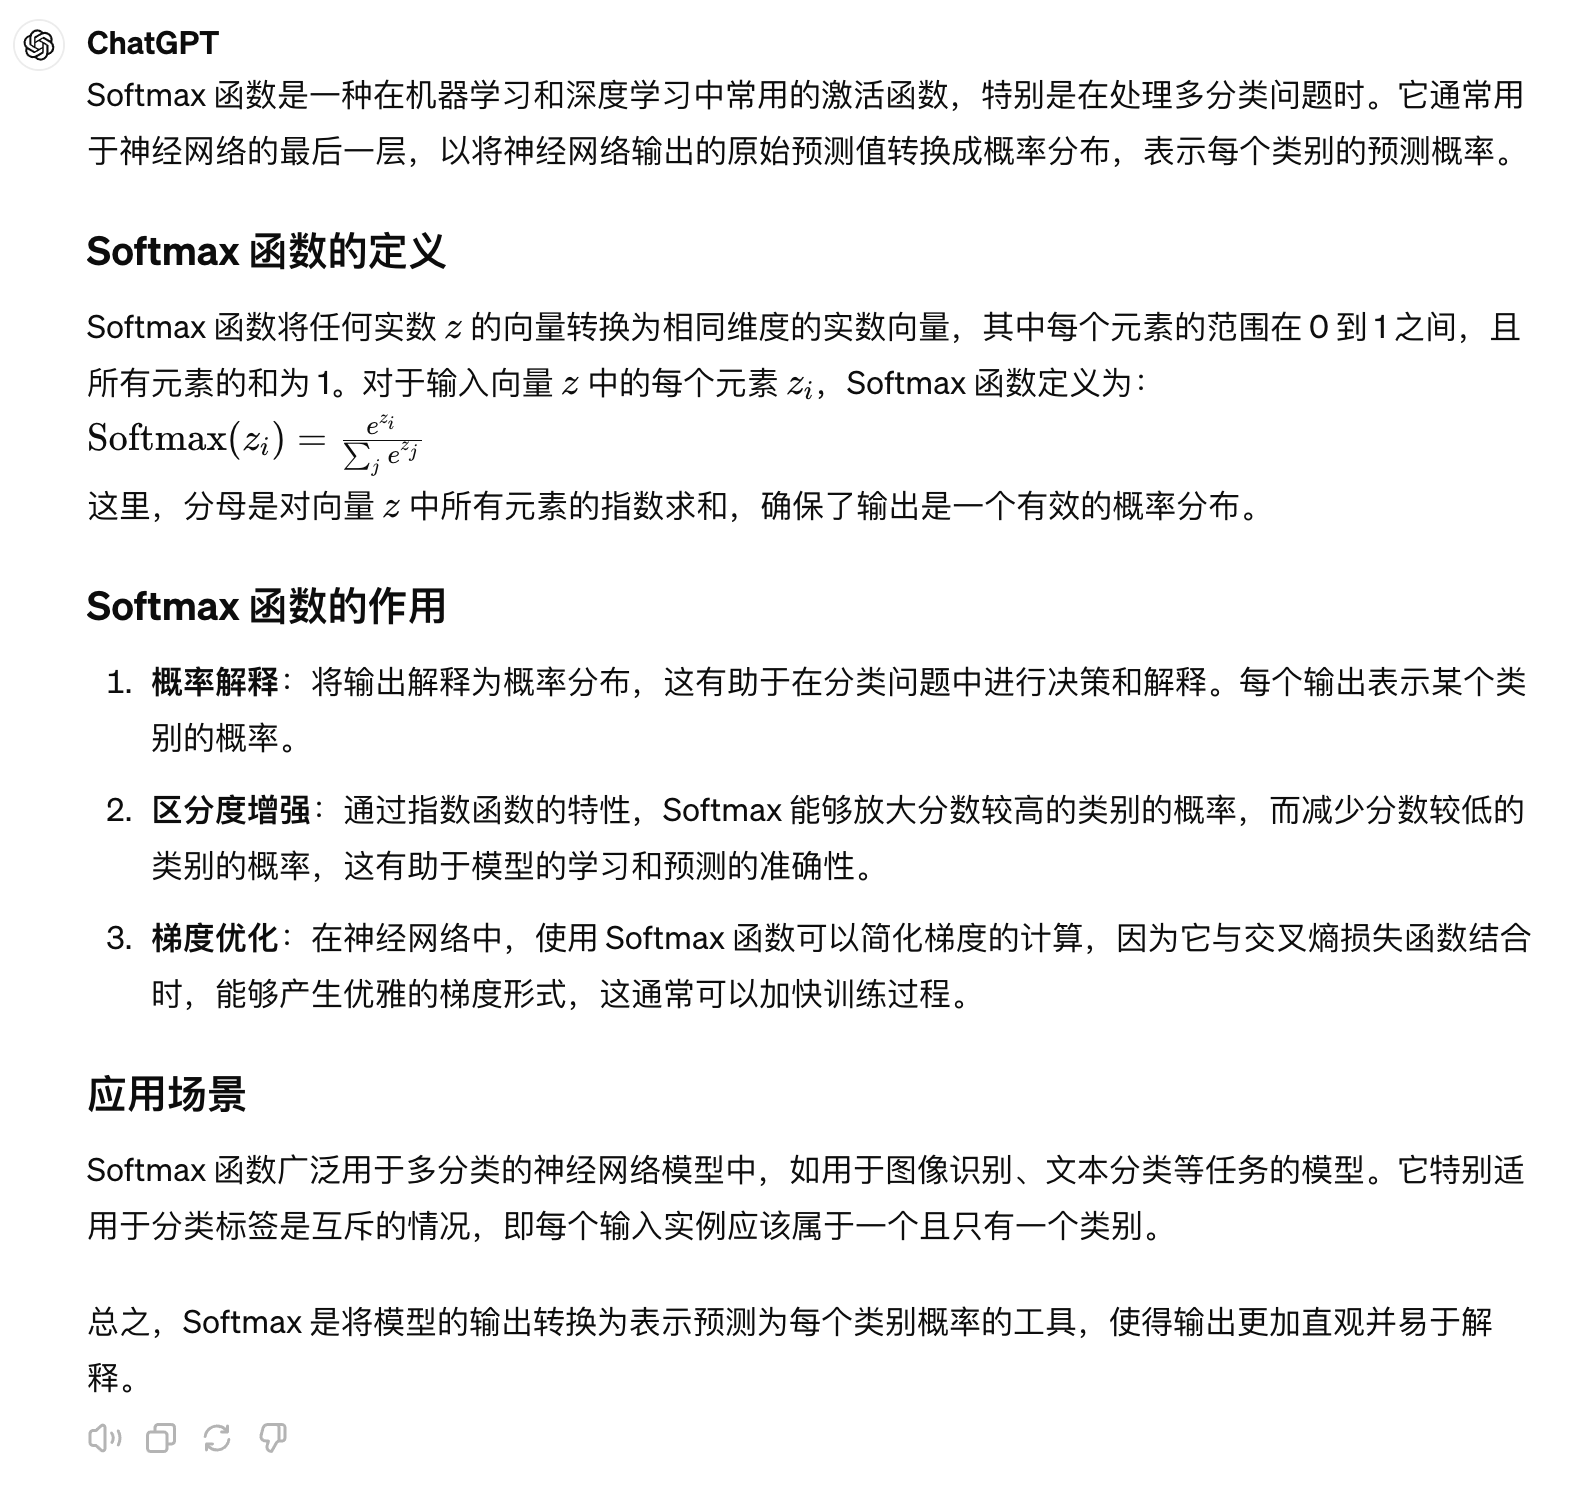
Softmax函数(激活函数)
w = np.zeros((dim,1))
    b = float(0)
w, b = initialize_with_zeros(dim)
grads, cost = propagate(w, b, X, Y)

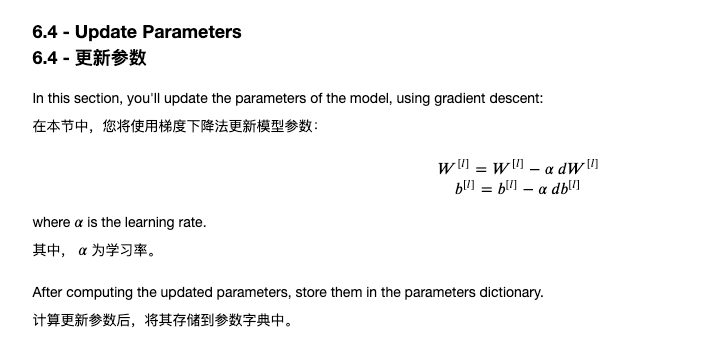
w = w - learning_rate * dw
        b = b - learning_rate * db
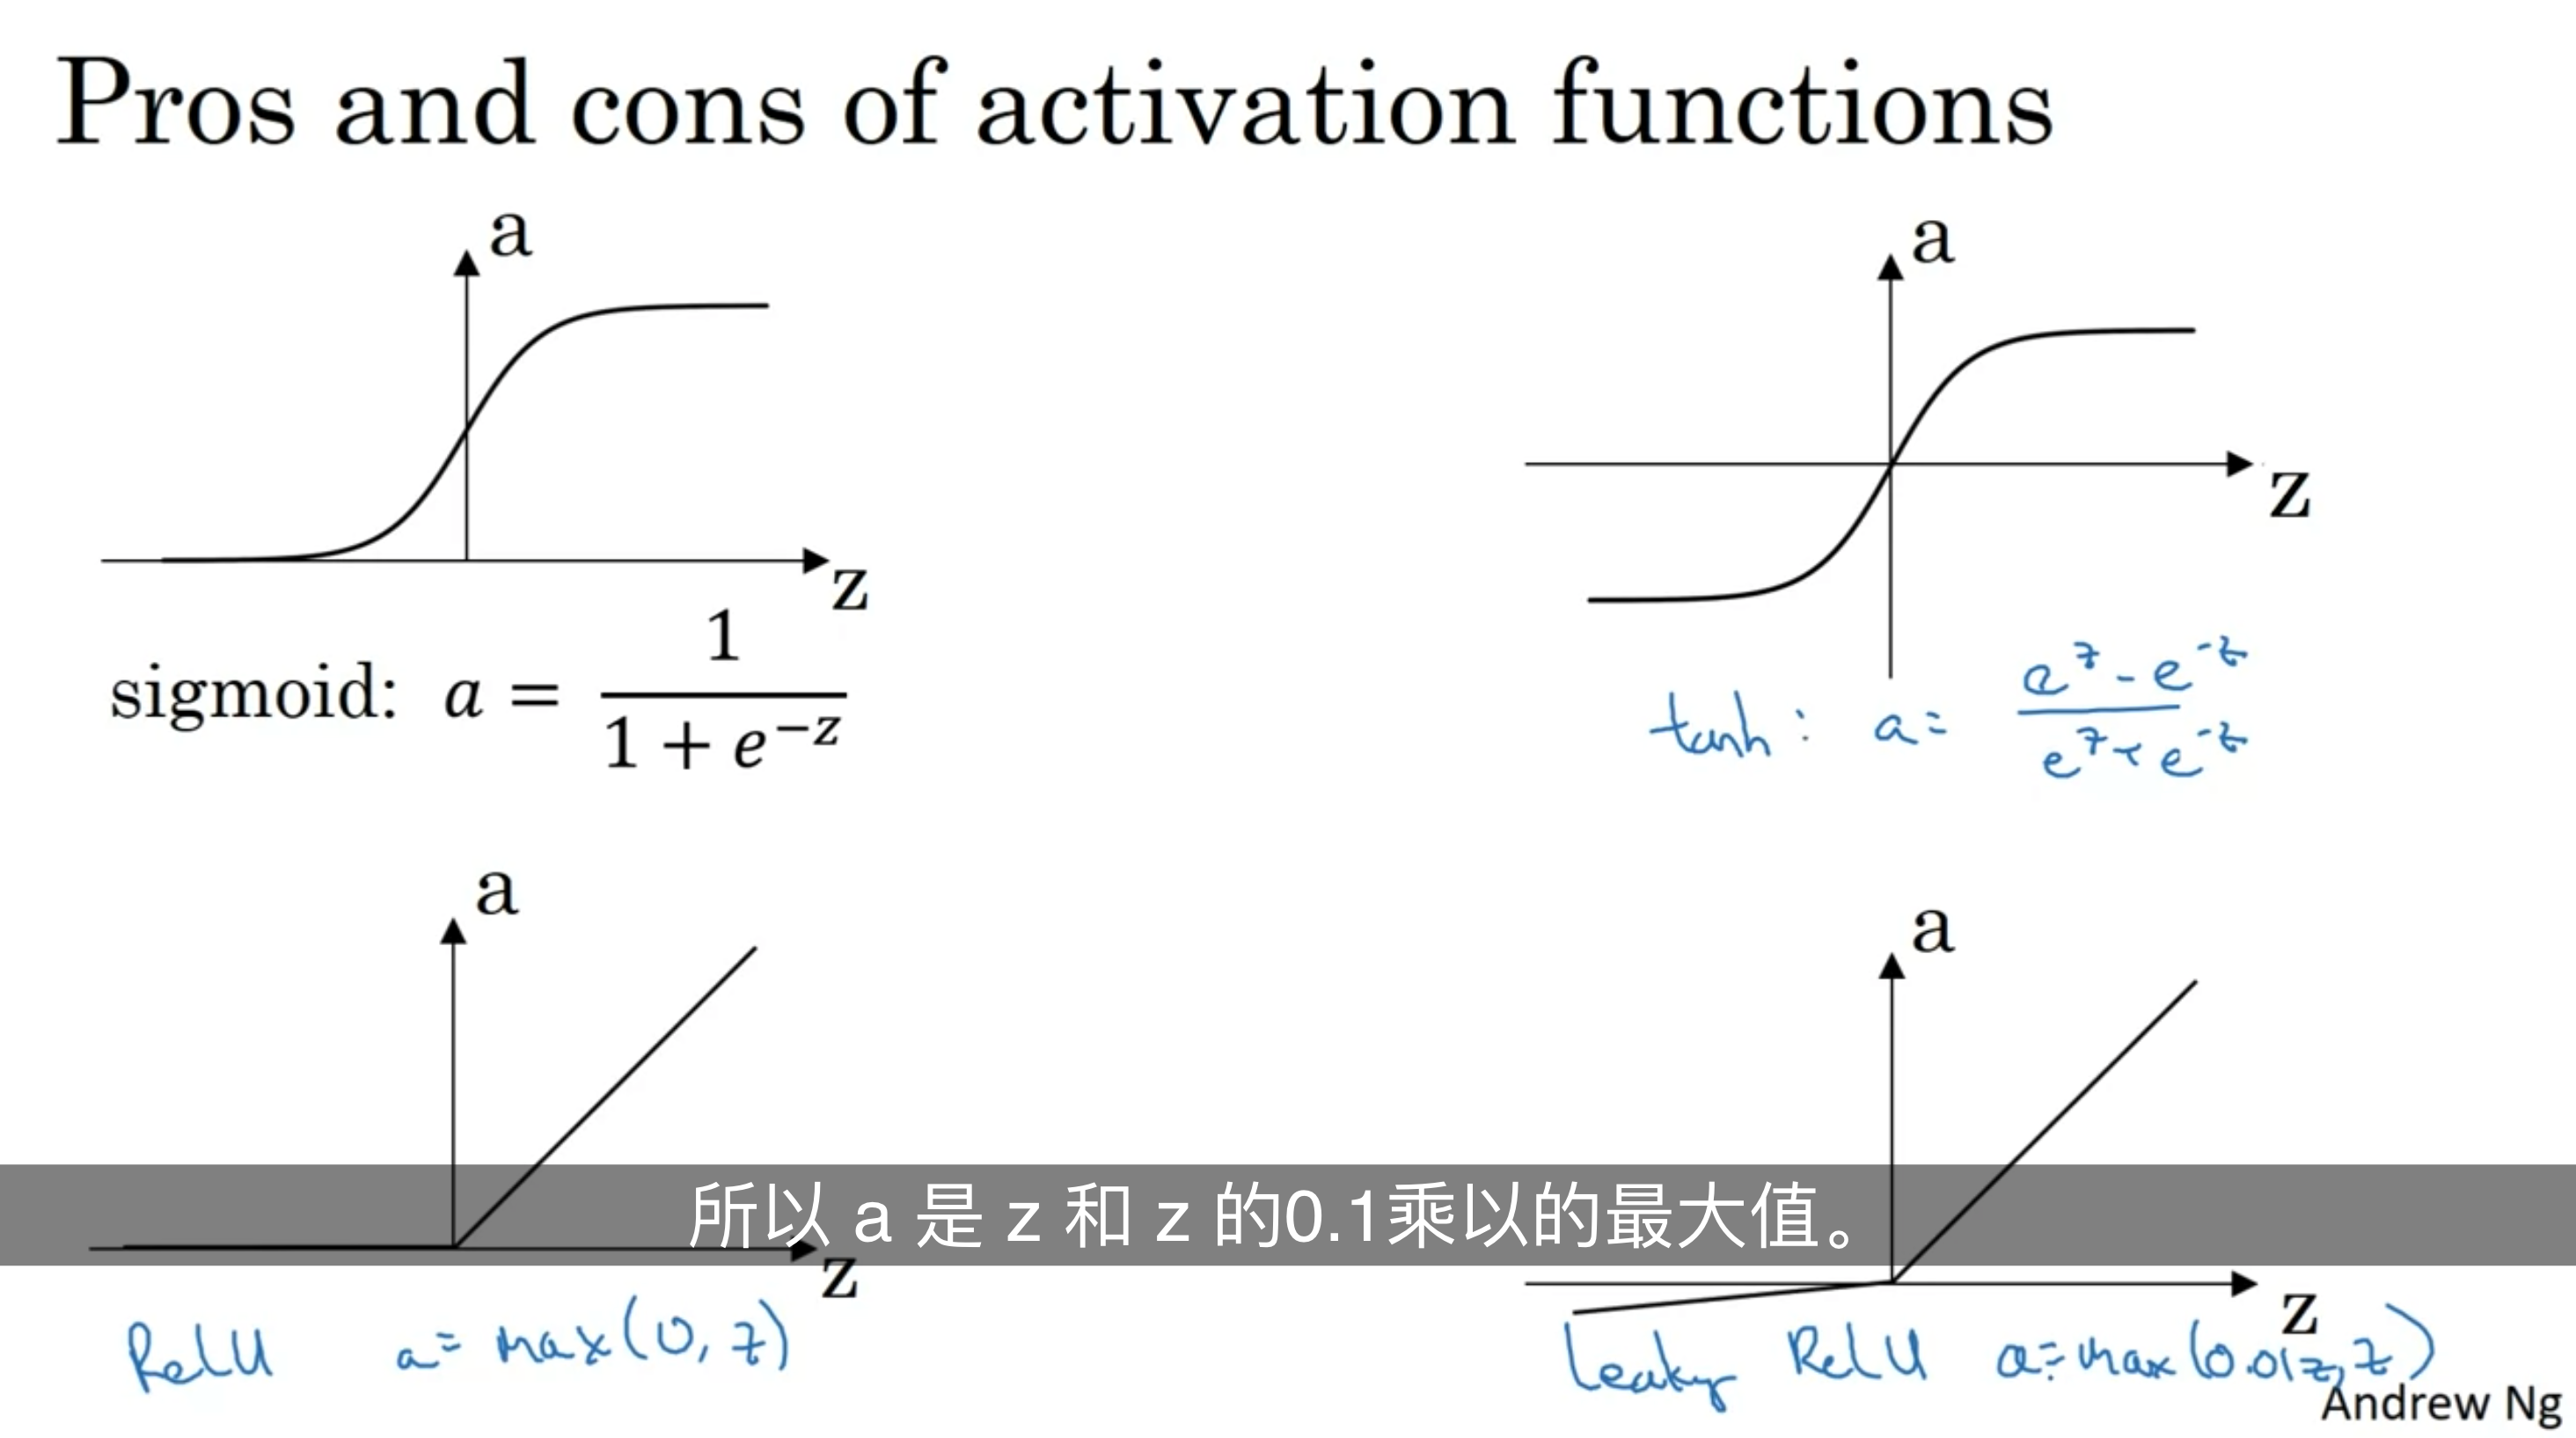
我们之后将讨论深度网络, 神经网络有许多许多层,
许多隐藏层,结果发现
如果您使用线性激活函数或者,
如果你没有使用激活函数, 那么无论你的神经有多少层
它所做的只是计算一个线性激活函数
这还不如去除所有隐藏层
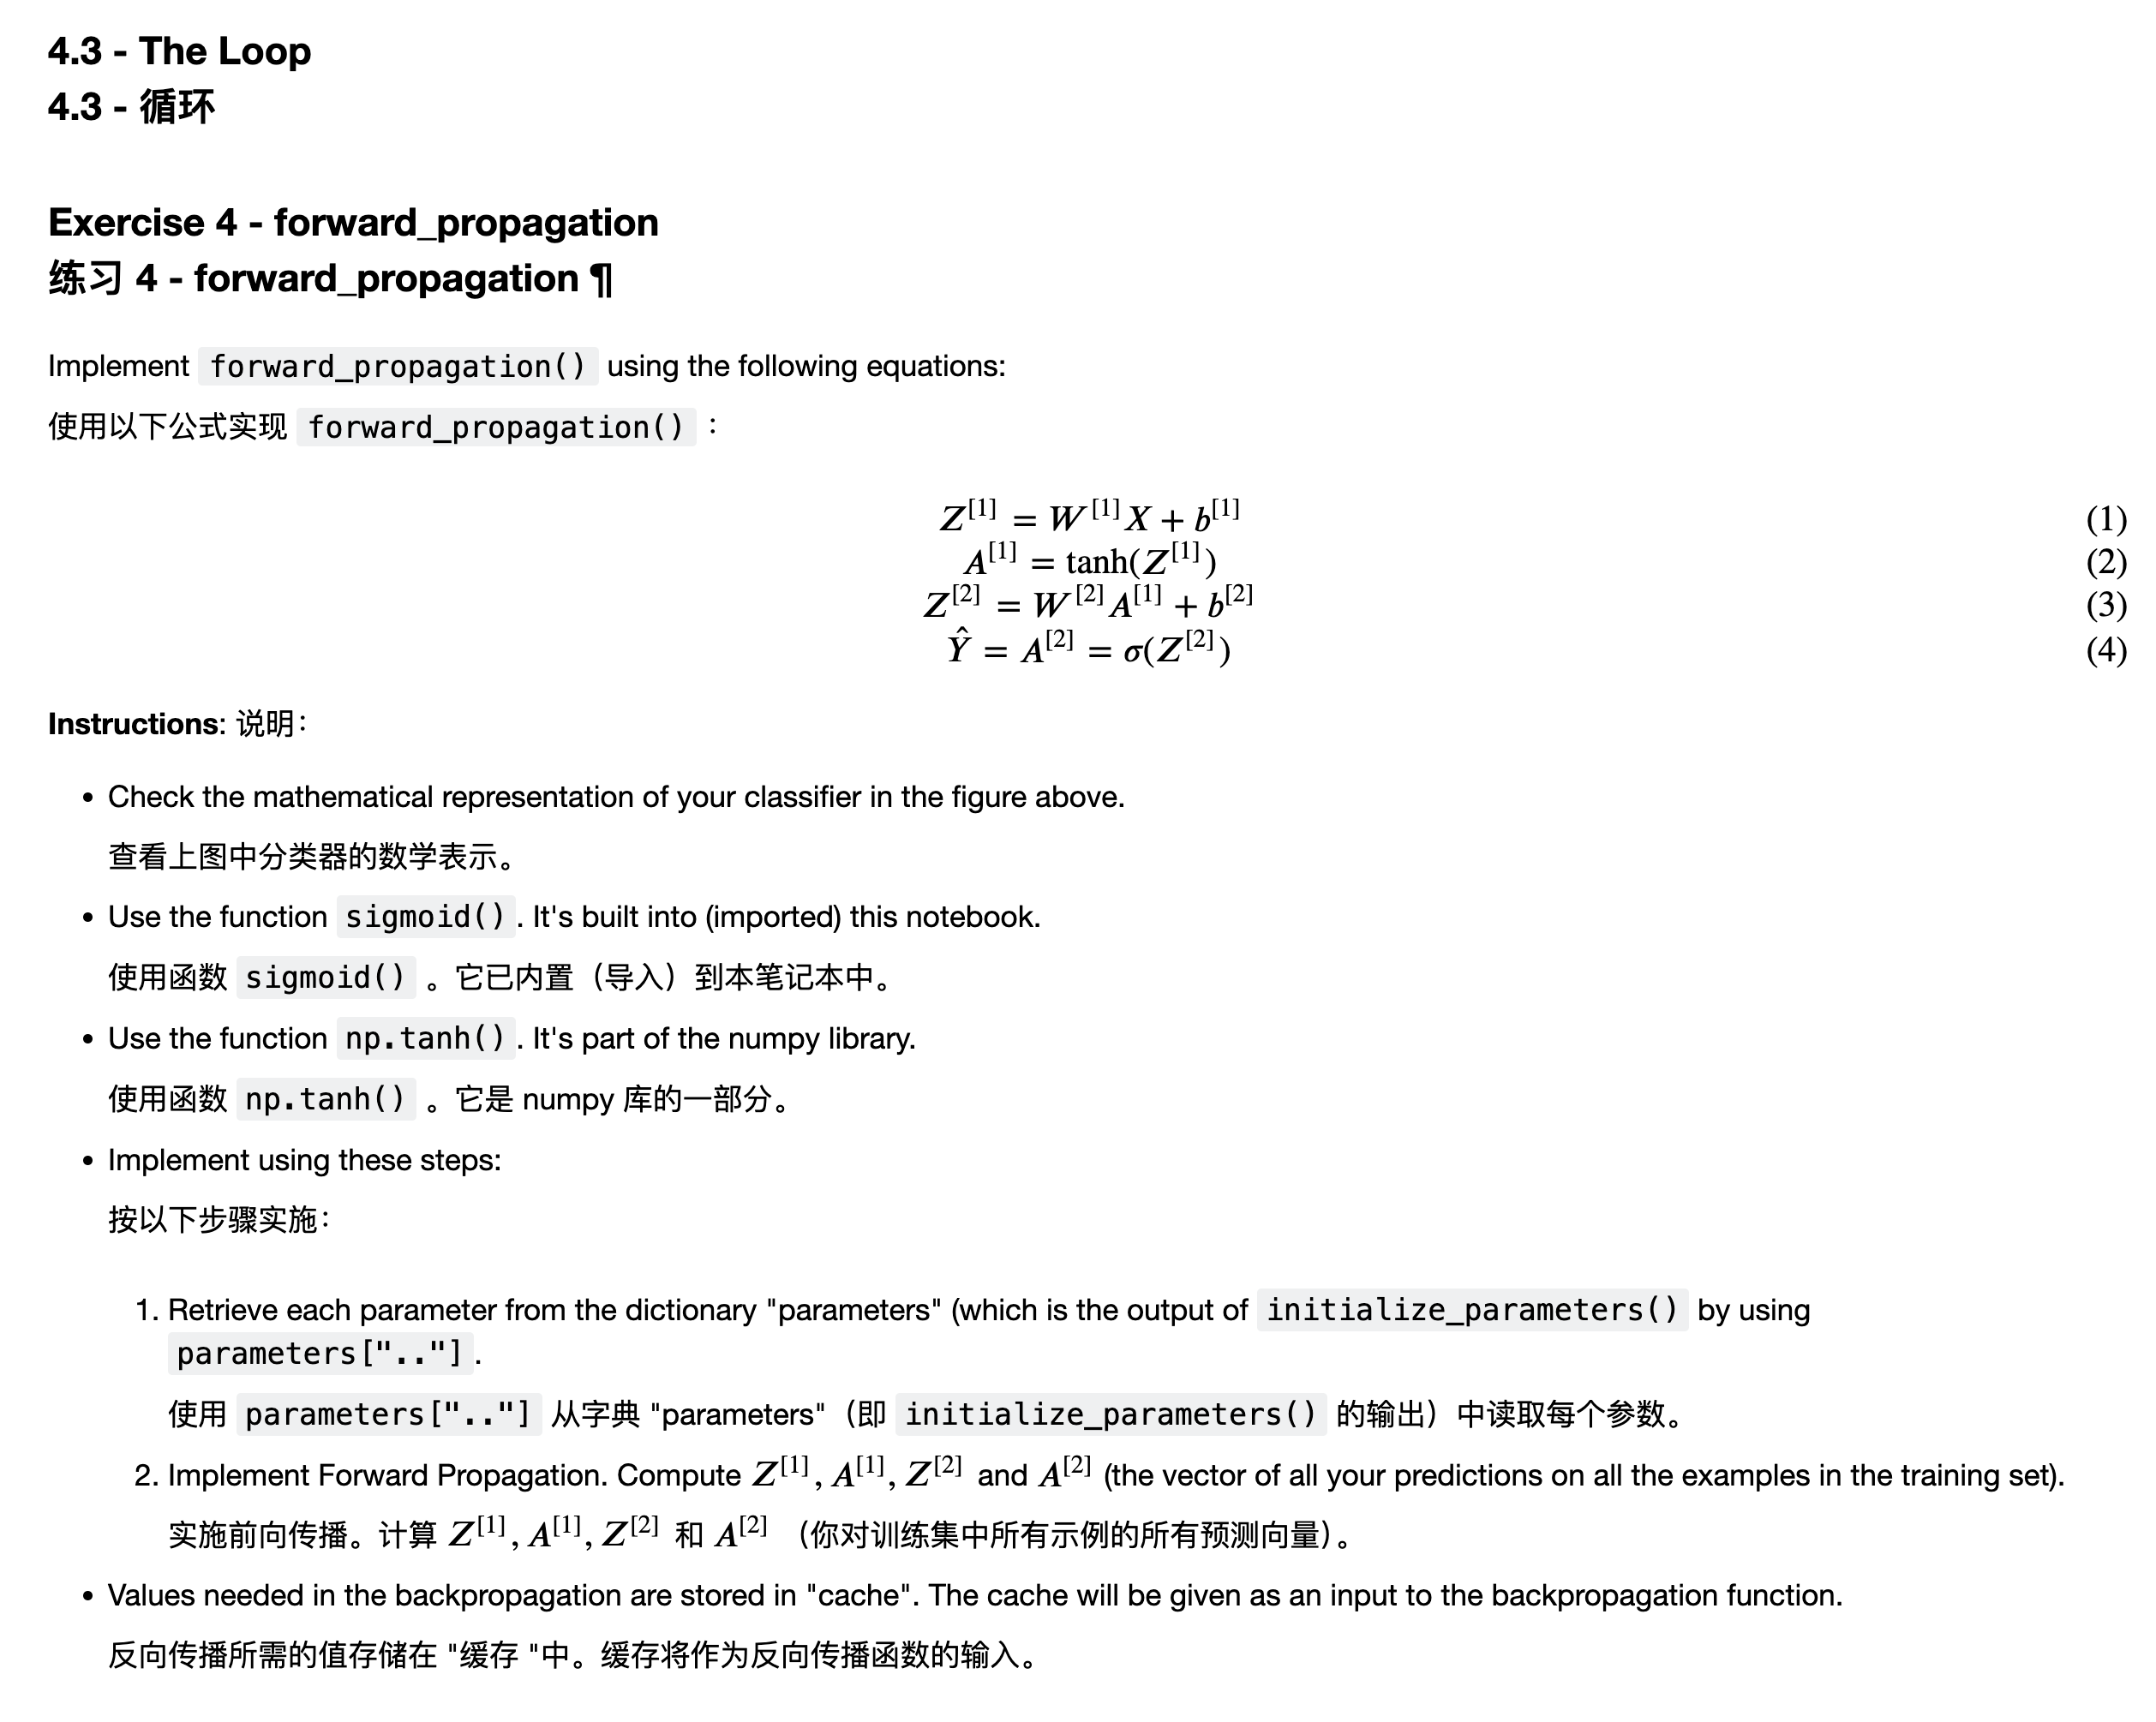
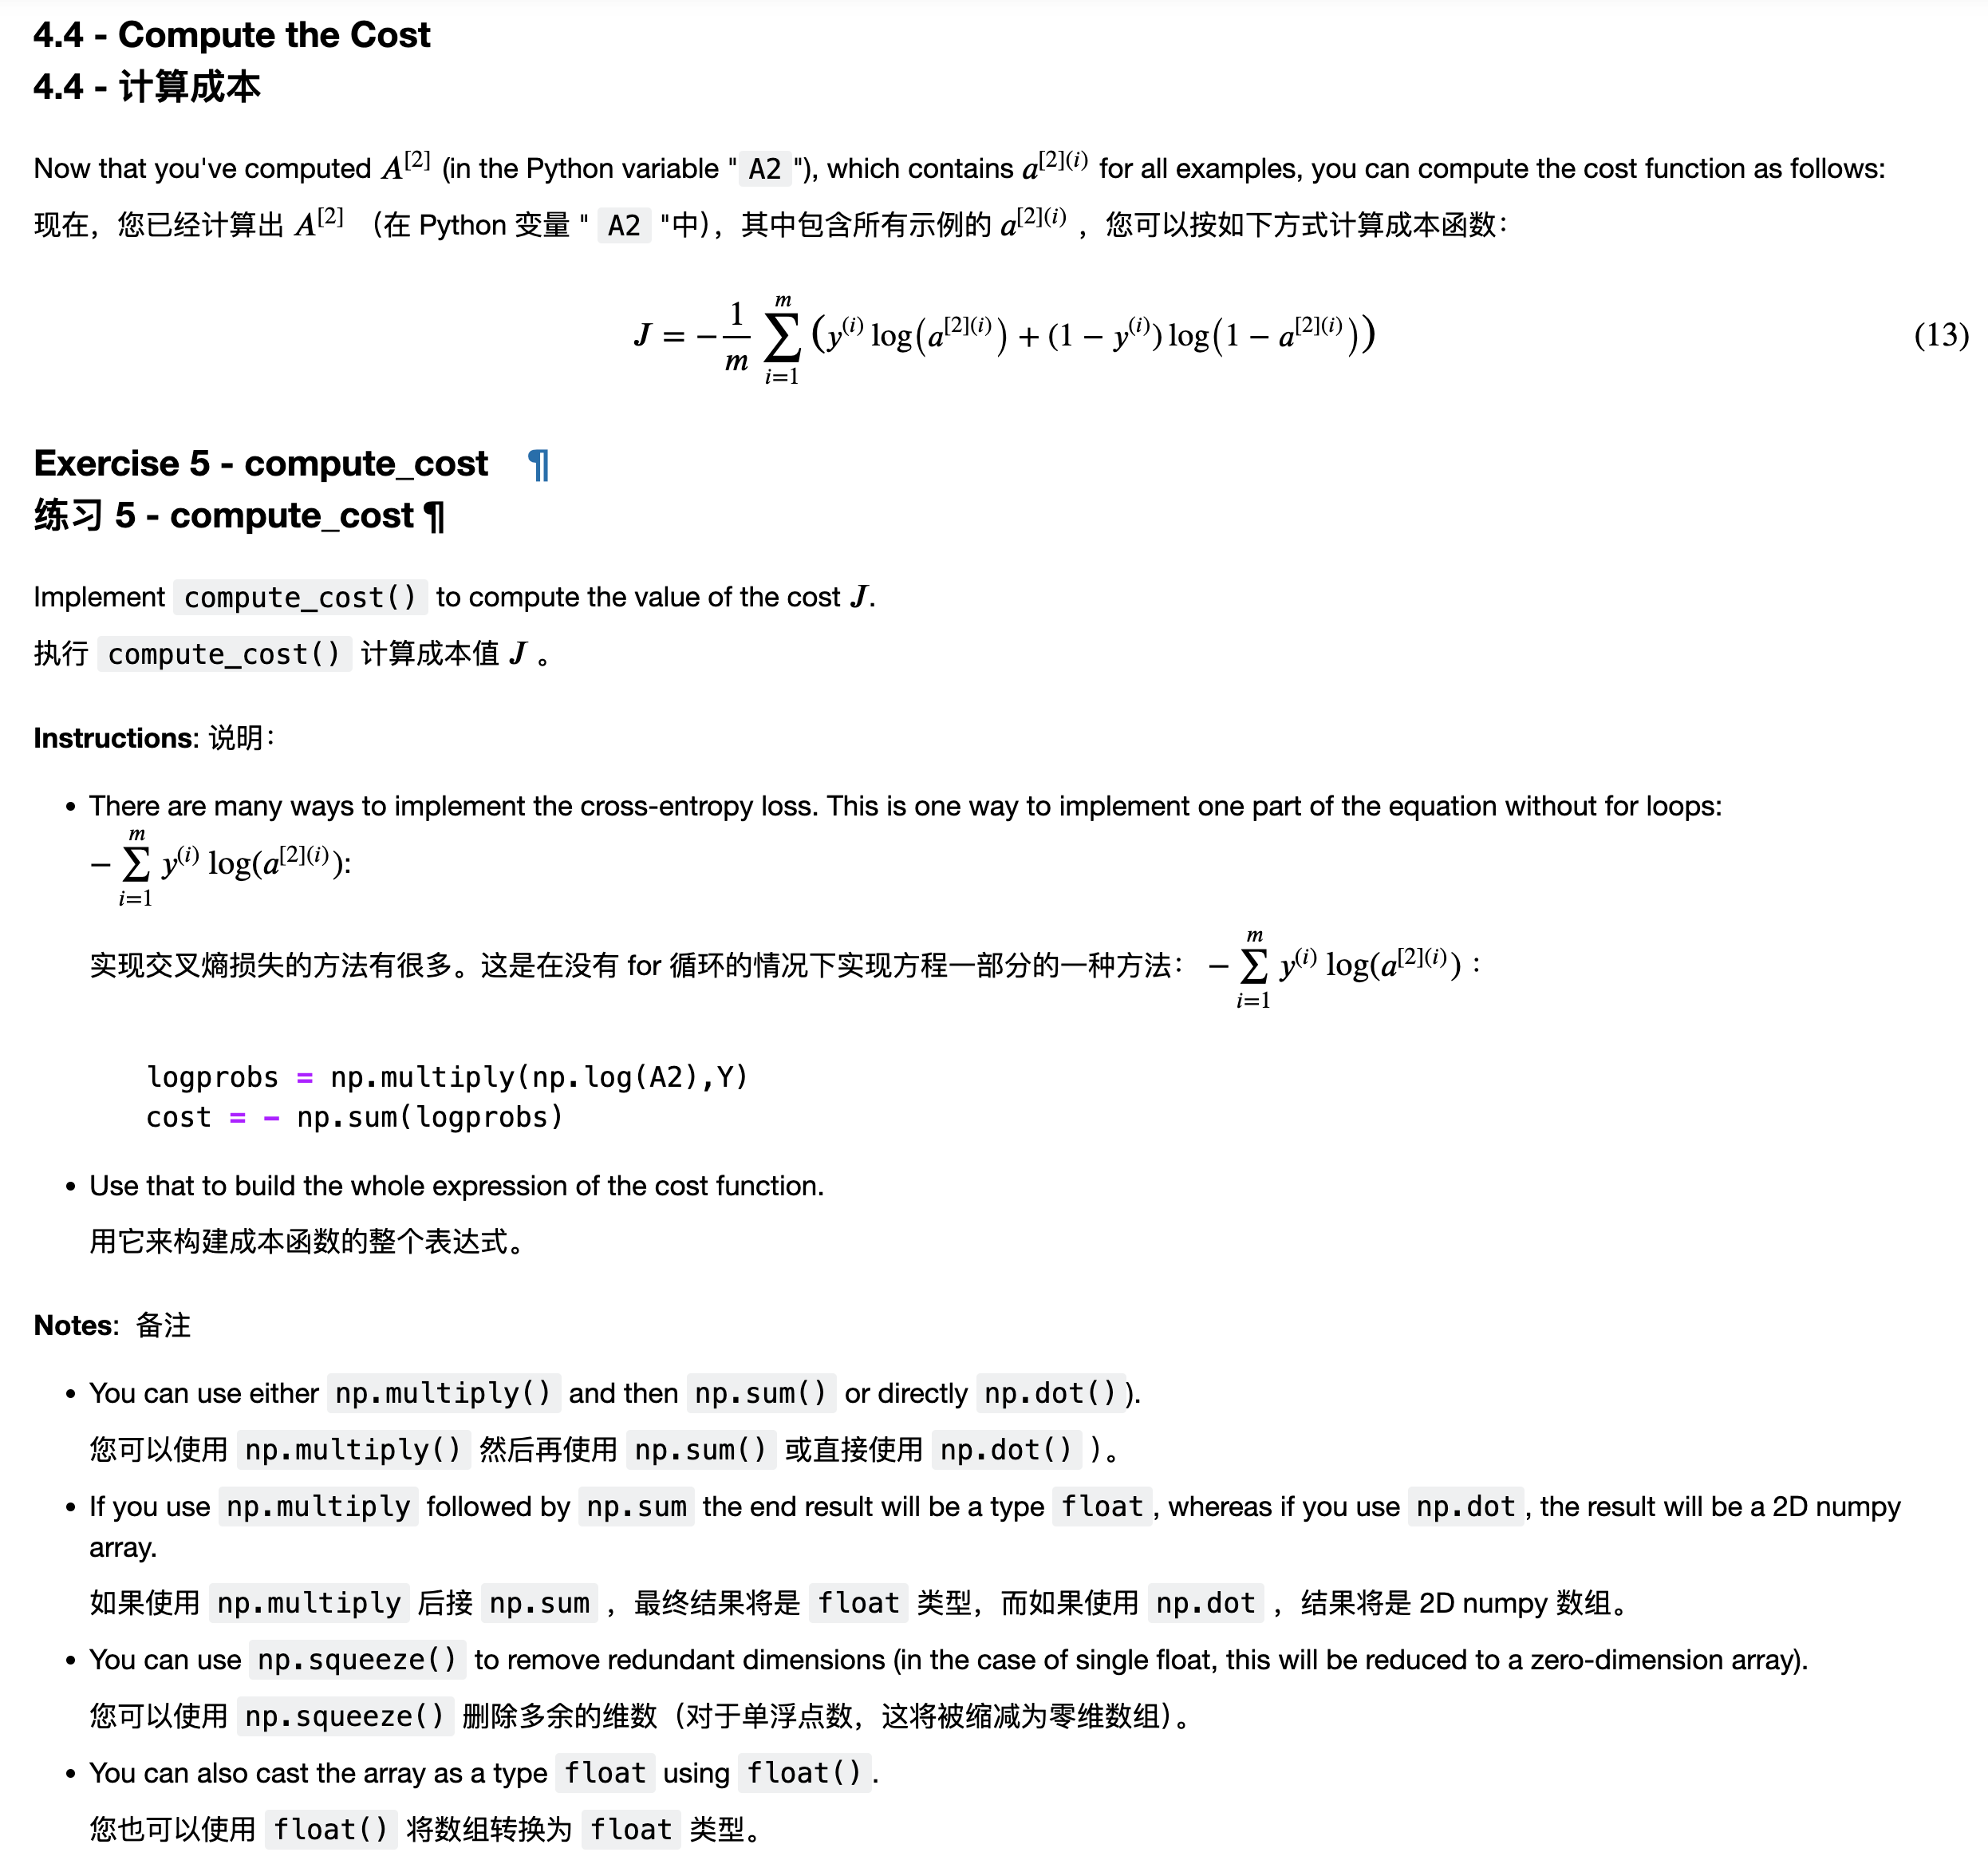
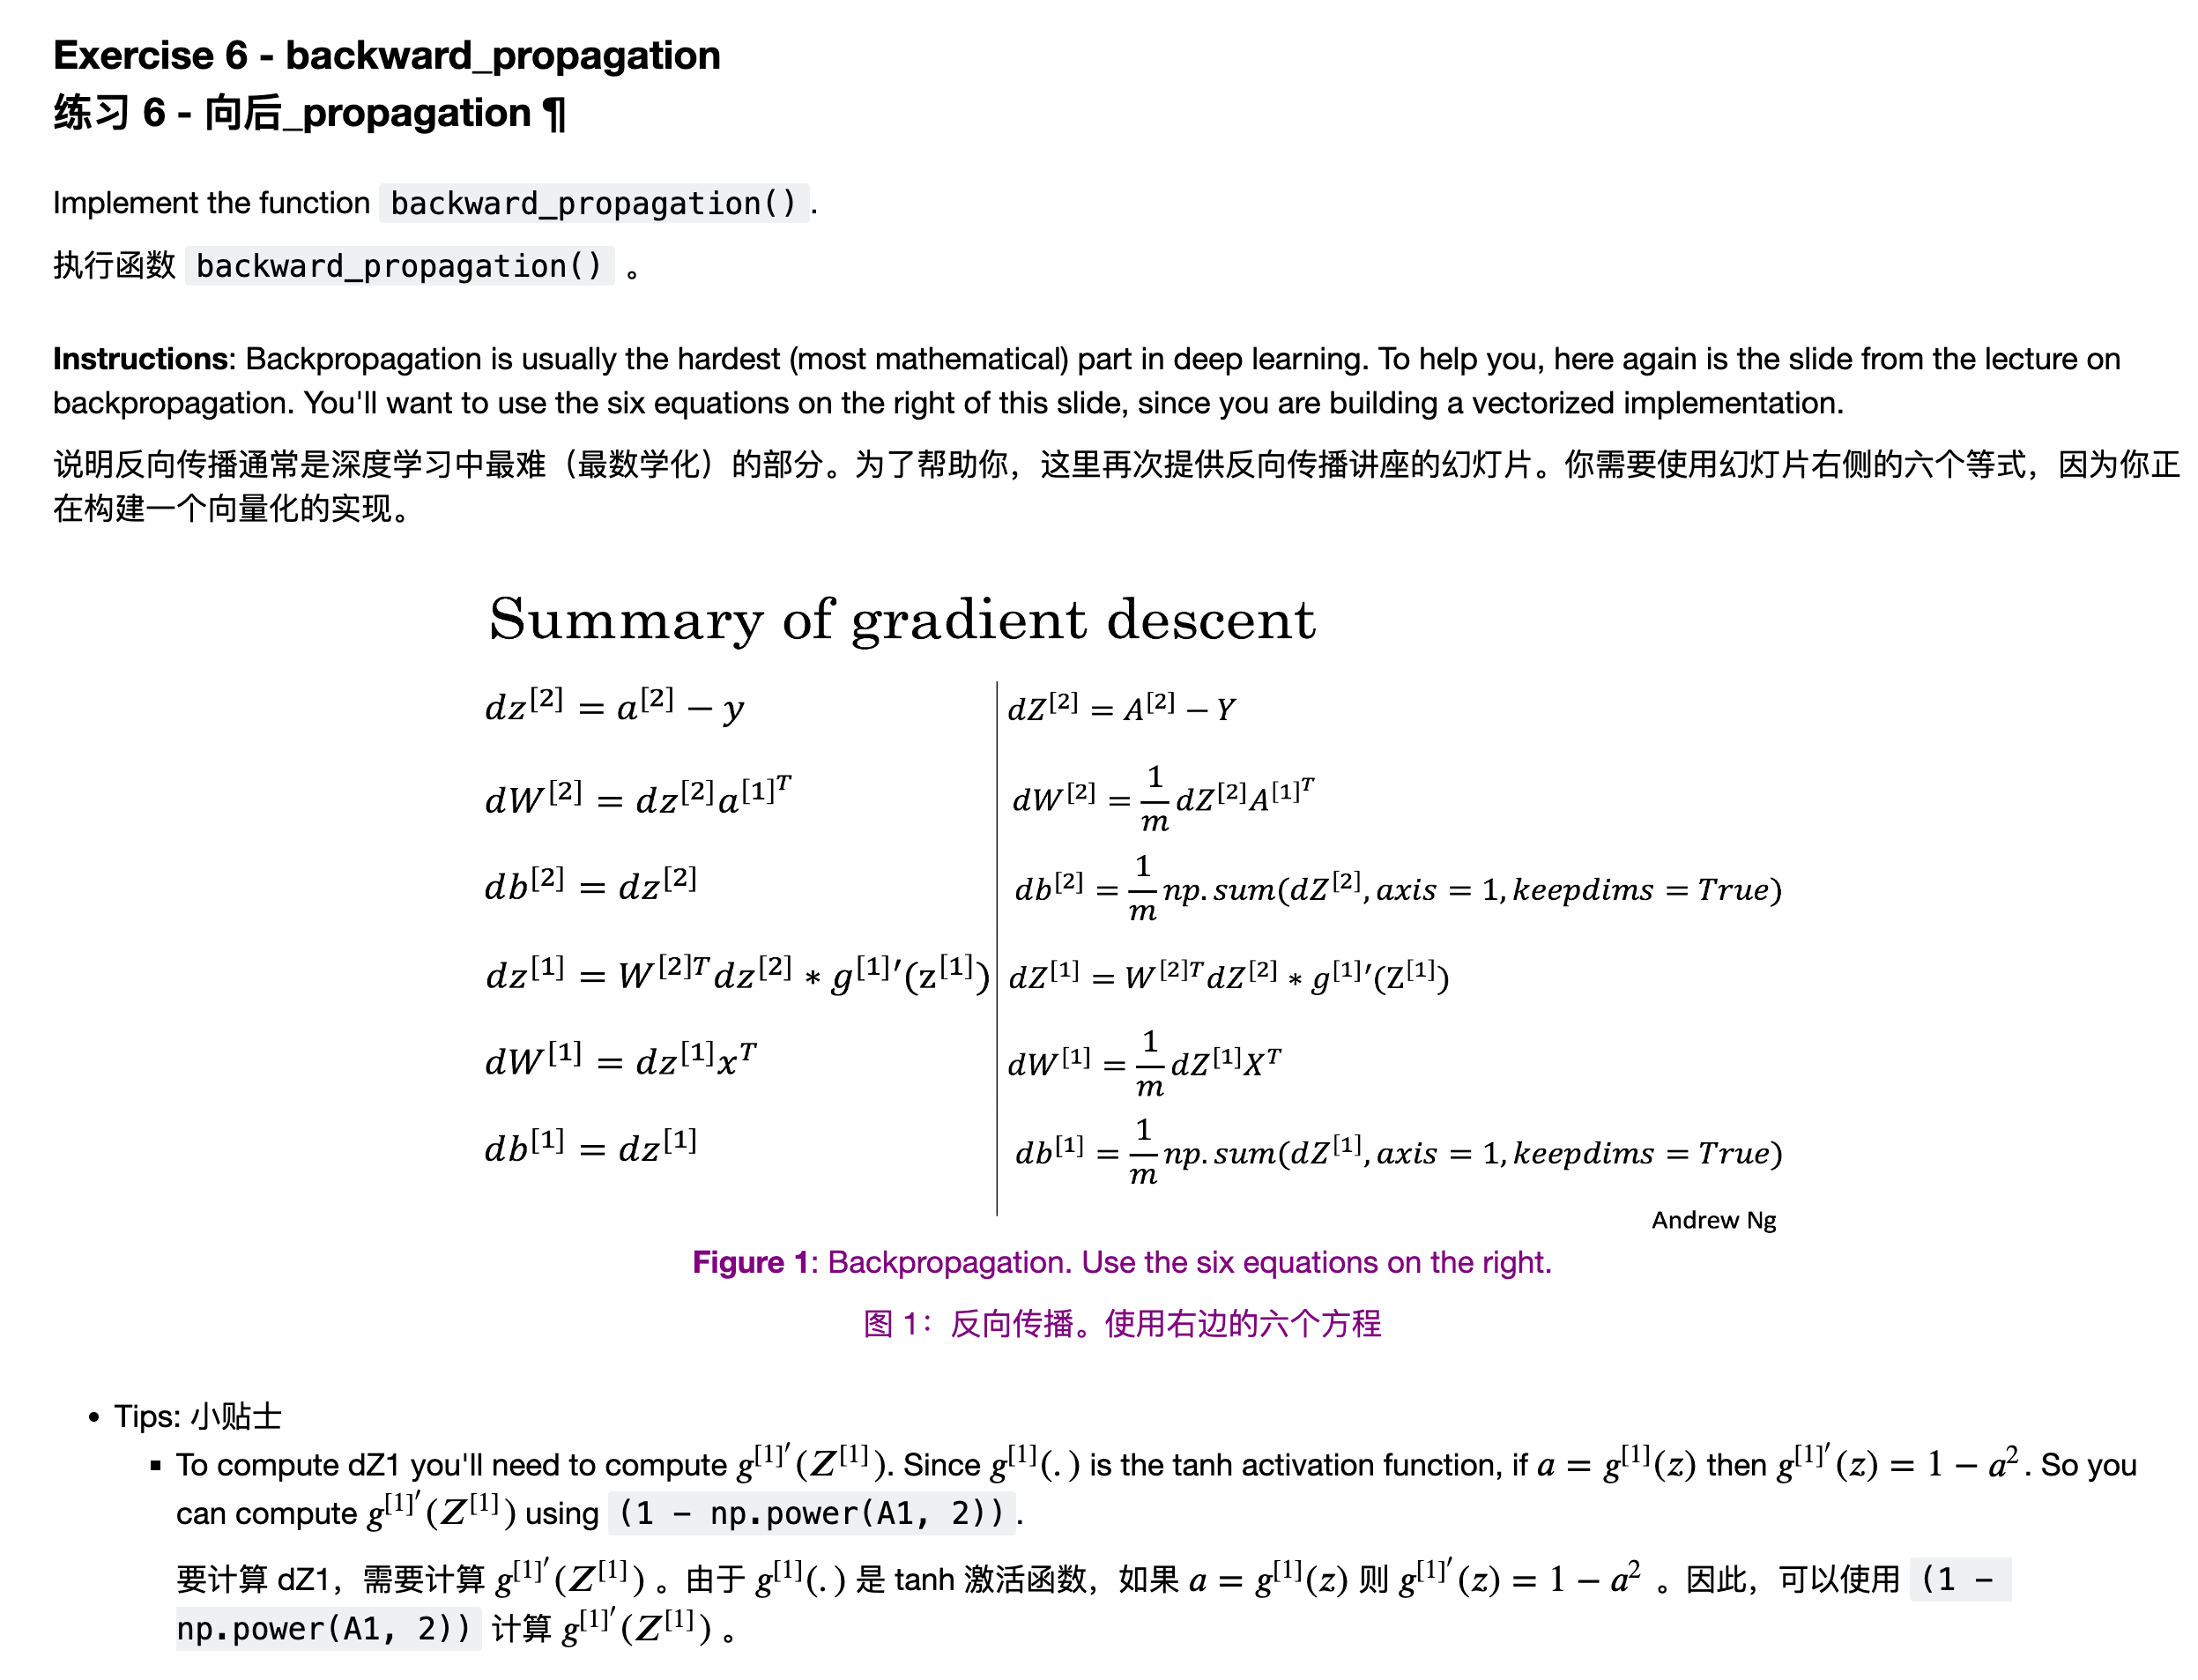
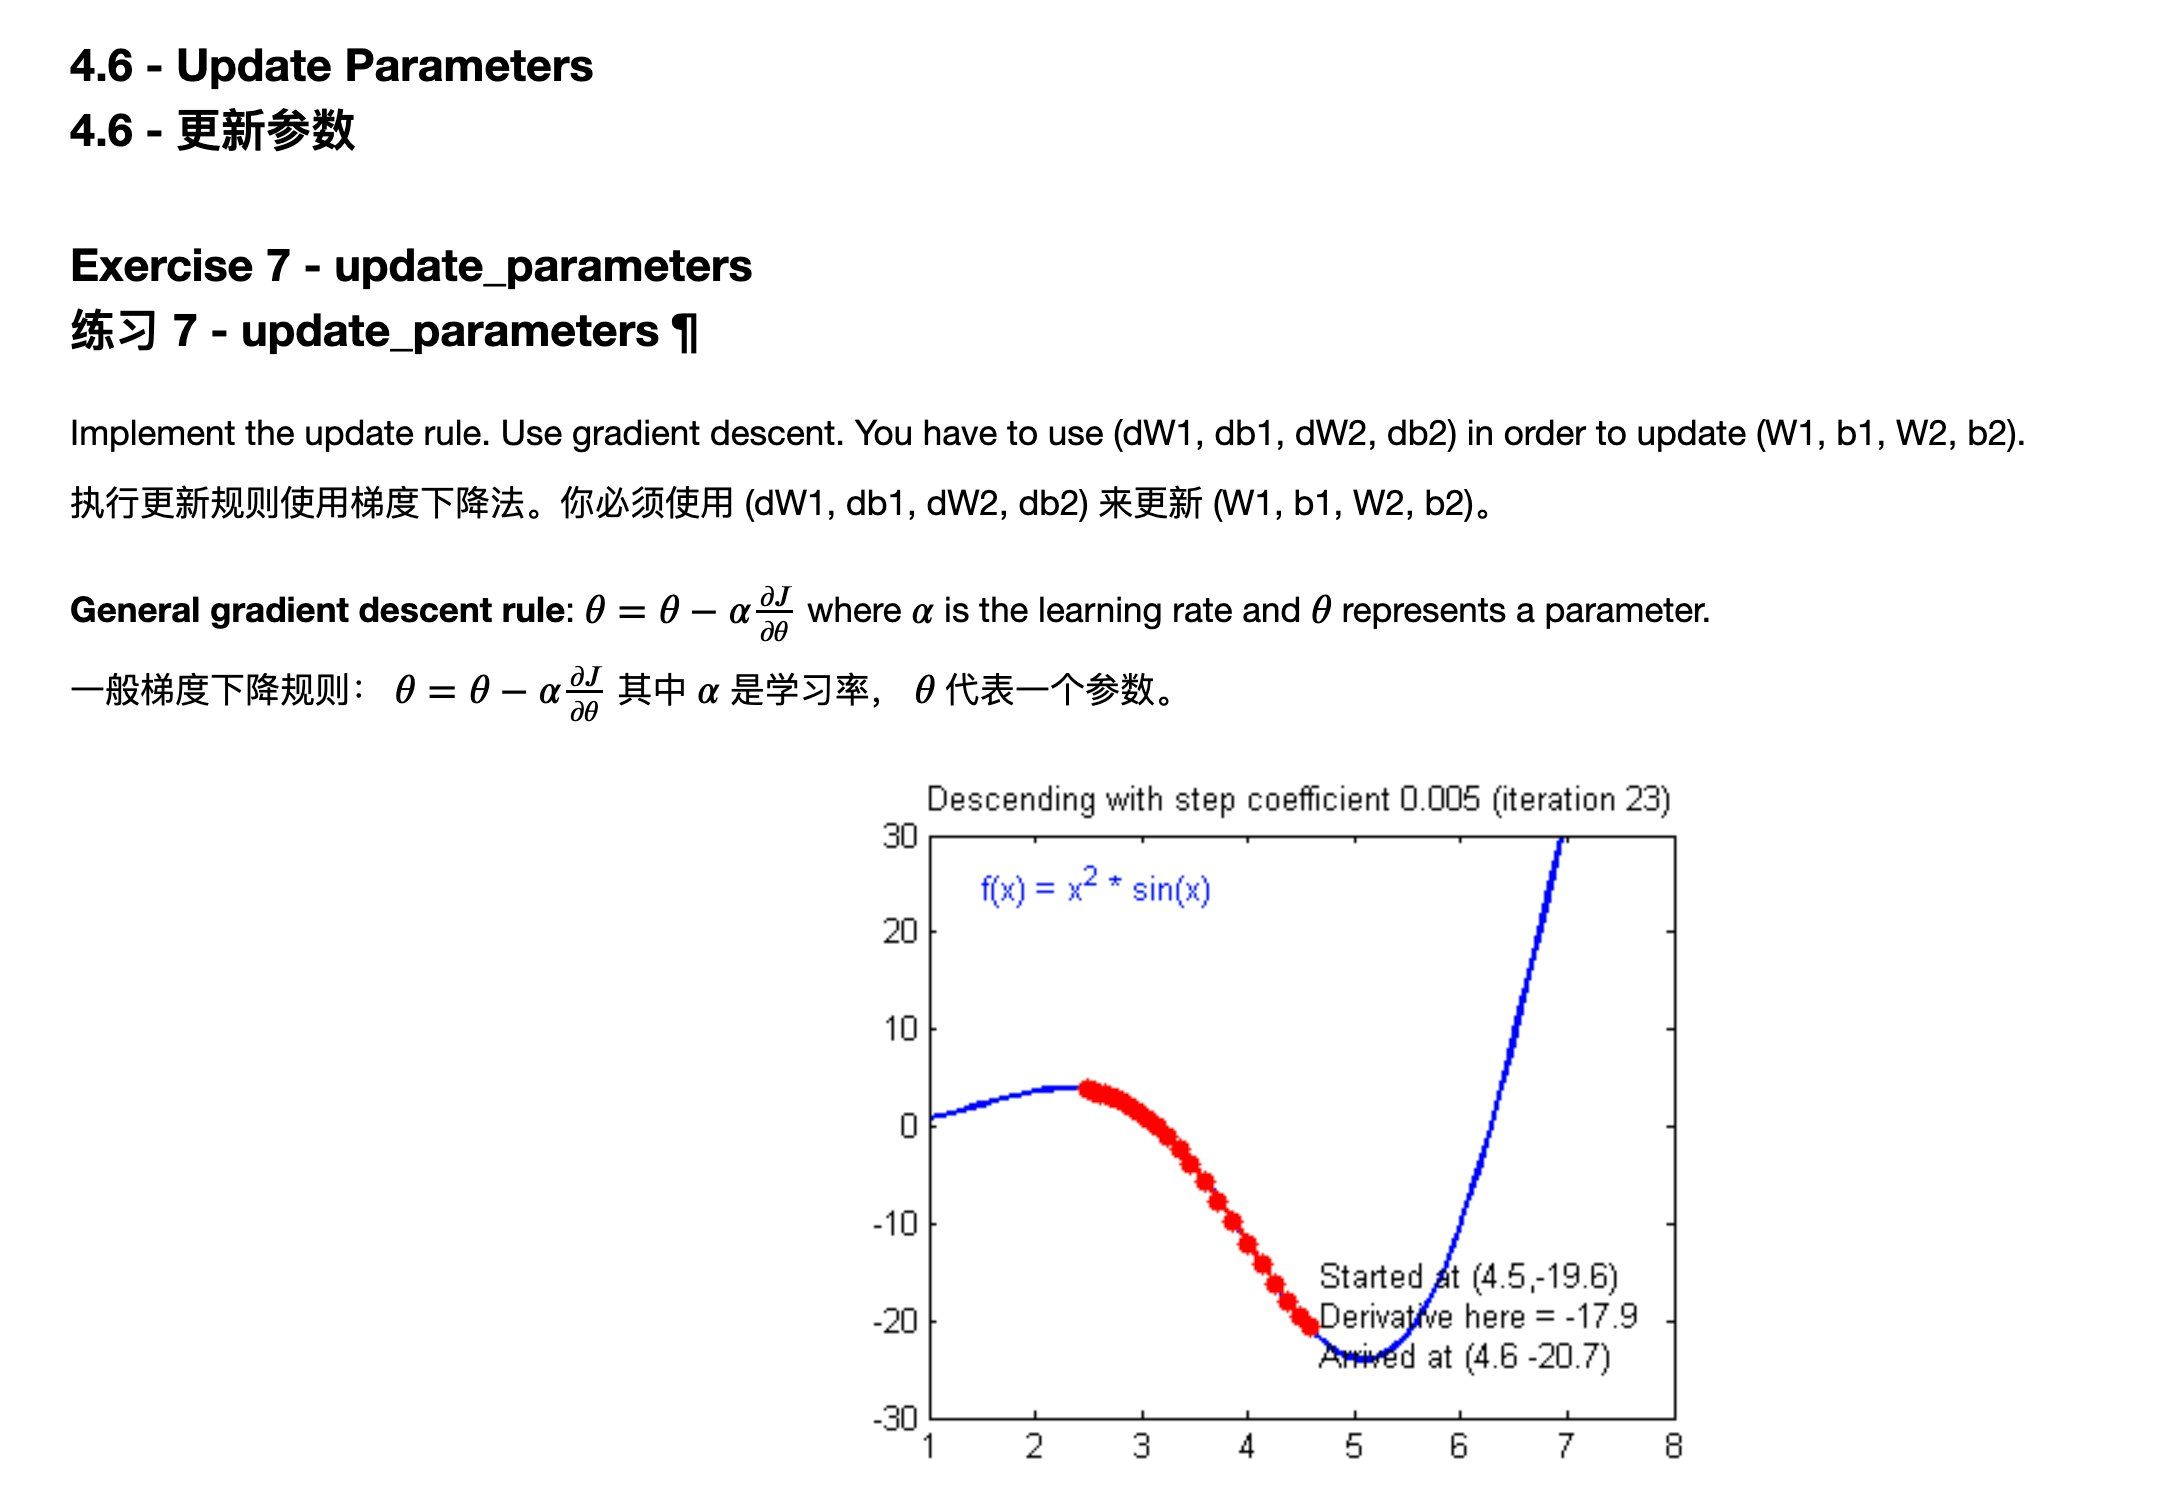
深度神经网络
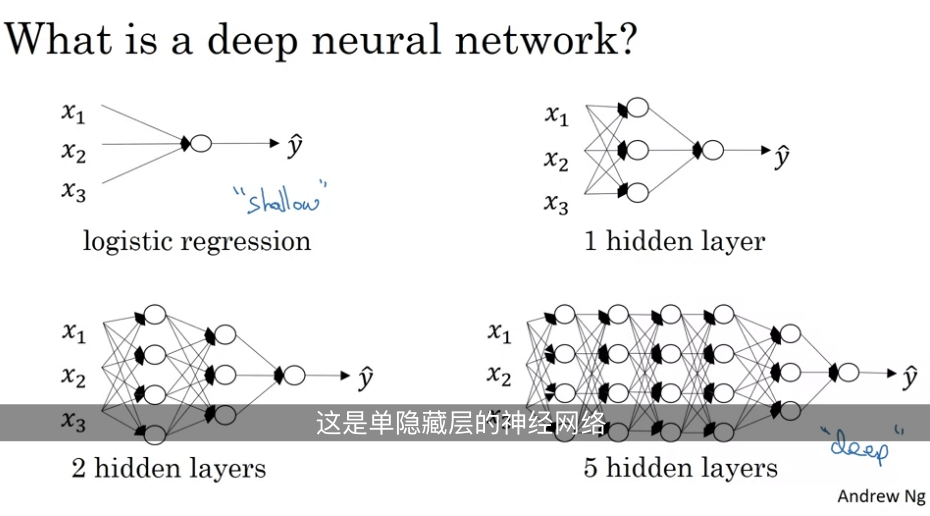
单层神经网络:单层神经网络
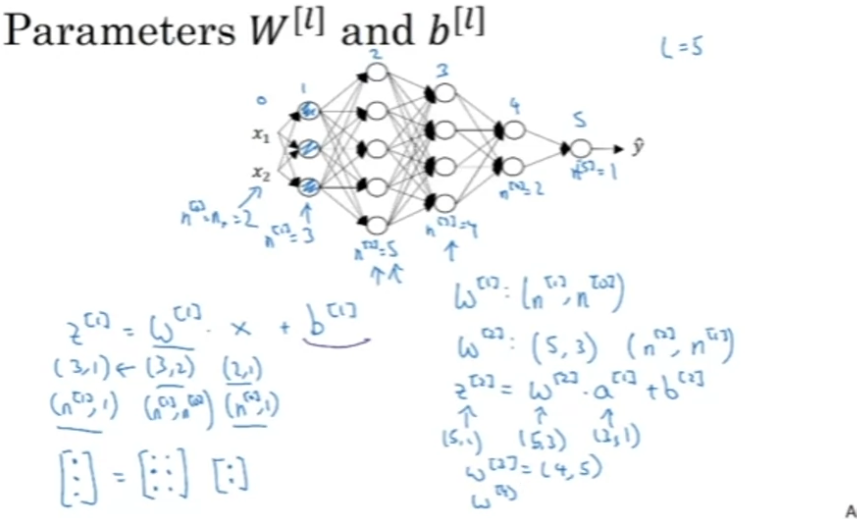
w[l]=(n[l], n[l-1])
b[1] = (n[l], 1)
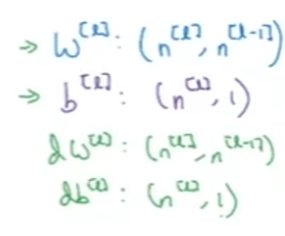
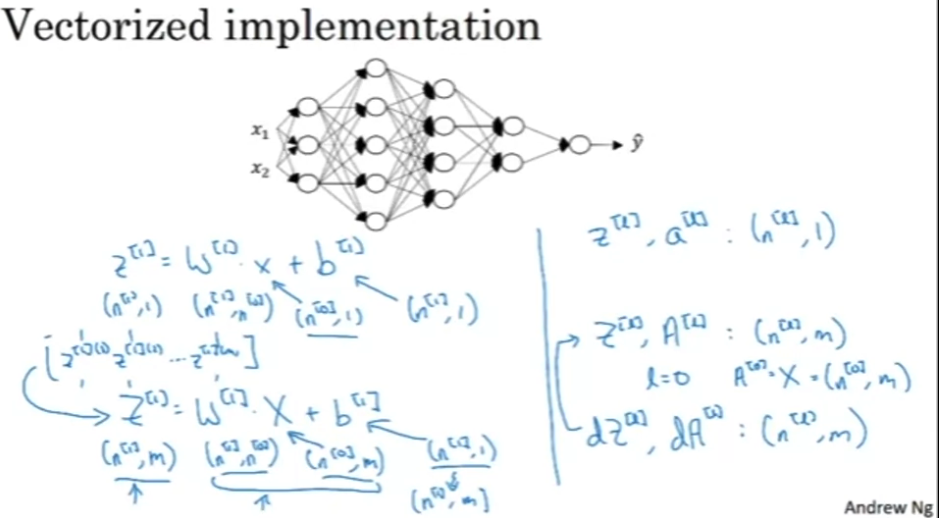
z[l] = (n[l], m)
(b[1] 广播了, board-casting)
电路理论和深度学习
非正式地说:有些函数可以使用“小型”L 层深度神经网络来计算,而较浅的网络需要指数级更多的隐藏单元来计算。
- 成本计算
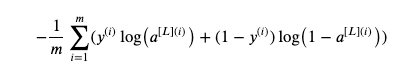
- 计算导数(梯度下降)