Module 02 · The Data Engineering Ecosystem数据工程生态系统
Data Warehouses, Data Marts, and Data Lakes数据仓库、数据集市与数据湖
所有数据挖掘存储库都有一个相似的目标:容纳数据以用于报告、分析和获取洞察。然而,它们的目的、存储的数据类型以及数据访问方式各不相同。
本视频将介绍数据仓库、数据集市和数据湖的特点与应用。
一、数据仓库 (Data Warehouse)
数据仓库是整合自多个来源的数据的中央存储库。
📌 核心功能:
- 单一事实来源:存储经过清洗、整合和分类的当前和历史数据。
- 分析就绪:数据加载到数据仓库时,它已经被建模和结构化以用于特定目的,这意味着它分析就绪。
数据类型与演变
- 传统上:数据仓库主要存储来自事务系统和运营数据库(如 CRM、ERP、HR 和财务应用)的关系型数据。
- 新兴趋势:随着 NoSQL 技术和新数据源的出现,非关系型数据存储库也开始用于数据仓库。
三层架构
数据仓库通常具有三层架构:
| 架构层级 | 组成部分 | 功能描述 |
|---|---|---|
| 底层 (Bottom Tier) | 数据库服务器(关系型、非关系型或兼有) | 从不同来源提取数据。 |
| 中层 (Middle Tier) | OLAP 服务器 | 一类软件,允许用户处理和分析来自多个数据库服务器的信息。 |
| 顶层 (Topmost Tier) | 客户端前端层 | 包含所有用于查询、报告和分析数据的工具和应用。 |
云端数据仓库的优势
为应对数据快速增长和日益复杂的分析工具,许多数据仓库正从本地数据中心迁移到云端。与本地版本相比,云端数据仓库提供以下优势:
- 更低的成本
- 无限的存储和计算能力
- 按需付费的扩展能力
- 更快的灾难恢复
应用场景
当组织拥有大量来自运营系统的数据,且需要随时可用于报告和分析时,应选择数据仓库。
流行的数据仓库
- Teradata Enterprise Data Warehouse platform
- Oracle Exadata
- IBM Db2 Warehouse on Cloud
- IBM Netezza Performance Server
- Amazon RedShift
- Google BigQuery
- Cloudera's Enterprise Data Hub
- Snowflake Cloud Data Warehouse
二、数据集市 (Data Mart)
数据集市是数据仓库的子部分,专门为特定的业务职能、目的或用户群体而构建。
🎯 示例:组织中的销售或财务团队访问数据以进行季度报告和预测。
三种基本类型
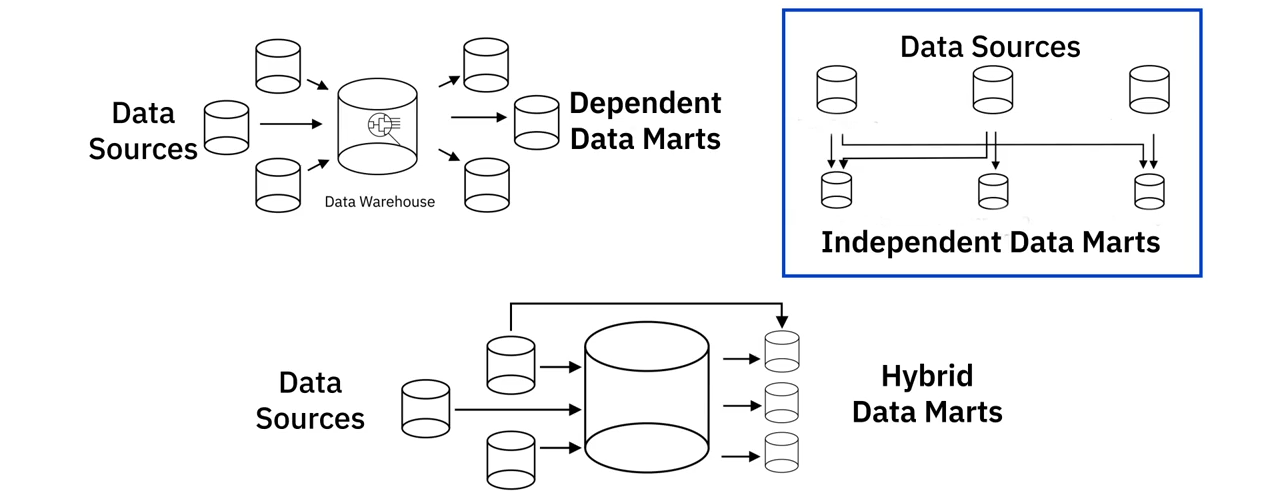
| 类型 | 来源 | 特点 |
|---|---|---|
| 从属数据集市 (Dependent) | 企业数据仓库的子部分。 | 为数据仓库的受限区域提供分析能力,并提供隔离的安全性和性能。 |
| 独立数据集市 (Independent) | 非企业数据仓库的其他来源(如内部运营系统或外部数据)。 | 需要对源数据进行转换过程。 |
| 混合数据集市 (Hybrid) | 数据仓库、运营系统和外部系统的输入组合。 | - |
数据提取与转换
- 从属数据集市:从已清洗和转换的企业数据仓库中提取数据。
- 独立数据集市:由于直接来自运营系统和外部来源,需要对源数据执行转换过程。
数据集市的目的
无论类型如何,数据集市的目的是:
- 在用户需要时提供与他们最相关的数据。
- 通过提供高效的响应时间来加速业务流程。
- 提供一种成本和时间高效的方式来制定数据驱动的决策。
- 改善终端用户响应时间。
- 提供安全访问和控制。
三、数据湖 (Data Lake)
数据湖是一种数据存储库,可以以其原始格式存储大量结构化、半结构化和非结构化数据。
与数据仓库的关键区别
| 特性 | 数据湖 | 数据仓库 |
|---|---|---|
| 数据格式 | 存储原始数据(Native Format)。 | 存储已清洗、处理和转换的数据。 |
| 模式要求 | 无需在加载前定义数据的结构和模式。 | 数据在加载前需要建模和结构化。 |
| 使用案例 | 甚至无需预知最终将用于分析的所有使用案例。 | 数据已为特定目的准备好。 |
⚠️ 重要提示:数据湖作为原始数据存储库,并非可以随意倾倒数据的地方。在数据湖中,数据会得到适当的分类、保护和治理。
部署与技术
- 技术独立:数据湖是一种独立于技术的参考架构。
- 促进敏捷探索:它结合了各种技术,以促进分析师和数据科学家进行敏捷的数据探索。
- 部署方式:
- 云对象存储:例如 Amazon S3。
- 大规模分布式系统:例如用于处理大数据的 Apache Hadoop。
- 关系型数据库管理系统 (RDBMS)。
- NoSQL 数据存储库,可存储海量数据。
数据湖的优势
数据湖提供多项优势:
- 存储所有类型数据:能够存储非结构化数据(如文档、电子邮件、PDF)、半结构化数据(如 JSON、XML、CSV 和日志),以及来自关系型数据库的结构化数据。
- 存储容量的敏捷扩展:能够根据存储容量进行扩展,从 TB 级增长到 PB 级数据。
- 节省时间:由于数据以其原始格式导入,节省了定义结构、模式和转换的时间。
- 数据重用能力:能够以多种不同方式和广泛的使用案例重用数据。这对于企业来说极其有利,因为很难预见未来可能利用其数据的所有不同方式。
数据湖技术供应商
提供数据湖技术、平台和参考架构的供应商包括:
- Amazon、Cloudera、Google、IBM、Informatica、Microsoft、Oracle、SAS、Snowflake、Teradata 和 Zaloni。
结论
在本视频中,我们了解了数据仓库、数据集市和数据湖等数据挖掘存储库的能力。虽然它们的目标相似,但在选择最适合组织需求的存储库时,需要根据使用案例和技术基础设施的背景进行评估。