Module 03 · Data Engineering Lifecycle数据工程生命周期
Architecting the Data Platform数据平台架构分层:从采集到分析
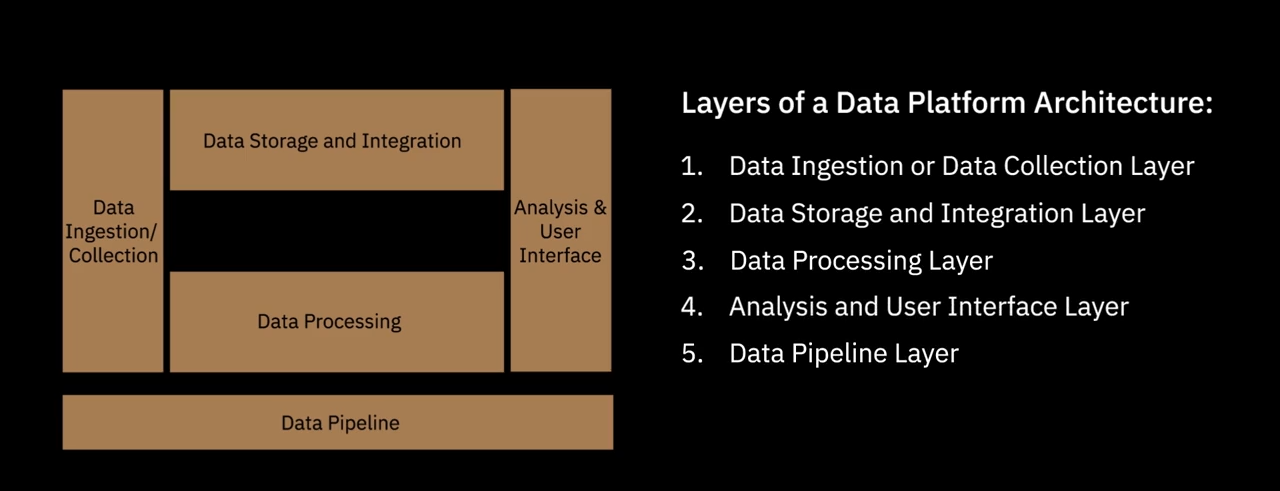
本视频将介绍数据平台架构的各个层级。每个层级都代表了在数据平台中执行特定任务集合的功能组件。
我们将探讨的层级包括:
- 数据采集层 (Data Ingestion or Data Collection Layer)
- 数据存储与集成层 (Data Storage and Integration Layer)
- 数据处理层 (Data Processing Layer)
- 分析与用户界面层 (Analysis and User Interface Layer)
我们还将了解跨越多个层级的数据管道层 (Data Pipeline Layer)。
一、数据采集层 (Data Collection Layer)
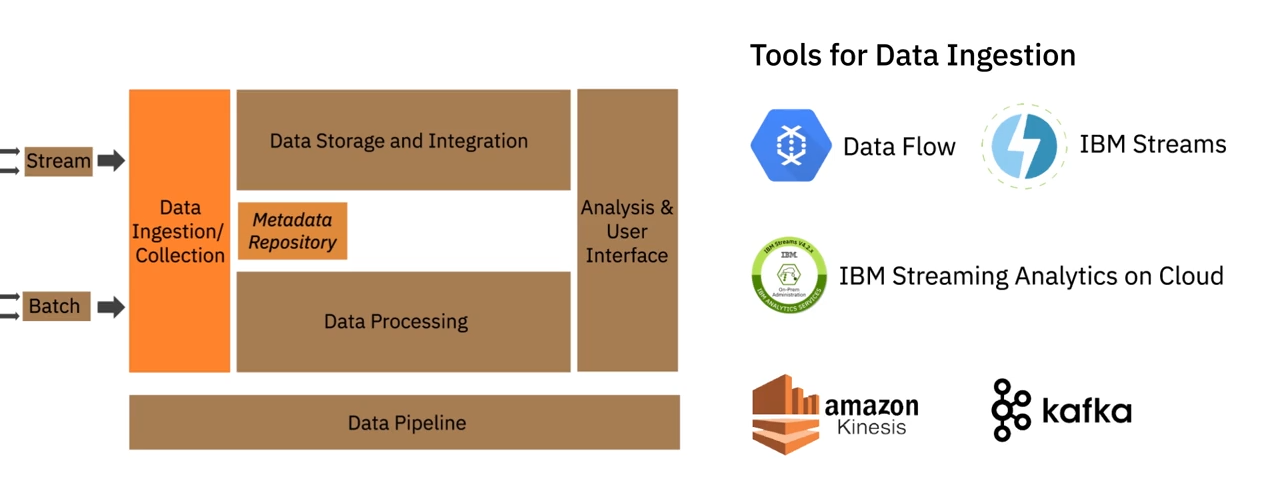
数据采集层负责连接到源系统并将这些系统中的数据引入数据平台。
关键任务
- 连接数据源:建立与数据源的连接。
- 数据传输:以流式、批量或两者结合的模式,将数据从数据源传输到数据平台。
- 维护元数据:在元数据存储库中维护所收集数据的信息,例如批量摄入的数据量、数据源和其他描述性信息。
工具示例
- 支持批量和流式:Google Cloud DataFlow、IBM Streams、IBM Streaming Analytics on Cloud、Amazon Kinesis、Apache Kafka。
二、数据存储与集成层 (Storage and Integration Layer)
数据摄入后,需要进行存储和集成。此层级在数据平台中需要完成以下任务:
核心职责
- 数据存储:存储数据以供处理和长期使用。
- 数据集成:逻辑或物理地转换和合并提取的数据。
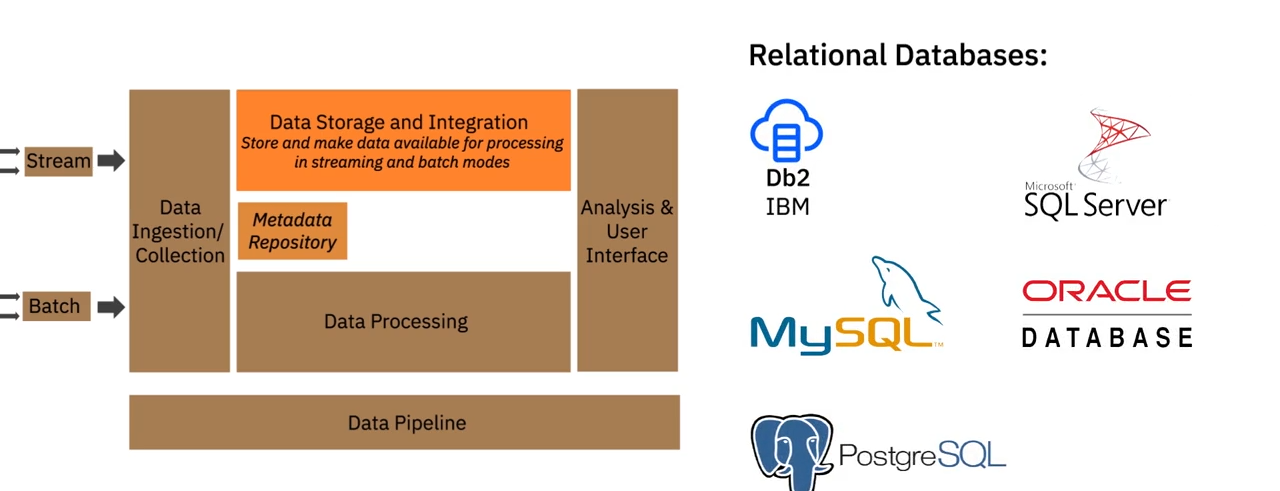
- 数据可用性:使数据以流式和批量两种模式可用于处理。
💡 存储要求:存储层需要可靠、可扩展、高性能,同时也要经济高效。
存储技术示例
| 类别 | 平台示例 | 备注 |
|---|---|---|
| 关系型数据库 (RDBMS) | IBM DB2、Microsoft SQL Server、MySQL、Oracle Database、PostgreSQL | - |
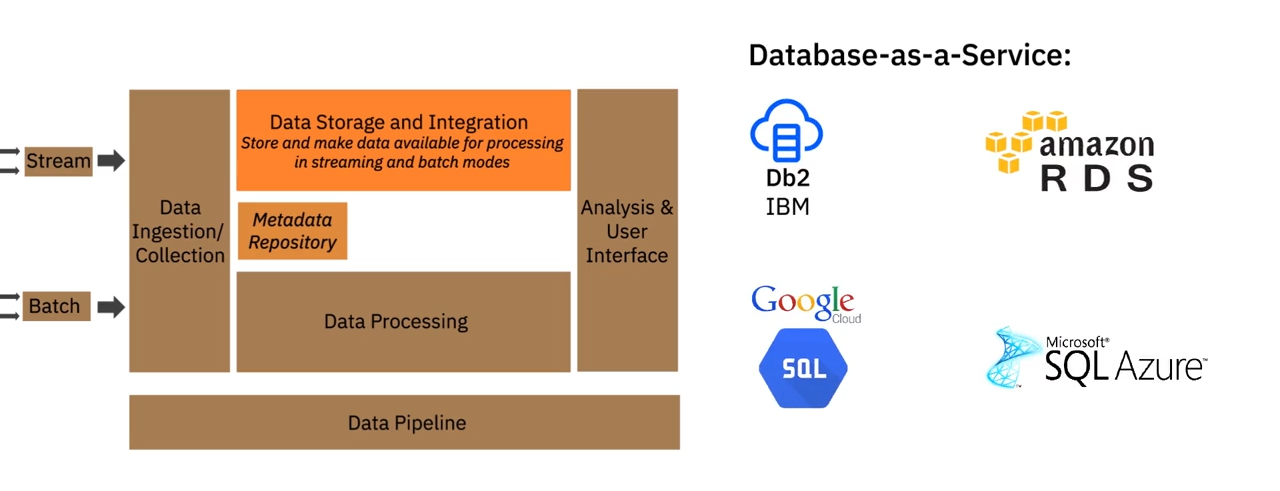
| 云端 RDBMS | IBM DB2 on Cloud、Amazon RDS、Google Cloud SQL、SQL Azure | 也称为 Database-as-a-Service,近年来广受欢迎。 |
| 云端 NoSQL | IBM Cloudant、Redis、MongoDB、Cassandra、Neo4J | - |
集成工具示例
- 商业工具:IBM Cloud Pak for Data 和 Cloud Pak for Integration;Talend's Data Fabric 和 Open Studio。
- 开源/商业工具:Dell Boomi、SnapLogic。
- 云端 iPaaS (Integration Platform as a Service):Adeptia Integration Suite、Google Cloud's Cooperation 534、IBM's Application Integration Suite on Cloud、Informatica's Integration Cloud。
三、数据处理层 (Data Processing Layer)
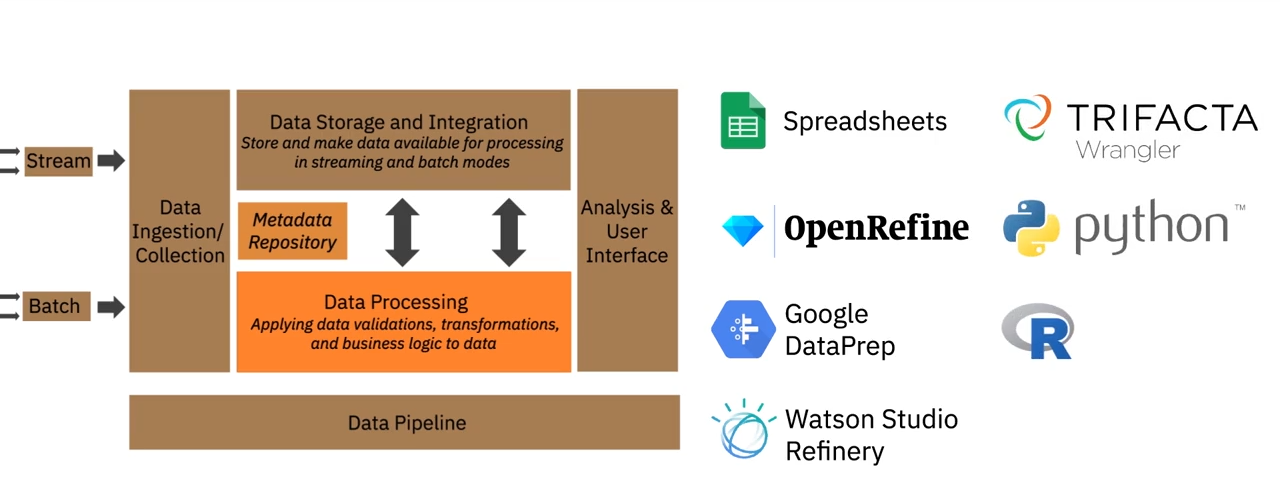
数据经过摄入、存储和集成后,需要进行处理。数据验证、转换和应用业务逻辑是此层级需要进行的部分工作。
处理能力要求
- 读写能力:能够以批量或流式模式从存储中读取数据并应用转换。
- 工具支持:支持流行的查询工具和编程语言。
- 可扩展性:能够扩展以满足不断增长的数据集对处理的需求。
- 数据协作:为分析师和数据科学家提供一种在数据平台中处理数据的方式。
转换任务类型
此层级发生的一些转换任务包括:
- 结构化 (Structuring):本质上是改变数据的形式和模式的行动。可能简单到改变字段顺序,复杂到使用连接 (joins) 和联合 (unions) 将字段组合成复杂结构。
- 规范化 (Normalization):专注于清理数据库中未使用的数据,减少冗余和不一致性。
- 反规范化 (Denormalization):将多个表中的数据合并到单个表中,以便更有效地进行报告和分析查询。
- 数据清洗 (Data Cleaning):修复数据中的不规则性,为下游应用和用途提供可信数据。
工具与技术
用于执行这些转换的工具众多,选择基于数据大小、结构和工具的特定功能:
- 专用工具:电子表格、OpenRefine、Google DataPrep、Watson Studio Refinery、Trifacta Wrangler。
- 编程语言:Python 和 R 提供了许多专门为数据处理创建的库和包。
📌 存储与处理的关系
值得注意的是,存储和处理不一定总是在不同的层级进行:
- 在关系型数据库中,存储和处理可能发生在同一层。
- 在大数据系统中,数据可以首先存储在 Hadoop 分布式文件系统 (HDFS) 中,然后由 Spark 等数据处理引擎进行处理。
- 数据处理层也可以在数据存储层之前,即在数据加载或存储到数据库之前应用转换。
四、分析与用户界面层 (Analysis and User Interface Layer)
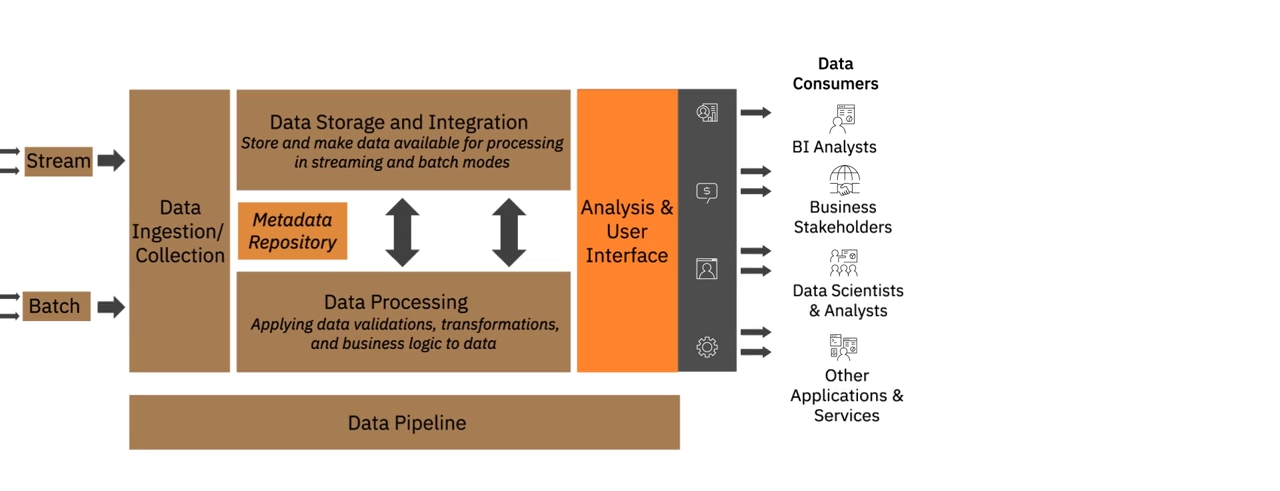
分析与用户界面层将经过处理的数据交付给数据消费者。
数据消费者类型
- 商业智能分析师和业务利益相关者:通过交互式视觉表示(如仪表板和分析报告)消费数据。
- 数据科学家和数据分析师:进一步处理数据以用于特定用例。
- 其他应用和服务:可能需要此数据作为输入的应用程序和服务。
所需支持
- 查询工具和编程语言:
- SQL(用于关系型数据库)和 SQL-like 查询工具(如 Cassandra 的 CQL)。
- 编程语言:如 Python、R 和 Java。
- APIs:可用于运行在线和离线处理报告的 APIs;可实时从存储中获取数据供其他应用和服务使用的 APIs。
- 仪表板和商业智能应用:
- IBM Cognos Analytics、Tableau、Jupyter Notebooks、Python 和 R 库、Microsoft Power BI。
五、数据管道层 (Data Pipeline Layer)
数据管道层覆盖了数据采集、数据存储与集成和数据处理层,其中包含了 抽取、转换和加载 (ETL) 工具。
- 职责:此层级负责实现和维护持续流动的数据管道。
- 流行解决方案:Apache Airflow 和 DataFlow。
在本视频中,您了解了数据平台架构的各个层级。这是一个对支持广泛任务的复杂架构的简化呈现。