Module 02 · The Data Engineering Ecosystem数据工程生态系统
(Optional): Data Lakehouses Explained数据湖仓一体详解(可选)
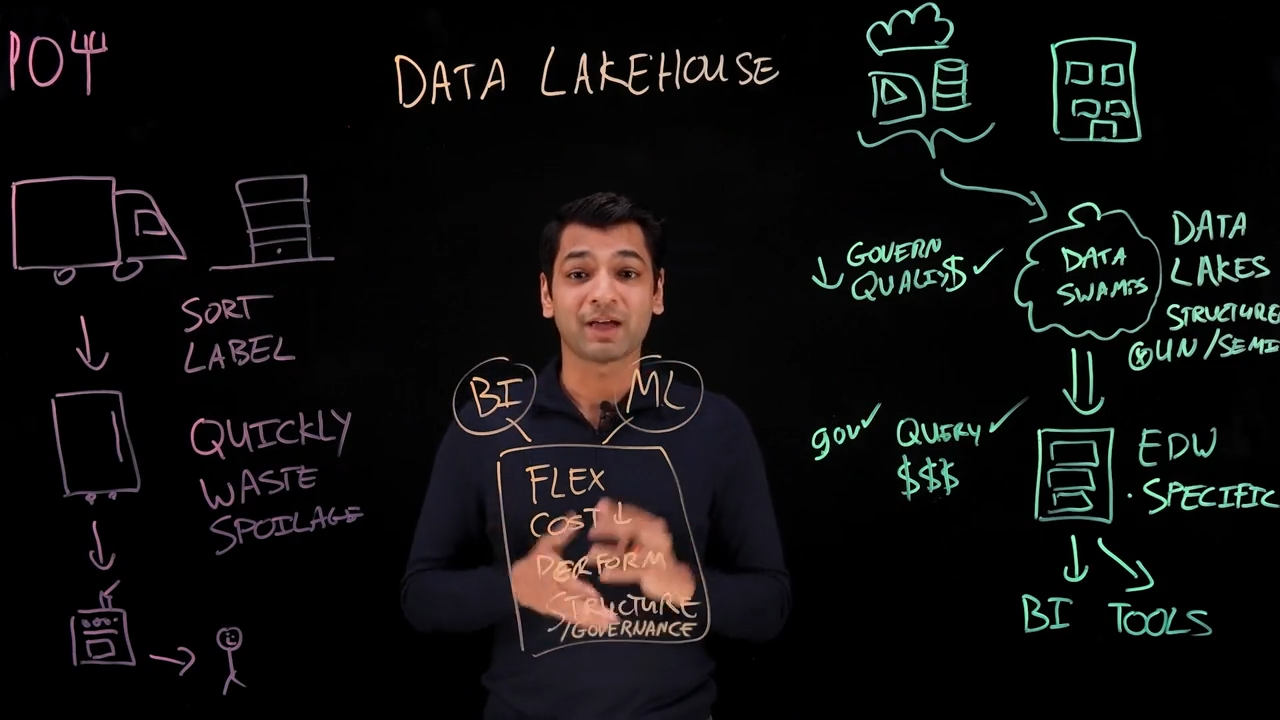
上周,我在一家餐馆用餐,环顾四周,餐厅里座无虚席,每个人的订单都及时送达。我不禁思考,一家餐厅是如何通过物流将原材料转化为这些美味佳肴的。
让我们思考一下商业厨房中的流程:
一、餐厅厨房的食材流程(数据架构的类比)
| 厨房阶段 | 描述 | 数据架构类比 |
|---|---|---|
| 收货 | 原材料由卡车运送到装卸区的大型托盘上,卡车迅速离开。 | 数据摄取:各种不同数据(来自云环境、运营应用、社交媒体等)持续进入组织。 |
| 初步处理 | 必须尽快拆封、分类、贴标签,以最大限度地减少浪费和变质。 | 数据湖 (Data Lake):需要一个快速、廉价的地方来接收各种类型和格式的原始数据,以供后续使用。 |
| 存储和组织 | 食材被分派到正确的储存区(干货储藏室、冷藏室、冷冻室),并进行组织:确保先进先出(先进先用)、防止污染、保持食品安全温度。 | 数据仓库 (Data Warehouse):数据从原始状态(有时来自数据湖,有时来自运营应用)被组织和转换成可用的形式。 |
| 烹饪与服务 | 厨师使用整理好的食材高效、安全地烹饪和提供餐点。如果没有此流程,厨师将花费大量时间寻找食材,而不是烹饪。 | 洞察与分析:数据被优化和组织,以运行特定的分析任务,支撑 BI (Business Intelligence) 工作负载(如仪表板和报告)或其他分析工具。 |
二、数据湖与数据仓库的挑战
在组织的数据架构中,我们看到了类似的流程。数据湖和企业数据仓库 (EDWs) 在实现业务洞察方面各具优势,但也面临挑战:
1. 数据湖 (Data Lake) 的挑战
| 优势 | 挑战 | 结果 |
|---|---|---|
| 成本效益:能以经济高效的方式捕获大量原始、结构化、非结构化甚至半结构化数据。 | 数据治理与数据质量:容易出现挑战。 | 数据沼泽 (Data Swamps):如果存在大量重复、不准确或不完整的数据,数据湖就会变成数据沼泽,难以追踪和管理资产。 |
| 接收能力:能接收不同类型和格式的数据。 | 价值流失:如果数据闲置(变质),它将失去创造洞察的价值。 | 查询性能低下:数据湖并非为处理复杂的分析查询而构建和优化,因此难以直接从中快速获取洞察。 |
2. 数据仓库 (Data Warehouse) 的挑战
| 优势 | 挑战 | 结果 |
|---|---|---|
| 查询性能卓越:专为运行特定分析任务而优化。 | 高昂的成本:运行成本高昂,就像大型冷柜一样,无法容纳所有数据。 | 对非/半结构化数据的支持有限:无法很好地处理当前正在迅速增长的半结构化和非结构化数据源。 |
| 数据治理与质量:能更好地优化以维护数据治理和质量。 | 时效性不足:由于需要时间进行分类、清洗和加载,对于需要最新数据的某些应用来说可能太慢。 | - |
三、数据湖仓一体 (Data Lakehouse) 的出现
面对上述挑战,开发人员决定结合数据湖和数据仓库的最佳特性,创造出一种新技术:数据湖仓一体 (Data Lakehouse)。
核心价值
数据湖仓一体融合了以下优点:
- 数据湖的优势:获得灵活性和成本效益。
- 数据仓库的优势:获得性能和结构。
功能与应用
从价值的角度来看,数据湖仓一体:
- 低成本存储:允许以低成本的方式存储来自爆炸式增长的新数据源的数据。
- 内置治理:利用内置的数据管理和治理层。
- 驱动工作负载:能够快速驱动 商业智能 (BI) 和高性能机器学习 (ML) 工作负载。
使用 Lakehouse 的方式
- 现代化:对现有的数据湖进行现代化改造。
- 互补:作为现有数据仓库的补充,以支持新型 AI 和机器学习驱动的工作负载。
下次您在餐厅用餐时,希望您能想起盘中的佳肴是如何到达那里的,以及食材从厨房到餐桌所经历的各个步骤。