Module 02 · The Data Engineering Ecosystem数据工程生态系统
Overview of the Data Engineering Ecosystem数据工程师的生态系统构成
数据工程师的生态系统包括基础设施、工具、框架和流程,用于以下目的:
- 从不同来源提取数据。
- 构建和管理用于数据转换、集成和存储的数据管道。
- 构建和管理数据存储库。
- 自动化和优化系统之间的工作流程和数据流。
- 通过数据工程工作流程开发所需的应用程序。
1.数据类型:结构化、半结构化与非结构化
让我们先来看数据。根据数据的结构定义程度,数据可以分为:
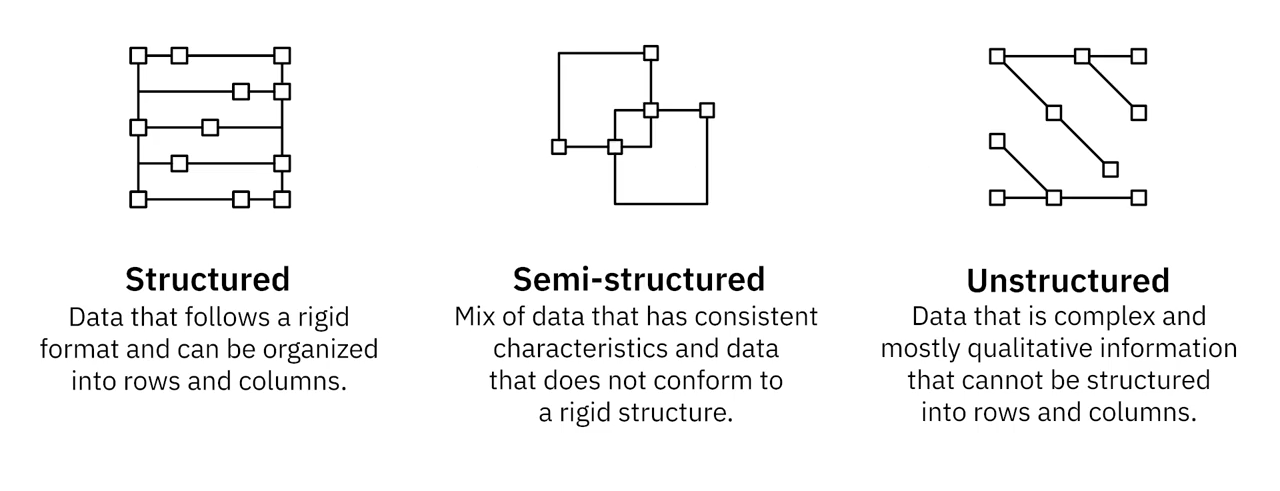
| 类型 | 特点 | 示例 |
|---|---|---|
| 结构化数据 | 遵循严格格式,可以整齐地组织成行和列。 | 数据库和电子表格中常见的数据。 |
| 半结构化数据 | 是具有一致特征的数据和不符合严格结构的数据的混合。 | 电子邮件:包含结构化数据(如发件人和收件人的姓名)和非结构化数据(如电子邮件内容)。 |
| 非结构化数据 | 复杂且大多是定性信息,无法简化为行和列。 | 照片、视频、文本文件、PDF 和社交媒体内容。 |
👉 数据类型驱动着可以收集和存储数据的数据存储库类型,以及可用于查询或处理数据的工具。
数据源的多样性
数据还以各种文件格式出现,并从各种数据源中收集,范围从关系型和非关系型数据库到 API、Web 服务、数据流、社交平台和传感器设备。
2.数据存储库 (Data Repositories)
数据工程师的生态系统也包括数据存储库。主要有两种类型:事务型和分析型。
| 存储库类型 | 别名/用途 | 特点 | 示例 |
|---|---|---|---|
| 事务型系统 | 在线事务处理 (OLTP) 系统。设计用于存储大容量的日常操作数据。 | 通常是关系型数据库,但也可以是非关系型的。 | 在线银行交易、ATM 交易和航空订票。 |
| 分析型系统 | 在线分析处理 (OLAP) 系统。针对执行复杂数据分析进行了优化。 | 包括关系型和非关系型数据库、数据仓库、数据集市、数据湖和大数据存储。 | 数据仓库、数据湖、大数据存储等。 |
👉 数据的类型、格式、来源和使用环境会影响理想的数据存储库的选择。
3.数据集成与管道 (Data Integration & Pipelines)
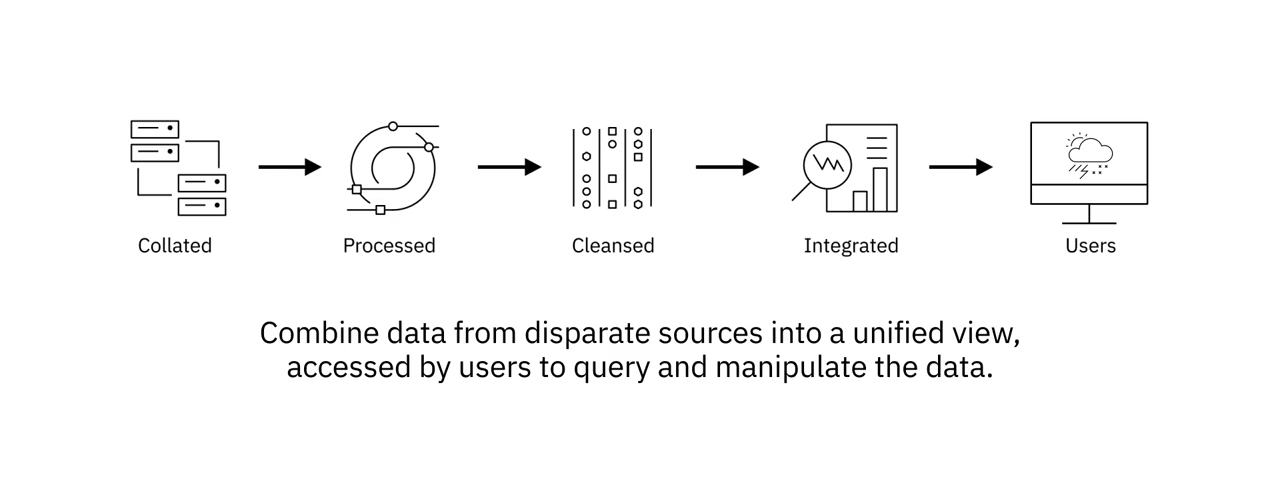
一旦从不同来源收集到的数据被整合,就需要进行处理、清洗和集成,以便用户可以通过单一界面访问这些数据。
- 数据集成工具: 将来自不同来源的数据整合为一个统一视图,用户通过该视图查询和操作数据。
- 数据管道 (Data Pipelines): 这是一套工具和流程,涵盖数据从源系统到目标系统的整个旅程。
- 数据在数据管道中通过诸如 提取-转换-加载 (ETL) 过程或提取-加载-转换 (ELT) 过程进行集成。
4.语言与工具 (Languages & Tools)
数据工程师的生态系统还包括:
语言分类
可归类为:
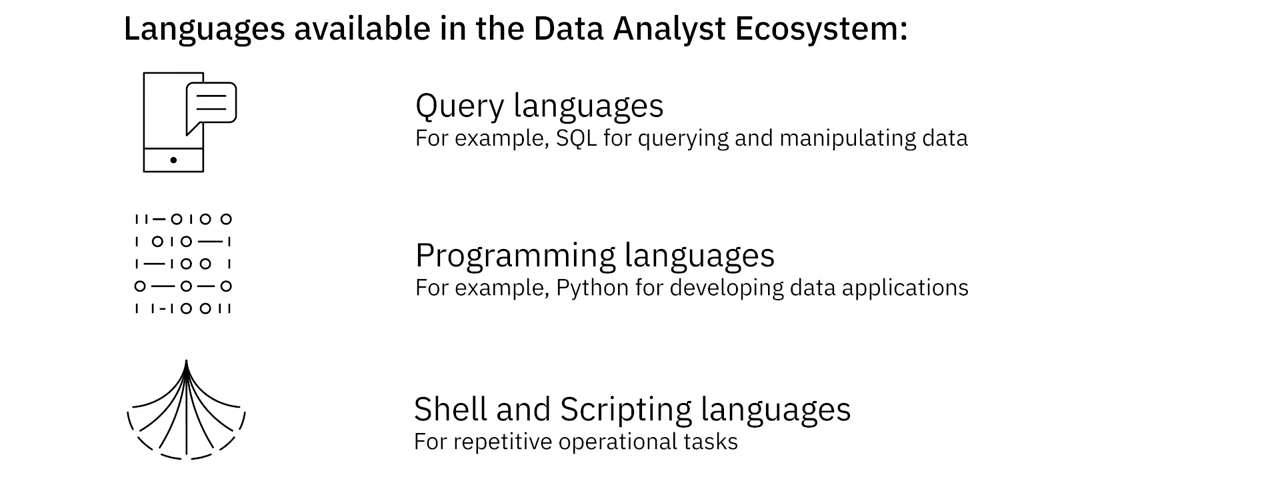
- 查询语言。
- 编程语言。
- Shell 和脚本语言。
👉 从使用 SQL 查询和操作数据,到使用 Python 开发数据应用,以及为重复性操作任务编写 Shell 脚本,这些都是数据工程师工作台中的重要组成部分。
商业智能 (BI) 与报告工具
- 用途: 用于从多个数据源收集数据,并以可视化格式呈现,例如交互式仪表板。
- 特性: 使用这些工具,您可以实时或按预定计划连接和可视化您的数据。这些是拖放式产品,用户无需了解任何编程。
- 角色协作: 尽管这些工具通常由数据分析师和商业智能分析师使用,但它们由数据工程师支持和管理。
自动化
- 自动化工具、框架和流程(用于数据分析过程的所有阶段)是数据工程师生态系统的一部分。
这是一个多样化、丰富且充满挑战的生态系统。在课程的后续部分,我们将更详细地探讨这个生态系统的不同组成部分。