Module 01 · Terminology and Epidemiology术语与流行病学
Rates, Rank, and Raw Data死亡率、排名与原始数据
1理解数据的关键:原始数据 vs. 死亡率 vs. 排名
在分析数据或数据可视化时,确保你清楚地理解所看到的数字及其含义是至关重要的。数据呈现方式通常有以下几种:
- 原始数字:仅是某一特定群体中因自杀死亡的人数。
- 死亡率:表示每10万人中有多少人死于自杀,这种方式有助于在不同人群之间进行比较。例如,比较白人美国人和亚裔美国人的自杀死亡率。
- 排名:呈现死亡原因的排序,展示自杀在某一群体中的死亡原因排名。
2原始数据与排名对比:青少年 vs. 中年人的死亡原因
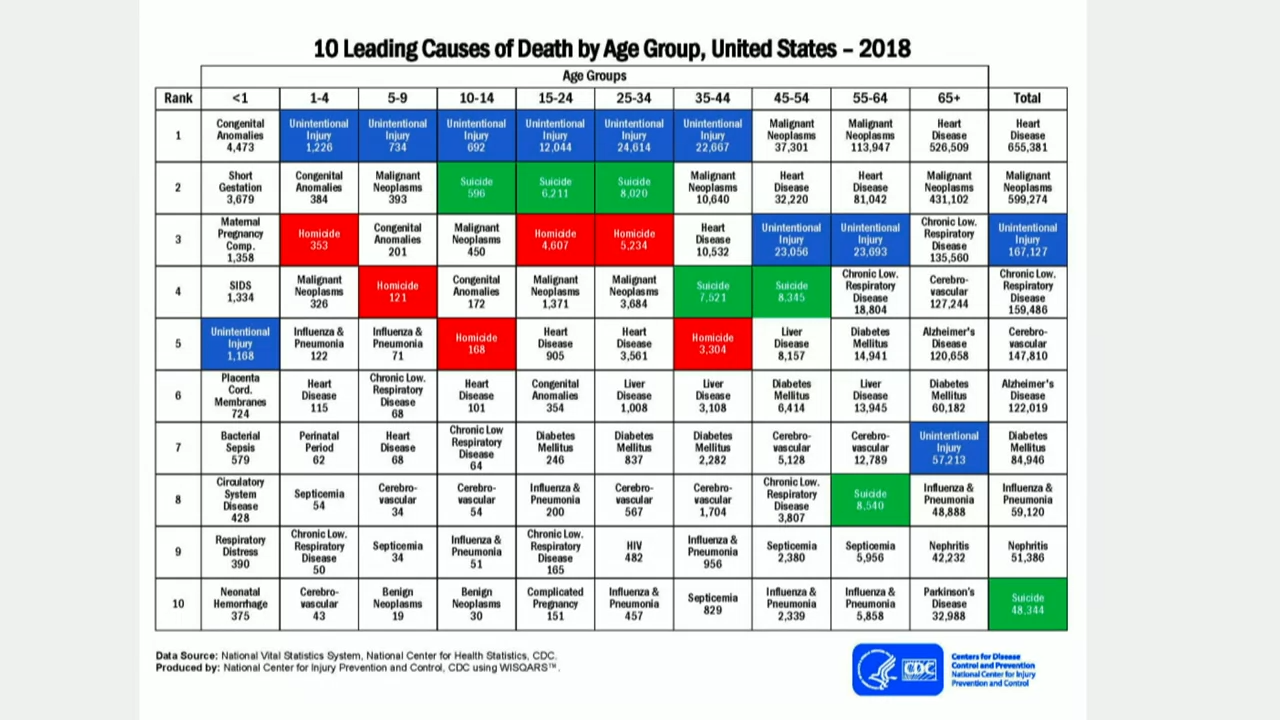
以下是一个展示原始数据和排名的表格:
| 年龄段 | 自杀死亡人数 | 该年龄段死亡原因排名 |
|---|---|---|
| 10-14岁 | 596人 | 第二大死亡原因 |
| 55-64岁 | 8,540人 | 第八大死亡原因 |
乍一看,可能会觉得有些困惑:55-64岁的群体中死亡人数远远高于10-14岁的群体,但其死亡原因的排名却低得多。这个现象的原因在于基准死亡率。
3基准死亡率的作用
- 青少年自杀:在10-14岁这个年龄段,死亡人数较少,然而自杀仍然是该年龄段的第二大死亡原因。
- 中年人自杀:在55-64岁的群体中,尽管自杀的死亡人数要多得多,但由于该年龄段患有更多影响健康的疾病(如心脏病、癌症、肝病等),自杀的死亡原因在所有死亡原因中的排名相对较低。
4资源配置的影响:如何选择关注重点
- 减少整体自杀死亡人数:如果目标是减少整体自杀死亡人数,我们可能会集中精力在老年人群体,因为他们占据了大量的自杀死亡比例。
- 减少青少年死亡原因排名靠前的自杀:如果目标是应对青少年死亡的主要原因,那么我们会把重点放在青少年和年轻人群体,尽管自杀的实际死亡人数在这个群体中相对较小。
总结
在使用数据时,并没有绝对的对与错。关键是确保你所使用的数据与所提出的问题或要表达的观点相匹配。理解不同数据呈现方式背后的含义,将有助于我们做出更加精准和合理的公共卫生决策。