Module 02 · From Understanding to Preparation and From Modeling to Evaluation
Data Preparation - Case Study从理解到准备:数据科学方法论 101 – 数据准备 (案例研究篇)
1. 阶段应用概述
数据准备在本质上类似于清洗刚采摘的蔬菜,旨在去除不需要的元素,如污垢或瑕疵。现在,我们来看看在案例研究中如何应用数据准备的概念。
在数据准备阶段,一个重要的首要步骤是精确定义充血性心力衰竭 (Congestive Heart Failure, CHF)。
- 定义复杂性:尽管这听起来很简单,但精确地界定它并非易事。
- 临床指导:首先,需要识别与 CHF 相关的诊断相关组 (DRG) 代码集,因为 CHF 意味着某种体液积聚。此外,还需考虑 CHF 只是心力衰竭的一种类型。因此,需要临床指导来获取正确的 CHF 代码。
2. 定义再入院标准与事件定序
再入院标准的界定
下一步涉及定义相同病情的再入院标准。
- 事件评估:需要评估事件的时间安排,以确定特定的 CHF 入院是初始事件(称为“起始入院”Index Admission),还是与 CHF 相关的再入院。
- 再入院窗口:基于临床专业知识,确定从初次入院出院后的 30 天为与 CHF 患者相关的再入院窗口期。
3. 事务性数据聚合与特征创建
数据的原始状态
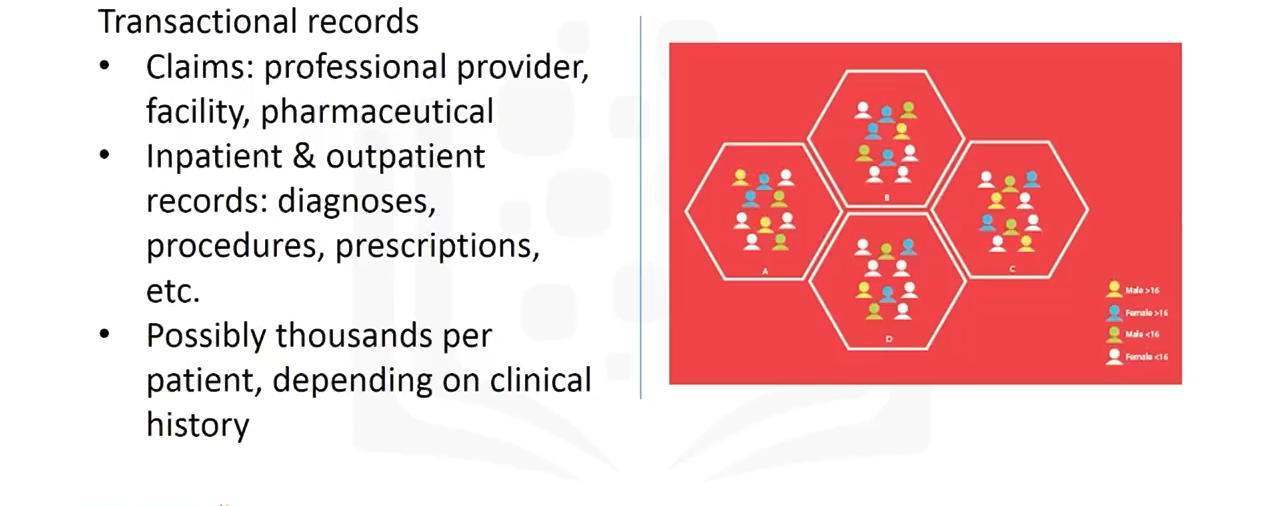
原始记录处于事务性格式,这意味着数据包含每位患者的多条记录。
- 事务性记录内容:
- 提交给医生、实验室、医院和临床服务的专业医疗服务提供者设施索赔记录。
- 描述所有诊断、程序、处方以及住院和门诊患者的其他信息的记录。
- 数据量:根据临床病史,单个患者很容易拥有数百甚至数千条此类记录。
聚合至患者级别
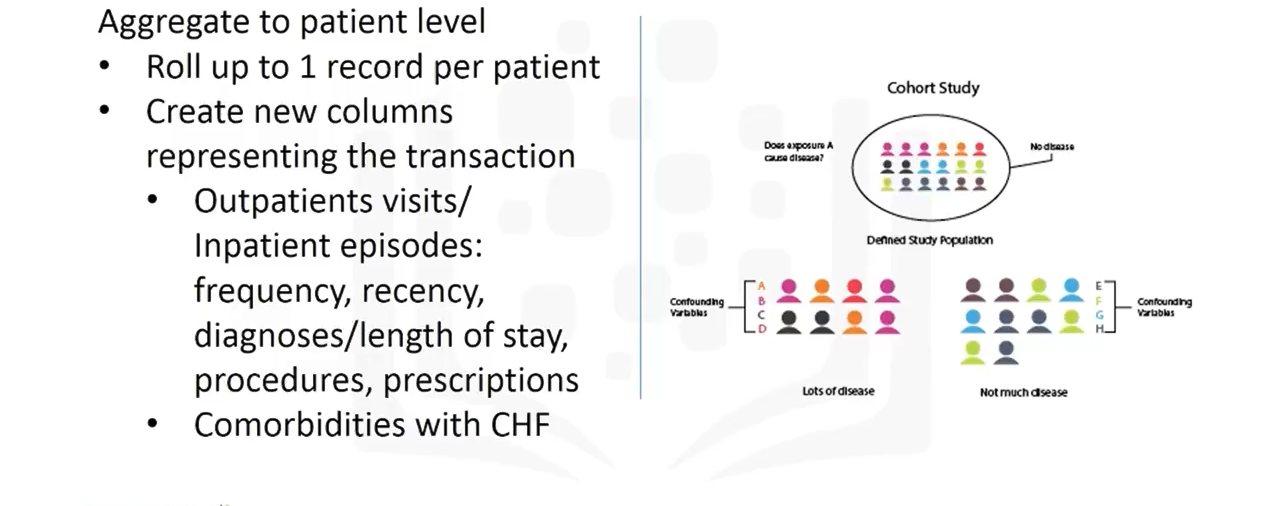
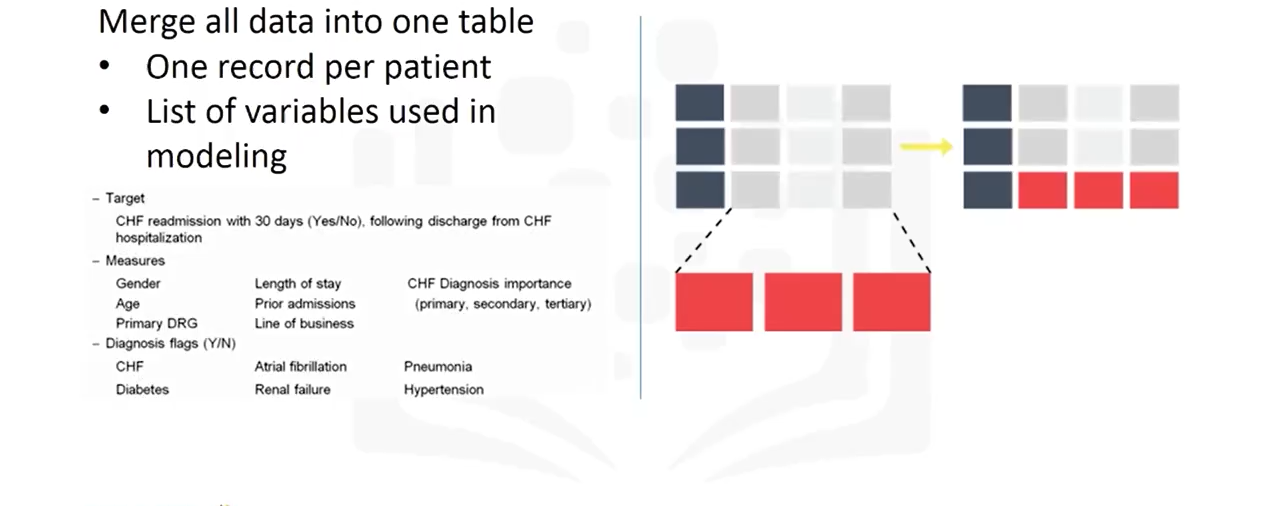
随后,所有事务性记录被汇总至患者级别,为每位患者生成单条记录,以满足建模所使用的决策树分类方法的要求。
特征工程与共病考虑
- 创建新列:作为汇总过程的一部分,创建了许多新列来表示事务中的信息。
- 例如:患者就诊医生、诊所和医院的频率和最近一次就诊时间,以及相关的诊断、程序、处方等。
- 共病考虑:还考虑了与 CHF 相关的共病 (Co-morbidities),如糖尿病、高血压,以及许多其他可能影响 CHF 再入院风险的疾病和慢性病。
4. 文献回顾与数据整合
文献回顾的作用
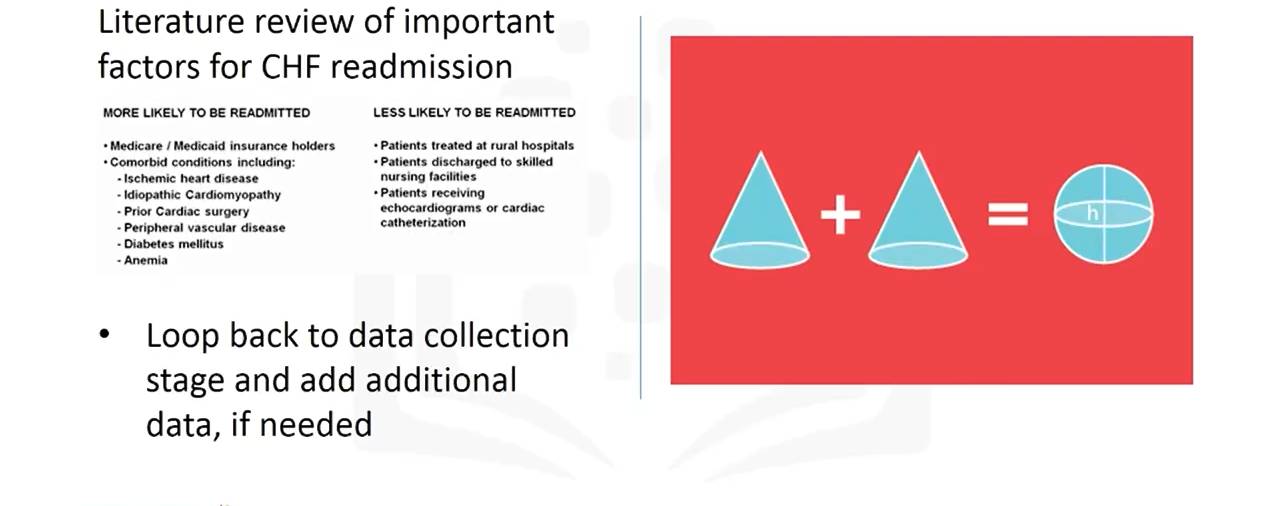
在围绕数据准备的讨论中,还进行了关于 CHF 的文献回顾,以查看是否遗漏了任何重要的数据元素,例如尚未考虑在内的共病。
- 流程循环:文献回顾涉及循环回到数据收集阶段,以添加更多关于病情和程序的指标。
数据整合与最终表格
- 合并数据:在患者级别汇总事务性数据,意味着将其与患者的其他数据进行合并,包括他们的人口统计信息(如年龄、性别、保险类型等)。
- 最终产出:最终创建了一张包含单条记录/患者的表格,其中许多列代表了该患者及其临床病史的属性。这些列将作为预测建模中的变量使用。
5. 模型变量与最终队列
最终用于构建模型的变量列表如下:
- 因变量/目标变量 (Dependent Variable/Target):在 CHF 住院出院后 30 天内是否因 CHF 再入院,结果为“是”或“否”。
最终队列的划分
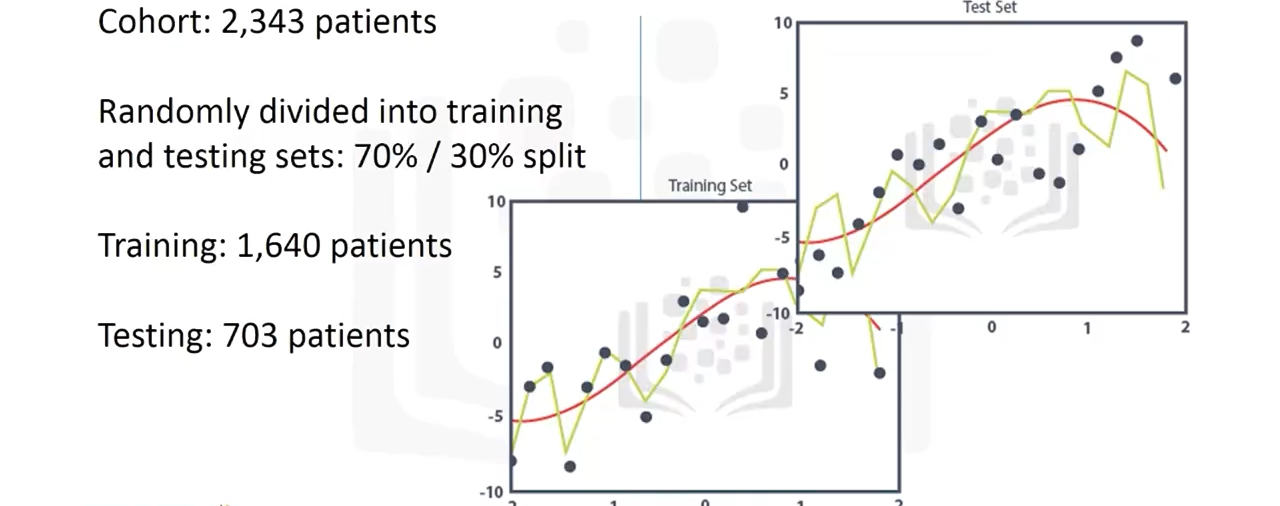
数据准备阶段最终得到了一个包含 2,343 名符合本案例研究所有标准的患者队列。
随后,该队列被拆分为训练集和测试集,分别用于模型的构建和验证。
感谢收看!本视频结束了课程中**“数据准备”**的部分,我们已将关键概念应用于案例研究。