Module 02 · From Understanding to Preparation and From Modeling to Evaluation
Modeling - Case Study从建模到评估:数据科学方法论 101 – 建模 (案例研究篇)
1. 建模阶段概述与调参目标
现在,我们将案例研究应用于数据科学方法论的建模阶段。在这里,我们将讨论模型构建的众多方面之一:参数调整以改进模型。
初始模型构建与表现
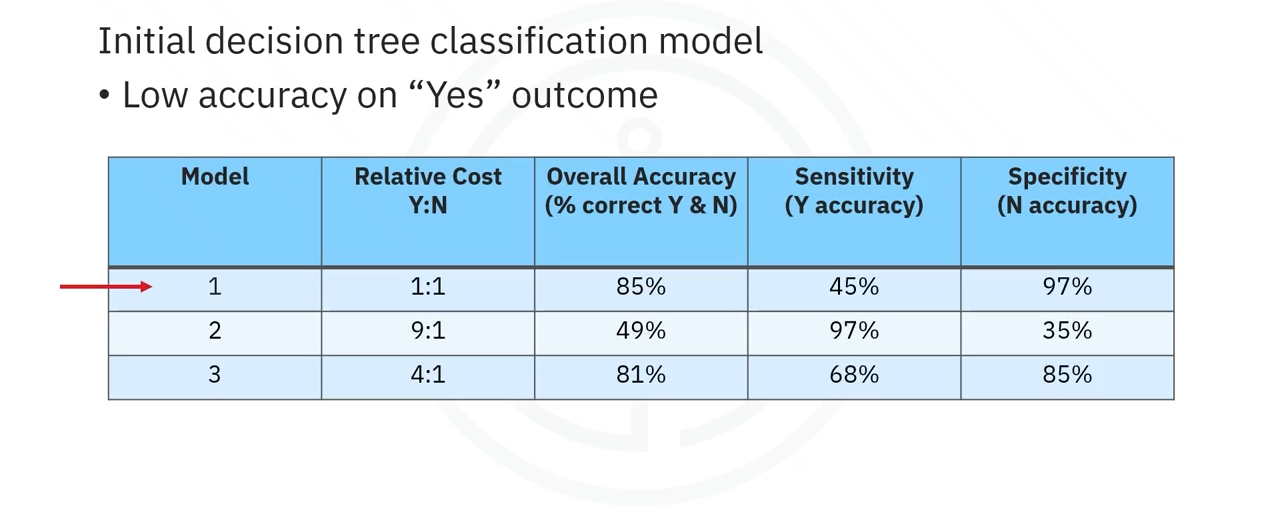
有了准备好的训练集,就可以构建第一个充血性心力衰竭 (CHF) 再入院的决策树分类模型。
- 关注目标:我们关注的是高风险再入院的患者,因此感兴趣的结果是 CHF 再入院等于**“是”**。
- 模型一表现:
- 总体准确率:85%。
- “是”结果的准确率 (召回率):仅 45% (即正确分类的实际再入院患者)。
- 问题:尽管总体准确率看似不错,但对**“是”**结果的预测准确率不高,这表明模型不够准确。
核心问题:如何提高模型预测**“是”**结果的准确率?
2. 参数调整:误分类成本的设定
对于决策树分类,最好的调整参数是误分类“是”和“否”结果的相对成本。
错误类型与成本分析
我们可以将两种不同类型的误分类错误及其成本进行对比:
| 错误类型 | 统计学名称 | 实际后果 | 错误成本 |
|---|---|---|---|
| 真“否”误分为“是” | 第一类错误 (Type I Error) 或伪阳性 (False-Positive) | 对本不会再入院的患者采取了干预措施。 | 干预措施的浪费。 |
| 真“是”误分为“否” | 第二类错误 (Type II Error) 或伪阴性 (False-Negative) | 未采取任何行动来降低再入院风险。 | 再入院及其所有相关成本,以及对患者的创伤。 |
显然,这两种误分类错误的成本可能截然不同。因此,调整误分类“是”和“否”结果的相对权重是合理的。
- 默认设置:权重默认为 1:1。
- 算法允许:决策树算法允许为**“是”**(即再入院)设置更高的值。
3. 迭代建模与平衡点寻找
模型二:极端权重调整 (9:1)
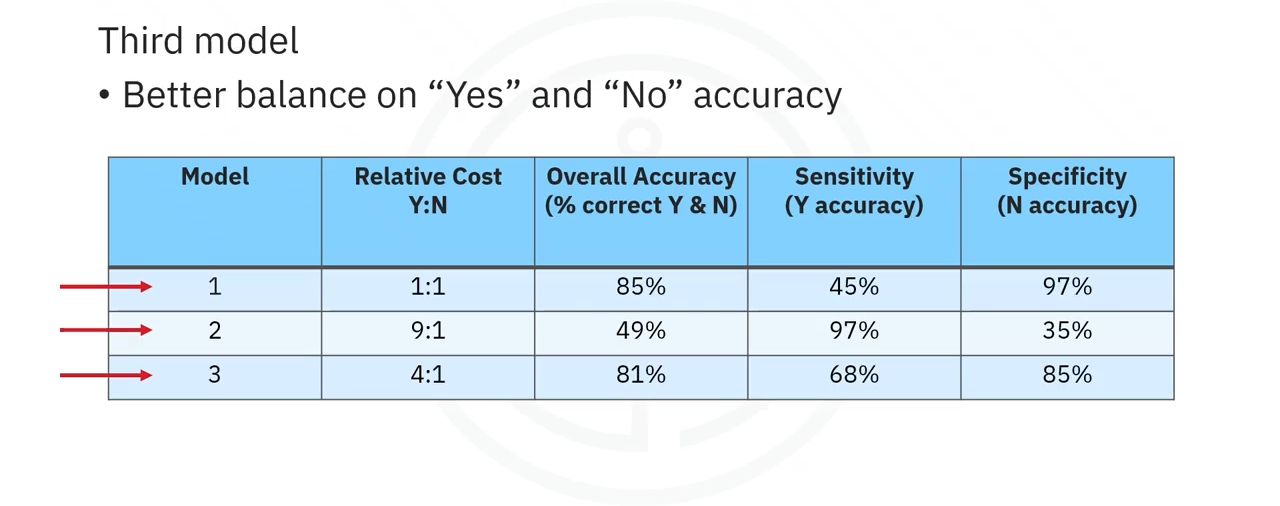
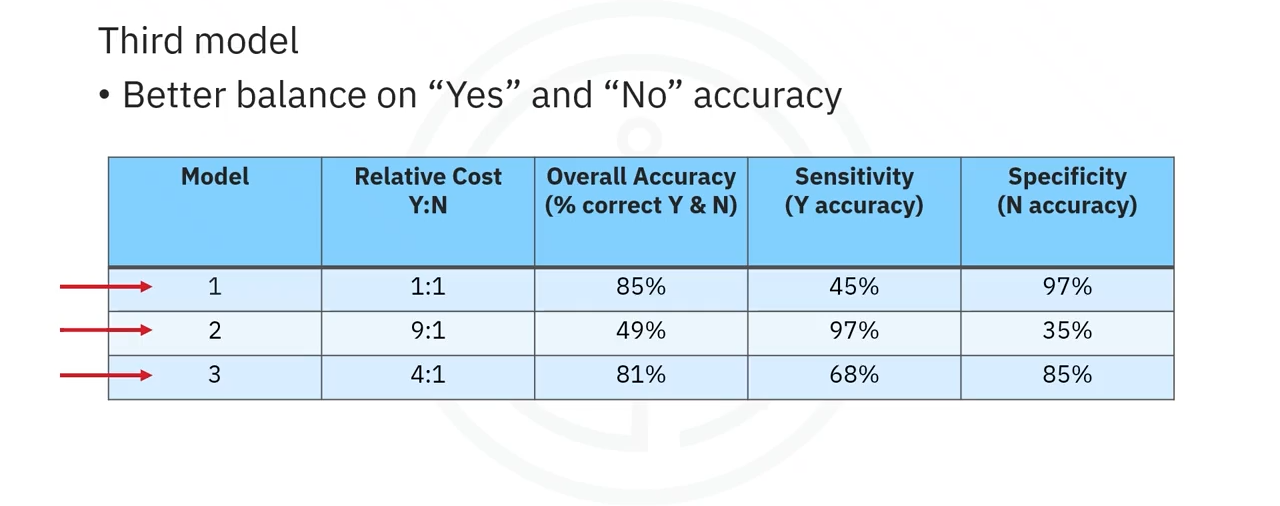
- 相对成本设定:设置为极高的 9:1。
- 模型表现:
- “是”结果的准确率:正确分类了 97% 的“是”结果。
- “否”结果的准确率:极低。
- 总体准确率:仅 49%。
- 问题:这是一个不好的模型。问题在于伪阳性 (False-Positives) 数量过多,这会导致对本不会再入院的患者推荐不必要且成本高昂的干预措施。
模型三:寻求最佳平衡 (4:1)
数据科学家需要重新尝试,以在“是”和“否”的准确率之间找到一个更好的平衡点。
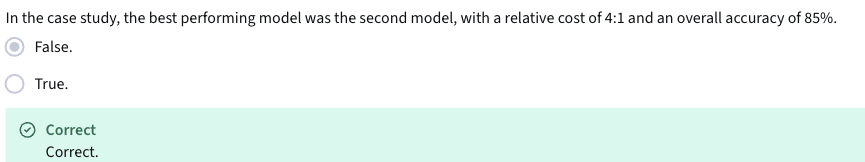
- 相对成本设定:设置为更合理的 4:1。
- 模型表现:
- “是”结果的准确率 (敏感度 Sensitivity):获得了 68% 的准确率。
- “否”结果的准确率 (特异度 Specificity):获得了 85% 的准确率。
- 总体准确率:81%。
通过调整误分类“是”和“否”结果的相对成本参数,这达到了一个在相对较小的训练集上能获得的最佳平衡点。
持续优化
当然,建模工作需要进行更多的工作,包括迭代回到数据准备阶段,以重新定义其他一些变量,从而更好地表示基础信息,并由此改进模型。
感谢收看!本视频结束了课程中**“建模”**的部分,我们已将案例研究应用于数据科学方法论的建模阶段。