Module 02 · From Understanding to Preparation and From Modeling to Evaluation
Data Understanding从理解到准备:数据科学方法论 101 – 数据理解
1. 数据理解阶段概述
数据理解 (Data Understanding) 涵盖了所有与构建数据集相关的活动。
本质上,数据科学方法论的数据理解阶段回答了核心问题:
您收集的数据是否代表了需要解决的问题?
2. 案例研究应用:描述性统计分析
为了理解与充血性心力衰竭 (CHF) 再入院相关的数据,需要对那些将成为模型变量的数据列运行描述性统计。
核心统计分析活动
- 单变量统计 (Univariates and Statistics):
- 运行 Hurst 和单变量统计,包括每个变量的均值 (mean)、中位数 (median)、最小值 (minimum)、最大值 (maximum) 和标准差 (standard deviation)。
- 成对相关性 (Pairwise Correlations):
- 用于查看某些变量之间的关联紧密程度。
- 识别其中高度相关的变量——这些变量本质上是冗余的,因此在建模时只需保留其中一个。
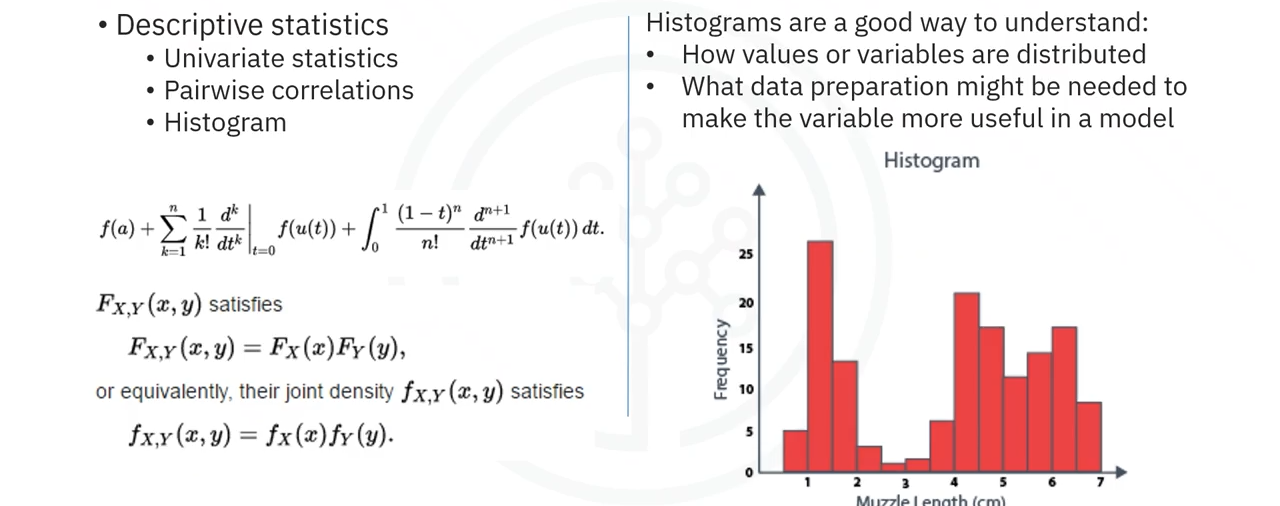
- 变量直方图 (Histograms):
- 检查变量的分布情况。
- 直方图是了解变量值如何分布的良好方式,有助于确定需要进行哪种数据准备,从而使变量在模型中更有用。
- 例如:对于一个具有过多不同值而无法在模型中提供信息的分类变量,直方图将帮助决定如何整合这些值。
3. 评估数据质量与缺失值处理
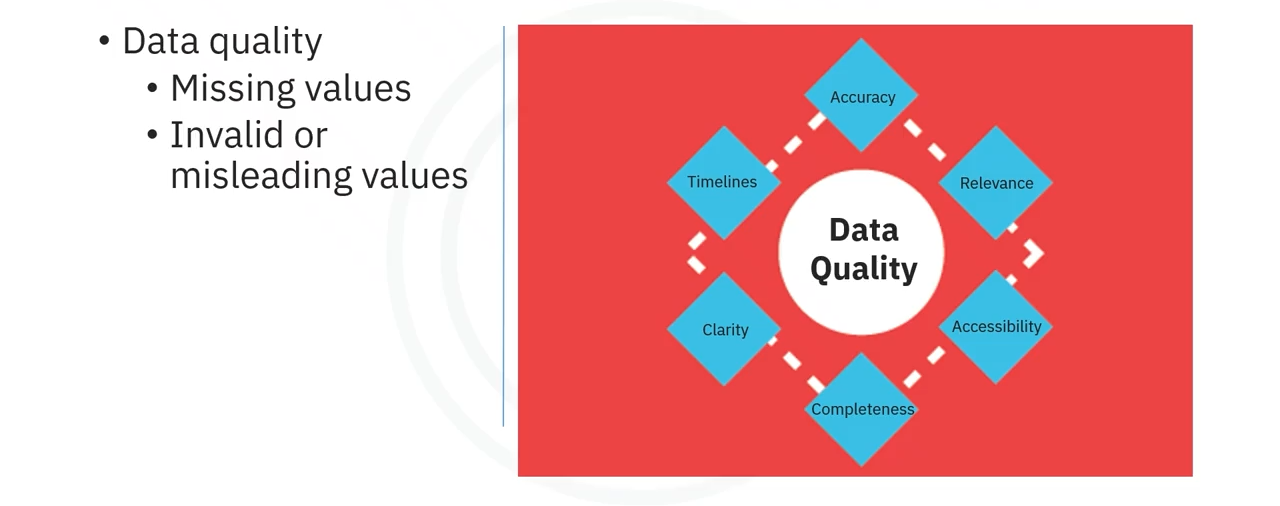
单变量统计、描述性统计和直方图也用于评估数据质量。
缺失值和无效值处理
根据所提供的信息,某些值可以被重新编码,或在必要时甚至删除(例如,当某个变量存在缺失值时)。
此时的关键问题是:“缺失”是否具有任何含义?
- 有时,缺失值可能表示**“否”或“0”**。
- 在其他情况下,它可能仅仅表示**“我们不知道”**。
此外,如果变量包含无效或误导性的值,也需要处理。
例如:一个名为“年龄”的数值变量,包含了0到100之间的值,但也包含999。如果999实际代表**“缺失”**,但在未纠正的情况下会被视为有效值,则必须对其进行修正。
4. 迭代与流程改进:反馈循环
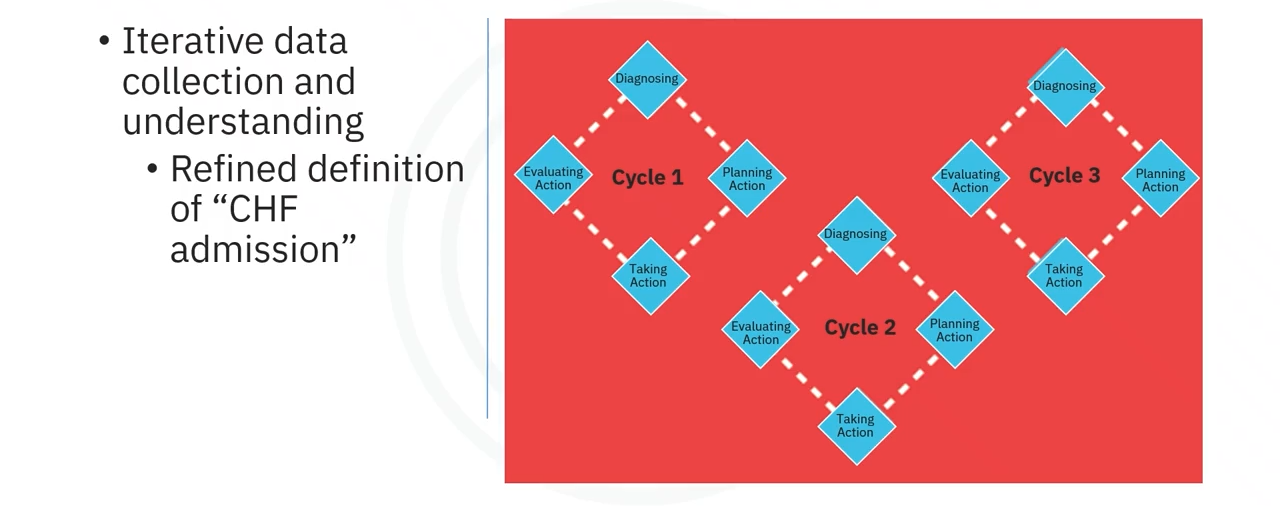
最初,充血性心力衰竭 (CHF) 入院的定义是基于原发性诊断为 CHF。
但在进行数据理解阶段的工作后发现,初始定义并未捕获所有预期中的、基于临床经验的 CHF 入院记录。
方法论的互动性
- 这意味着需要循环回到数据收集阶段。
- 需要添加次要和三级诊断信息,并建立一个更全面的 CHF 入院定义。
这是方法论中交互式过程的一个实例。一个人对问题和数据的处理越多,学到的东西就越多,因此模型中可以进行的优化就越多,最终将带来更好的问题解决方案。
感谢收看!本视频结束了课程中**“数据理解”**的部分。