Module 02 · Data Science Topics
Neural Networks and Deep Learning神经网络与深度学习:从理论到计算力驱动的突破
这段内容深入介绍了人工神经网络的原理,追溯了其一度失宠又因强大的计算能力而重新崛起的历史,以及它们在现代数据科学中的应用。
1. 神经网络的基础概念 (Neural Networks)
- 本质: 神经网络是计算机科学尝试模仿大脑神经元如何实际工作的程序。
- 结构: 拥有输入端,数据输入到不同的处理节点(neurons)中。这些节点进行转换和聚合,可能进入下一层节点,最终产生输出。
- 训练: 训练过程涉及不断地输入数据并观察输出,目的是调整网络中的转换方式,使其收敛(converge),从而使输入最终得到预期的输出(例如,识别手写数字)。
| 特点 | 描述 |
|---|---|
| 早期限制 | 尽管理论存在,并在小问题(如手写数字识别)上有效,但它们在计算上非常密集(computationally very intensive)。 |
| 结果 | 神经网络一度失宠,并被停止教授(大约 15 年前)。 |
2. 深度学习的崛起与计算力的爆发
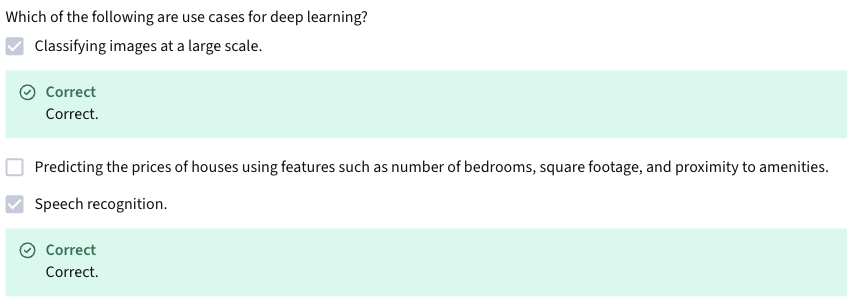
深度学习 (Deep Learning) 的定义
- 深度学习本质上是 “类固醇上的神经网络”(neural networks on steroids)。
- 它通过使用多层神经网络(multiple layers of neural networks),并投入大量计算能力来解决问题。
GPU 的关键作用
深度学习之所以能够重新流行并取得巨大成功,是因为现代硬件的进步,特别是 图形处理单元(GPU) 的应用:
- 计算需求: 神经网络需要进行海量的矩阵和线性代数计算。
- GPU 的优势: GPU 最初用于图形处理,但其架构天然适合这种并行、大规模的矩阵运算,使其成为运行深度学习模型的理想硬件。
- 实际应用规模: 某大学的研究计算中心正在安装数百台配备 GPU 的服务器,每台 GPU 相当于数百个处理核心,提供数万个处理核心专用于深度学习应用。
课堂演示:实时语音识别
一位在 NYU 教授深度学习课程(同时也是 Facebook 首席数据科学家)的教授,在课堂上使用一台内置 GPU的厚笔记本电脑,让学生对它说话。这台电脑可以实时训练一个神经网络来识别语音。
3. 深度学习的强大应用与未来方向
深度学习已经能够处理传统神经网络只能在微小规模上完成的任务,但现在可以处理极其庞大的问题:
- 感知与识别: 语音识别、人脸识别、图像分类(例如自动区分猫和狗)。
- 自主学习: 模型可以自主学习(learn on its own),不需要被明确告知对象的特征。
- 生成能力: 它可以生成听起来像学习说话的婴儿一样的语音。
基础数学与计算资源
- 重要数学基础: 深入理解深度学习需要掌握矩阵和线性代数,因为大量的转换都基于这些数学原理。
- 实际操作: 虽然现在有许多包可以自动处理所有的线性代数运算,但了解底层原理仍然重要。
- 硬件要求: 深度学习,特别是严肃的应用,需要高性能的计算能力,这不是在普通笔记本电脑上就能完成的任务,通常需要专门的计算资源。