Module 02 · Data Science Topics
Lesson Summary: Big Data and Data Mining大数据与数据挖掘
本课程回顾了大数据对社会各方面的影响,并深入探讨了其关键属性、挑战、云计算在处理大数据中的作用,以及数据挖掘的流程和常用工具。
1. 大数据基础与数字化转型
大数据的可用性正在推动商业和工业的转型,进而影响我们的日常生活。组织认识到,这需要对业务方法进行根本性变革,影响到组织的方方面面。
5V 特征:大数据的关键属性
尽管对大数据的确切定义存在分歧,但人们普遍认同其五个核心特征:
- 价值 (Value): 人们投入时间研究大数据的目的是为了从中创造价值(例如:利润、医疗或社会效益)。
- 数据量 (Volume): 数据的规模或存储量的增加。驱动因素包括可收集数据源的增加和可扩展的基础设施。
- 速度 (Velocity): 数据积累的速度。指不断增加的、不间断生成数据的源头和快速处理流程。
- 多样性 (Variety): 数据的多样化,数据来自不同的来源,包括结构化和非结构化数据。
- 真实性 (Veracity): 数据的质量和来源,及其对事实的符合和准确性。
2. 云计算在处理大数据中的作用
云和云技术的发展使我们能够处理大数据。云计算是以按需付费(pay-for-use)的方式交付按需计算资源。
云计算的五大特征
云计算的这些特性使其成为处理大数据的宝贵资源,解决了可扩展性、协作、可访问性和软件维护等挑战:
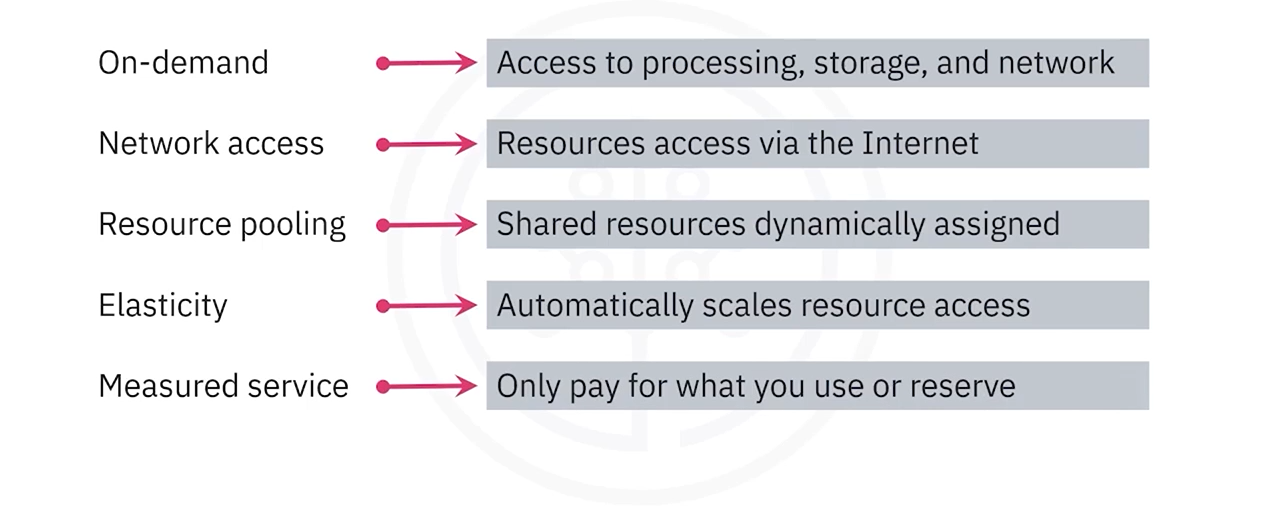
- 按需 (On-demand): 访问您需要的处理能力、存储和网络资源。
- 网络访问 (Network Access): 计算资源可以通过互联网进行访问。
- 资源池化 (Resource Pooling): 允许提供商动态分配资源以服务多个消费者,使云计算具有成本效益。
- 弹性 (Elasticity): 您可以在需要时访问资源,并在不需要时自动缩减规模。
- 可计量服务 (Measured Service): 您只为实际使用或预留的资源付费。
云服务还提供了即时访问各种技术的能力,无需本地安装或配置,并提供最新的工具版本。
3. 大数据处理工具
常用的开源大数据处理工具包括:
- Apache Hadoop: 提供分布式存储和处理工具,用于跨计算机集群进行大规模数据操作。
- Apache Hive: 是一种构建在 Hadoop 之上的数据仓库软件,用于数据查询和分析。它允许通过类似 SQL 的工具读取、写入和管理存储在 HDFS 等系统中的大型数据集。
- Apache Spark: 提供一个通用数据处理引擎,旨在提取和处理大量数据,适用于交互式分析、流处理、机器学习等多种应用。
4. 数据挖掘过程
要利用大数据,需要一个被称为数据挖掘的六步过程。这个过程本质上是迭代的,每次迭代的结果都会为进一步的数据挖掘工作提供信息。
| 步骤 | 目标与操作 | 关键考量 |
|---|---|---|
| 1. 目标设定 (Goal Setting) | 确定您想要回答的关键问题。 | 成本和效益应指导此步骤。 |
| 2. 选择数据源 (Selecting Data Sources) | 识别数据来源或规划数据收集活动。 | 确保选择的数据能够回答既定问题。 |
| 3. 预处理 (Preprocessing) | 识别数据中不相关的属性和错误/不准确的方面,并进行标记。 | 确保数据的质量和适用性。 |
| 4. 转换 (Transforming) | 确定合适的数据存储格式。 | 调整数据结构以适应后续的分析方法。 |
| 5. 挖掘 (Mining) | 确定要使用的分析方法和机器学习算法来处理数据。 | 根据数据和目标选择最有效的算法。 |
| 6. 评估 (Evaluation) | 测试模型在观察数据上的预测能力,以评估算法的有效性和效率。 | 与利益相关者分享结果。 |