Module 03 · Introducing Apache Cassandra: An Open-Source NoSQL Database
Practice Quiz: Cassandra Basics练习测验:Cassandra 基础
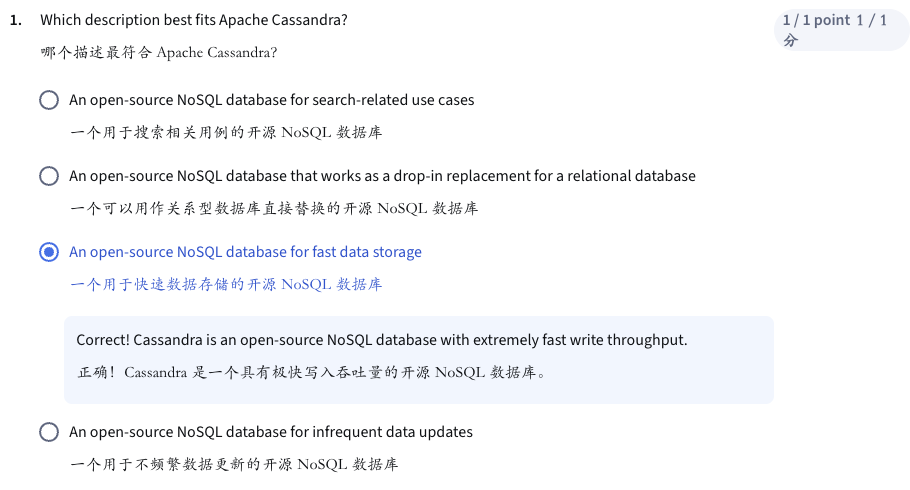
首先明确一点:Cassandra的核心设计目标之一就是实现极高的写入吞吐量。它在这方面表现卓越,根本原因在于其写入路径的极致优化。
现在我们来逐一分析每个选项:
选项分析
B. By having no read before write by default(通过默认情况下禁止先读后写)
- 技术深入解析(正确选项):
- 这是最直接、最核心的原因。在传统的关系型数据库中,执行一个
UPDATE(更新)操作时,系统通常需要先执行一个SELECT(读取)操作来找到要更新的数据行及其当前位置(这个过程可能涉及索引查找等),然后再执行写入。这个“先读后写”的模式会带来额外的磁盘I/O和延迟,成为写入性能的瓶颈。 - Cassandra采用了日志结构合并树(LSM-Tree) 的存储模型。它的写入操作极其简单粗暴:
- 追加写入(Append-only):任何写入(无论是INSERT还是UPDATE)都被视为一个新的数据版本,直接追加(Append) 到内存中的数据结构(Memtable)和磁盘上的提交日志(Commit Log) 中。提交日志是顺序写入的,速度极快。
- 无需查找:它不需要先去查找旧数据在哪里。UPDATE操作并不是去原地修改旧数据,而是简单地写入一条带有新时间戳的新记录。
- 这种设计使得写入路径非常短,避免了昂贵的寻址操作,极大地提升了吞吐量。
- 这是最直接、最核心的原因。在传统的关系型数据库中,执行一个
- 通俗理解:
- 想象一下在笔记本上做记录。传统数据库就像是你有一本写满的账本,要修改某一笔账,你得先翻到那一页(读),然后涂改或备注(写)。而Cassandra就像是你有一个永远只写在最后一页的流水账本,任何修改都直接作为一条新记录写在最后面,根本不需要翻前页。哪种方式更快?显然是后者。
A. By reconciling data as it is appended and flushed to disk(通过在数据追加并刷新到磁盘时进行协调)
- 技术深入解析(部分正确,但非主要原因):
- 这个选项描述的是Cassandra的压缩(Compaction) 过程。当内存中的Memtable写满后,会被刷新(Flush)到磁盘,形成一个个不可变的SSTable文件。
- 由于多次写入,同一个数据的不同版本会分散在多个SSTable中。后台的压缩进程会协调(合并)这些SSTable,合并重复的数据,并只保留最新版本(基于时间戳)。
- 这个过程对于维持长期读取性能和清理过期数据至关重要,但它是一个后台异步操作,不是为了提升即时写入吞吐量而设计的。写入的高吞吐量在数据进入Memtable和Commit Log时就已经实现了,压缩是后续的维护工作。
- 通俗理解:
- 这就像是你用上面说的“流水账法”记账,账本(磁盘)会越来越厚。Cassandra会定期雇一个会计(压缩进程)来帮你把账本重新誊写一遍,合并重复条目,让账本变得整洁,便于以后查账(读操作)。但这个整理工作不影响你平时飞快地记新帐(写操作)。
C. By favoring consistency of write throughput over availability(通过优先考虑写入吞吐量的数据一致性而非可用性)
- 技术深入解析(错误选项):
- 这个选项混淆了概念。Cassandra基于CAP理论,默认配置下优先考虑的是可用性和分区容错性(AP),而不是强一致性(C)。
- 写入吞吐量高和一致性级别是可配置的、正交的两个概念。你可以为了高吞吐量而配置为弱一致性(如
ONE级别),也可以为了强一致性而牺牲一些吞吐量(如QUORUM或ALL级别)。 - 高写入吞吐量的核心源于其LSM-Tree架构和无读写入,而不是通过牺牲某种特性换来的。这个选项的表述本身就不符合Cassandra的设计哲学。
- 通俗理解:
- 这就像说“因为这辆车油漆好所以它跑得快”,因果关系不对。车的速度快是因为发动机和变速箱(LSM-Tree架构),而你可以选择开快车但比较颠簸(弱一致性高吞吐),也可以选择开得稳一点但慢一些(强一致性低吞吐)。油漆(一致性/可用性权衡)和速度(吞吐量)是两种不同的特性。
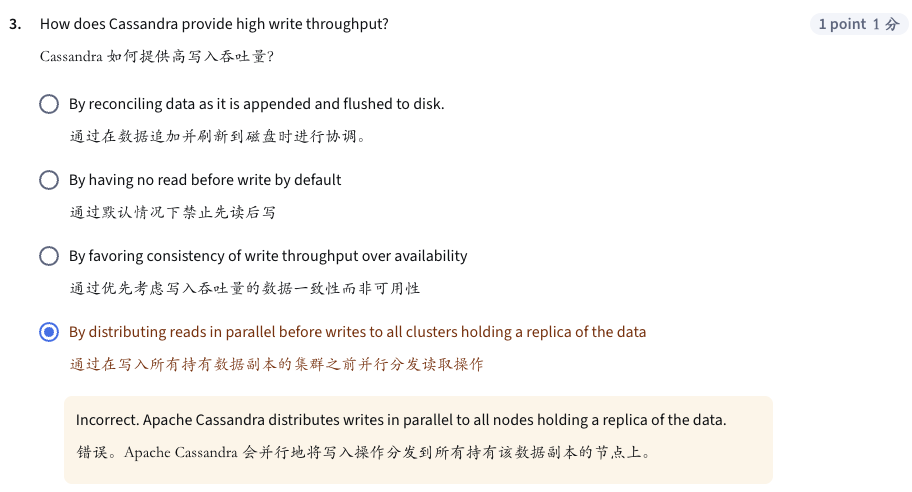
D. By distributing reads in parallel before writes to all clusters holding a replica of the data(通过在写入所有持有数据副本的集群之前并行分发读取操作)
- 技术深入解析(完全错误):
- 这个描述本身就是反逻辑的。写入操作 的流程是:客户端连接到一个协调者节点,协调者根据分区键和副本策略,将写入请求并发地发送到所有相关的副本节点。
- 这里描述的是“在写入之前先并行读取”,这完全不是Cassandra的标准写入流程。这种“先读后写”的模式正是Cassandra极力避免的(见选项B的解释),因为它会严重拖慢写入速度。
- 只有在一些非常特殊的场景下,如使用了轻量级事务(LWT)的
IF NOT EXISTS或IF条件时,才会在写入前进行读取,但这会显著降低性能,并非默认行为。
- 通俗理解:
- 这相当于说“为了让送货员送包裹更快,我们先派另一批人去所有客户家里问一遍要不要收包裹,然后再让送货员出发”。这非但不会加快速度,反而会让整个过程变得极其缓慢和低效。真正的做法是送货员拿着包裹直接并发送往各个客户家(分布式并发写入)。
结论与考点关联
- 正确答案:B
- 作为系统架构分析师,需要掌握的要点:
- 深入理解LSM-Tree:这是现代很多NoSQL和存储系统(如Bigtable, HBase, LevelDB/RocksDB)实现高写入吞吐的基石架构。理解其“内存缓冲 + 顺序日志 + 后台合并”的工作机制是关键。
- 区分核心机制与辅助机制:选项B是核心机制(无读写入),选项A是辅助的维护机制(压缩)。要能清晰区分什么是实现核心目标的关键路径。
- 理解CAP与可调一致性:Cassandra的灵活性在于其可调的一致性级别,这要求架构师能根据业务场景(如是日志记录还是金融交易)在吞吐量和一致性之间做出正确的权衡和配置。
- 辨别错误描述的陷阱:选项D是一个典型的逻辑陷阱,将读取和写入的流程错误地组合在一起。在实际架构设计中,需要警惕这种对流程的错误理解。