Module 03 · Introducing Apache Cassandra: An Open-Source NoSQL Database
Apache Cassandra Keyspace OperationsApache Cassandra 键空间操作
欢迎观看关于 Apache Cassandra 键空间操作 的视频。在本视频中,您将能够:
- 描述 键空间 在 Apache Cassandra 中的作用,
- 描述 复制因子 和 复制策略,
- 创建、修改和删除 键空间。
键空间概述
在 Cassandra 中,键空间 是一个逻辑容器,包含一个或多个表。在创建表之前,必须先定义键空间,因为 Cassandra 没有默认的键空间。一个键空间可以包含任意数量的表,但每个表只能属于一个键空间。
复制设置
键空间级别定义了 复制因子 和 复制策略。复制因子决定了数据副本的数量,而复制策略决定了副本分布在哪些集群节点上。创建键空间时,您需要指定这两个参数,但之后可以修改复制因子。
创建键空间
例如,要创建一个名为 intro_cassandra 的键空间,您可以在 CQL 中使用以下命令:
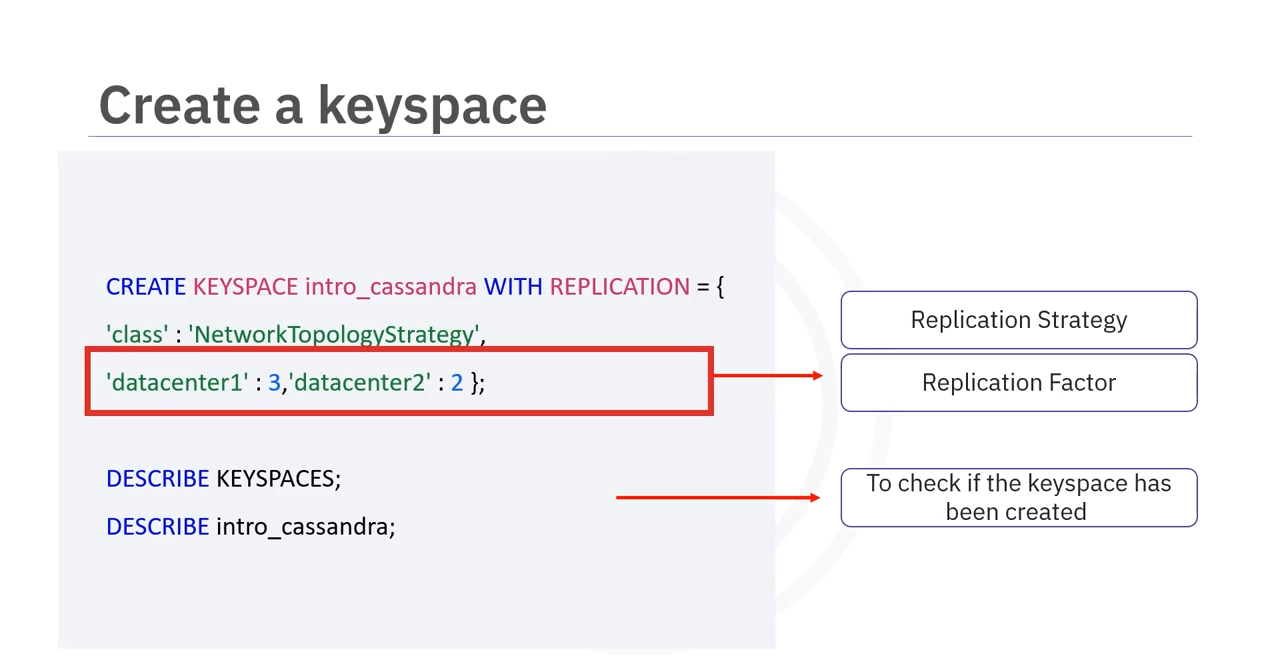
CREATE KEYSPACE intro_cassandra
WITH replication = {'class' : 'NetworkTopologyStrategy', 'datacenter1' : 3, 'datacenter2' : 2};
这将创建一个键空间,其中:
- 复制策略:使用
NetworkTopologyStrategy,适用于生产环境中的多数据中心部署。 - 复制因子:在
datacenter1中复制 3 个副本,在datacenter2中复制 2 个副本。
您可以使用 DESCRIBE KEYSPACES 或 DESCRIBE <keyspace_name> 来检查键空间是否已创建。
复制因子与复制策略
复制因子
复制因子 指定了每个数据的副本数量。它在键空间级别进行设置,并在数据分布时起作用。
复制策略
复制策略 确定了数据副本在集群中的位置。常见的策略是:
- NetworkTopologyStrategy:用于多数据中心的部署,确保每个数据中心有一定数量的副本。
- SimpleStrategy:适用于单数据中心的部署,不推荐用于生产环境。
示例:多数据中心中的数据分布
假设我们有一个包含两个数据中心的集群,复制因子为 5。在 datacenter1 中,复制因子为 3,datacenter2中,复制因子为 2。数据分布的流程如下:
- 数据首先根据 分区键 被哈希,并分配到集群中的节点。
- 然后,根据 复制因子 和 复制策略,数据会被复制到其他节点。
- datacenter1 中,数据的副本会按照节点的机架分布策略进行分配。
- 数据会被复制到 datacenter2 中,确保每个数据中心有足够的副本。
修改和删除键空间
修改键空间
要修改现有键空间的 复制因子,可以使用 ALTER KEYSPACE 命令。例如:
ALTER KEYSPACE intro_cassandra
WITH replication = {'class' : 'NetworkTopologyStrategy', 'datacenter1' : 3, 'datacenter2' : 3};
这将增加 datacenter2 中的复制因子,从 2 改为 3。
删除键空间
使用 DROP KEYSPACE 命令可以删除一个键空间及其所有表和数据:
DROP KEYSPACE intro_cassandra;
在删除之前,Cassandra 会默认对键空间进行快照,以便在需要时恢复数据。
总结
通过本视频,您学习了:
- 键空间 是 Cassandra 中用于定义表的逻辑容器,一个键空间可以包含多个表。
- 复制因子 和 复制策略 决定了数据如何分布和复制。
- 使用 CREATE KEYSPACE 创建键空间,使用 ALTER KEYSPACE 修改键空间,使用 DROP KEYSPACE 删除键空间。
这些操作帮助您管理 Cassandra 中的数据分布和复制,确保数据的高可用性和一致性。
1. Keyspace的核心概念与类比
通俗理解:
Keyspace在Cassandra中类似于关系型数据库中的"数据库"(Database)概念。它是一个逻辑容器,用于组织和管理多个表(Table)。在创建任何表之前,必须先定义Keyspace,因为Cassandra没有默认的Keyspace。
技术深入:
- 命名空间隔离:Keyspace提供了逻辑上的数据隔离,不同Keyspace下的表可以具有相同的名称而不会冲突。
- 元数据管理:Keyspace的配置(如复制策略、复制因子)作为元数据存储在系统表中,影响其下所有表的物理存储和分布。
2. 复制因子(Replication Factor)与复制策略(Replication Strategy)
通俗理解:
- 复制因子(RF):指定数据副本的数量。例如RF=3表示每份数据会在集群中保存3个副本,以提高可用性和耐用性。
- 复制策略:决定这些副本具体存储在哪些节点上。常见策略有:
- SimpleStrategy:适用于单数据中心,简单按令牌环顺序放置副本。
- NetworkTopologyStrategy:适用于多数据中心,考虑机架和数据中心拓扑,避免单点故障。
技术深入:
- 数据分布原理:
- 数据首先通过分区键的哈希值分配到令牌环上的某个节点(初始副本)。
- 然后根据复制策略和复制因子,在环上顺时针查找其他节点放置额外副本。
- 机架感知:NetworkTopologyStrategy会避免将多个副本放在同一机架,即使节点故障或机架断电,数据仍可访问。
- 生产环境建议:必须使用NetworkTopologyStrategy,因为它支持多数据中心部署和机架感知,符合高可用架构要求。
3. 多数据中心复制示例解析
案例技术分析:
假设有两个数据中心(DC1和DC2),RF=5(DC1为3,DC2为2):
- 初始分配:数据分区P通过哈希计算,可能落在DC1的节点1和DC2的节点5上。
- 副本放置:
- 在DC1内,从节点1开始顺时针查找,考虑机架分布,选择节点3和节点4(避免与节点1同机架)。
- 在DC2内,从节点5开始顺时针查找,选择节点7(不同机架)。
- 最终分布:副本分布在节点1、3、4(DC1)和节点5、7(DC2),共5个副本。
架构师视角:
- 容灾与延迟:多数据中心复制支持地理冗余,用户可就近访问本地数据中心,降低延迟。
- 一致性权衡:Cassandra提供可调一致性,如QUORUM计算需跨数据中心,架构师需根据业务需求权衡一致性与可用性。
4. Keyspace操作与运维影响
创建(CREATE KEYSPACE):
- 必须指定名称、复制策略和复制因子。
- 示例CQL:
CREATE KEYSPACE intro_cassandra
WITH replication = {
  'class': 'NetworkTopologyStrategy',
  'datacenter1': 3,
  'datacenter2': 2
};
修改(ALTER KEYSPACE):
- 主要用于调整复制因子(如将RF从5增加到6)。
- 注意:增加RF会触发数据流(streaming),集群需重新分布数据,期间可能影响性能。
删除(DROP KEYSPACE):
- 删除Keyspace会级联删除其下所有表和数据。
- 安全机制:Cassandra自动先快照(snapshot)数据,防止误操作,支持后续恢复。
5. 系统架构中的设计考量
- 容量规划:RF增加会提升数据冗余度,但也增加存储成本。架构师需根据业务重要性设计RF(通常RF=3)。
- 拓扑设计:复制策略需匹配物理基础设施(如机架、数据中心),避免单点故障。
- 运维风险:修改Keyspace配置(如RF)是在线操作,但可能影响集群性能,需在低峰期执行。
- 数据恢复:DROP前的自动快照提供了灾备能力,但架构师仍需确保备份策略完备。
总结
Keyspace是Cassandra数据管理的顶层逻辑单元,其复制配置直接决定了数据的可靠性、可用性和分布模式。作为架构师,需深入理解复制策略与因子的影响,结合基础设施拓扑设计Keyspace,并在运维中谨慎操作变更。这些知识对构建高可用、可扩展的分布式系统至关重要。