Module 03 · Introducing Apache Cassandra: An Open-Source NoSQL Database
Graded Quiz: Cassandra Basics评分测验:Cassandra 基础
首先,明确Cassandra的核心设计原则:它是一个去中心化、对等(Peer-to-Peer) 的分布式系统,旨在实现线性可扩展性和高可用性。它的数据分布机制是实现这些目标的基石。
选项分析
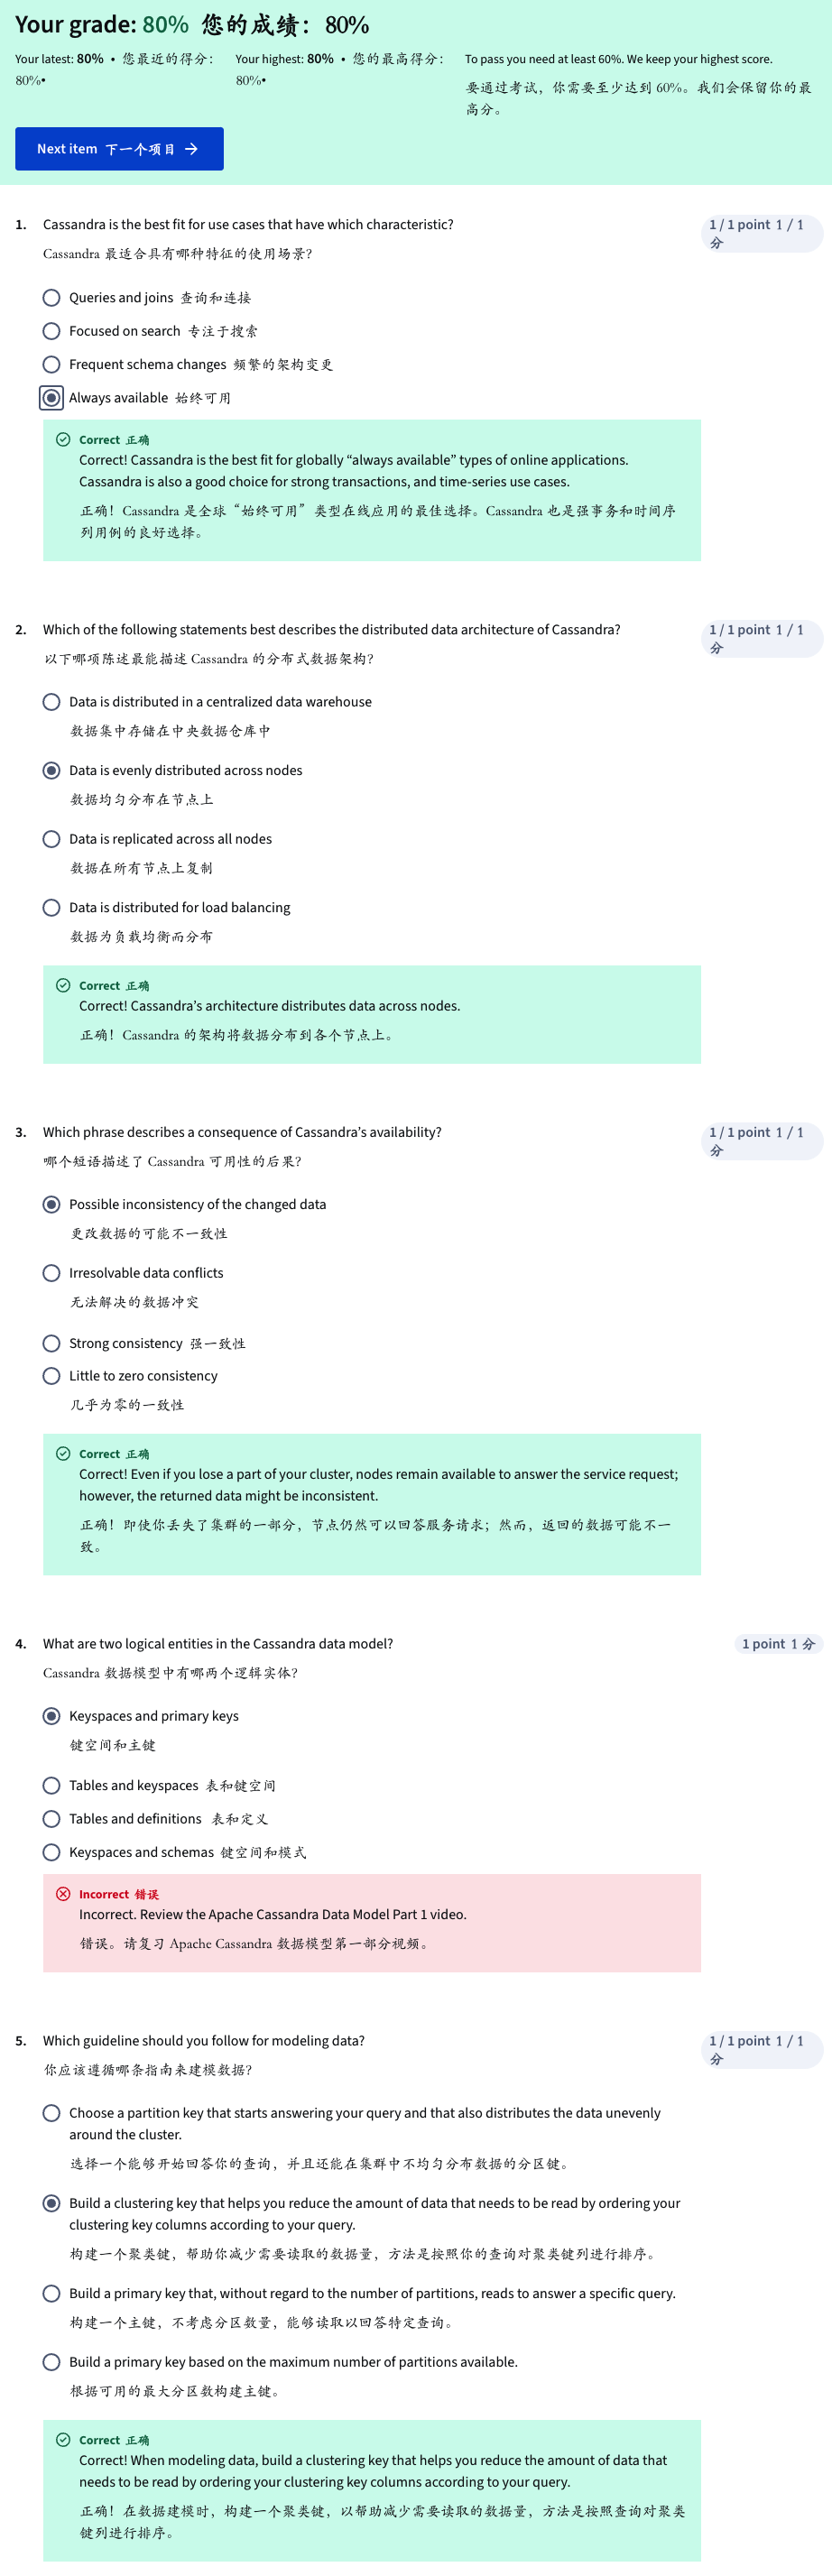
B. Data is evenly distributed across nodes(数据均匀分布在节点上)
- 技术深入解析(最准确选项):
- 这是对Cassandra架构最本质、最核心的描述。其背后的关键技术是:
- 一致性哈希(Consistent Hashing):整个集群的节点环(Ring)是一个哈希值范围。每个数据行(Row)的分区键(Partition Key)通过一个哈希函数(默认是Murmur3)计算出一个哈希值,这个值决定了该数据在环上的位置,从而决定了它由哪个主节点(负责的节点) 存储。
- 虚拟节点(VNodes):一个物理节点不再只负责环上的一个位置,而是被分配了成百上千个虚拟节点(Token),随机散布在整个环上。这带来了两大好处:
- 自动负载均衡:数据会自动、均匀地分布到集群中的所有物理节点,避免了手动计算和分配Token的麻烦,也避免了“热点”问题(即某些节点负载过重)。这正是“均匀分布”的实现手段。
- 简化运维:添加或移除节点时,数据会在多个节点间并行传输,而不是只与环上的相邻节点交换数据,操作更快,对集群影响更小。
- 因此,Cassandra的架构主动地、有意识地将数据均匀分布作为其核心设计,以实现最佳的扩展性和性能。
- 这是对Cassandra架构最本质、最核心的描述。其背后的关键技术是:
- 通俗理解:
- 想象一个巨大的圆形餐桌(哈希环),桌上有很多个固定位置的菜盘(虚拟节点)。每道新菜(数据)根据其名字(分区键)算出一个编号,然后被放到对应编号的菜盘里。服务员(物理节点)负责管理多个随机分布的菜盘。这样保证了每个服务员负责的菜量大致相同,没有谁特别忙或特别闲。这就是“均匀分布”。
D. Data is distributed for load balancing(数据为负载均衡而分布)
- 技术深入解析(正确,但不够根本和精确):
- 这个说法没错,但它描述的是目的或结果,而不是对架构本身的直接描述。负载均衡是均匀分布带来的一个关键好处。
- 作为架构师,我们需要区分“机制”和“策略/目标”。选项B描述了机制(如何分布),而选项D描述了目标(为何要这样分布)。
- 在考试中,选择最直接、最本质的描述通常是最佳策略。
- 通俗理解:
- 均匀分布菜(数据)是为了让每个服务员(节点)的 workload(负载)均衡。但题目问的是“餐桌的摆菜规则是什么”,而不是“为什么要这样摆菜”。规则是“均匀摆”(B),目的是“为了不让服务员累着”(D)。
C. Data is replicated across all nodes(数据在所有节点上复制)
- 技术深入解析(错误):
- 这是对“复制”机制的严重误解。Cassandra使用副本因子(Replication Factor, RF) 来控制数据的副本数量。例如,RF=3意味着每份数据会有3个副本,存储在环上的3个不同节点上(由复制策略决定)。
- 它绝不会默认将所有数据复制到所有节点。如果这样做,集群将完全无法扩展——每个节点的存储成本和网络压力都会随着集群规模增大而线性增长,这与分布式系统的设计目标背道而驰。
- 只有在极端情况下(如一个非常小的集群,RF配置得等于节点数),才可能实现“所有节点都有所有数据”,但这绝非其标准架构。
- 通俗理解:
- 这相当于要求每个服务员都必须记住所有菜的做法。餐厅越大,服务员越累,根本开不成连锁店。正确的做法是(RF=3时),每道菜只需要3个服务员会做,其他服务员可以不会。
A. Data is distributed in a centralized data warehouse(数据集中存储在中央数据仓库中)
- 技术深入解析(完全错误):
- 这个描述与Cassandra的去中心化架构完全相反。Cassandra没有单点或中央节点,所有节点角色对等(Peer-to-Peer),既是数据节点,也随时可以作为客户端请求的协调者节点。
- “中央数据仓库”是传统单体架构或主从复制架构(如MySQL主从)的特点,存在单点性能和故障风险,无法实现Cassandra所追求的线性扩展和高可用。
- 通俗理解:
- 这就像说“所有菜都从一个中央厨房做出来再分发给各个分店”,而Cassandra是“每个分店都有自己的厨房,各自做自己负责的菜,并互相备份”。
结论与考点关联
- 最佳答案:B
- 作为系统架构分析师,需要掌握的要点:
- 核心机制优先于衍生优势:在选择题中,要能识别出对架构原理的直接描述(B),而不是对其带来的好处(D)的描述。
- 深入理解一致性哈希与虚拟节点:这是解决分布式系统数据分片和负载均衡问题的经典模式。Cassandra通过VNodes对其进行了优化和实践,这是其架构的精髓之一。
- 清晰区分“复制”与“全量复制”:理解副本因子(RF)的概念至关重要。分布式系统中的复制是为了容错和读性能,但必须在可扩展性的约束下进行。
- 坚定“去中心化”设计思想:对于现代分布式系统架构,去中心化、无单点故障是基本要求。要能快速识别出与此相悖的描述(如选项A)。
这道题考察的是你对Cassandra最核心的分布式设计思想的把握。选项B准确地抓住了其数据分布的本质特征。
Cassandra的数据模型借鉴了关系数据库的一些概念,但为其分布式、宽列(Wide-Column)的特性做了重新设计。理解其逻辑结构是进行数据建模和系统设计的基础。
核心概念分析
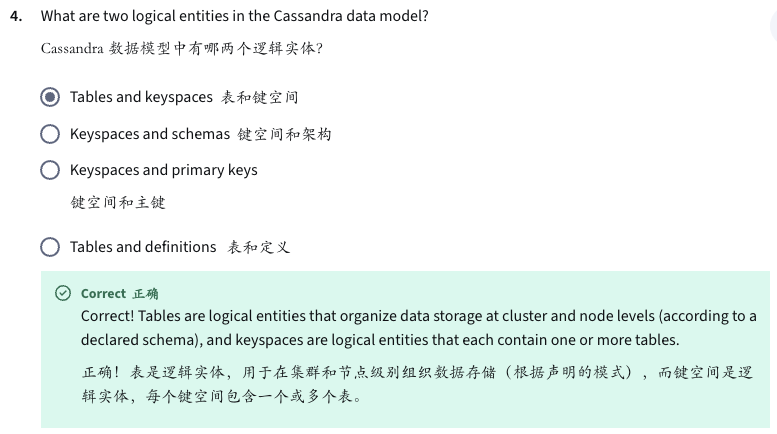
Cassandra的数据模型是一个分层的、容器化的结构,其核心逻辑实体是:
- 键空间 (Keyspace):这是最顶层的命名空间和逻辑容器,类似于关系型数据库中的数据库 (Database)。
- 表 (Table):表存在于键空间内部,是实际存储数据的结构,类似于关系型数据库中的表 (Table),但其内部结构(宽列)有显著不同。
现在我们来逐一分析选项:
A. Tables and keyspaces(表和键空间)
- 技术深入解析(正确选项):
- 键空间 (Keyspace):
- 这是一个逻辑分组单元,用于隔离不同的应用程序或业务域的数据。例如,你可以为
UserService创建一个user_keyspace,为ProductService创建一个product_keyspace。 - 在键空间级别定义核心的分布式策略,这些策略作用于其下的所有表:
- 副本放置策略 (Replication Placement Strategy):决定数据副本在集群中如何分布(如
SimpleStrategy用于单数据中心,NetworkTopologyStrategy用于多数据中心)。 - 副本因子 (Replication Factor, RF):定义每份数据在集群中存储多少个副本。
- 副本放置策略 (Replication Placement Strategy):决定数据副本在集群中如何分布(如
- 创建键空间:
CREATE KEYSPACE user_keyspace WITH replication = {'class': 'NetworkTopologyStrategy', 'DC1': 3};
- 这是一个逻辑分组单元,用于隔离不同的应用程序或业务域的数据。例如,你可以为
- 表 (Table):
- 表是定义数据模式(Schema)和存储实际数据的地方。
- 表结构由列定义,但其特点是宽列,即每行可以拥有不同的列集合(稀疏),而行由主键唯一标识。
- Cassandra的主键是一个复合概念,由分区键 (Partition Key) 和可选的聚类键 (Clustering Key) 组成。这决定了数据如何分布和排序。
- 创建表:
CREATE TABLE user_keyspace.users (user_id uuid, name text, email text, PRIMARY KEY (user_id));
- 键空间 (Keyspace):
- 通俗理解:
- 可以把键空间想象成一个大学。大学有自己的管理规则,比如规定每个专业(表)要备份多少份教学资料(副本因子RF),以及这些资料存放在哪个校区(副本策略)。
- 可以把表想象成大学里的一个专业(比如计算机系)。这个专业有自己特定的课程表(Schema),并且招收了很多学生(数据行)。每个学生(行)通过学号(分区键)被唯一标识。
B. Keyspaces and schemas(键空间和架构)
- 技术深入解析(不准确):
- “Schema”(架构/模式)指的是表的结构定义(有哪些列,主键是什么等),它不是一个与键空间平级的实体,而是表的一个属性。
- 在Cassandra中,你通常会说“一个键空间包含多个具有不同模式(Schemas)的表”。模式是依赖于表而存在的。
- 这个选项错误地将“模式”提升为一个独立的逻辑实体,混淆了概念层次。
C. Keyspaces and primary keys(键空间和主键)
- 技术深入解析(不准确):
- “主键”是表的一个组成部分,用于唯一标识表中的一行并决定数据的分布。它不是一个顶层的、独立的逻辑容器。
- 这个选项的错误在于,它用一个低级别的、属于表内部的组件(主键)去和一个顶级的容器(键空间)并列,逻辑层级不匹配。
D. Tables and definitions(表和定义)
- 技术深入解析(模糊且不准确):
- “Definitions”(定义)这个词过于宽泛和模糊。表的“定义”就是它的模式(Schema)。键空间也有其“定义”(副本策略和因子)。
- 这个选项没有指出另一个核心实体——键空间(Keyspace),而是用一个模糊的、非实体的概念来替代它,无法准确描述数据模型的逻辑结构。
结论与考点关联
- 正确答案:A
- 作为系统架构分析师,需要掌握的要点:
- 理解分层设计:Cassandra的数据模型是清晰的两层结构:Keyspace -> Table。这种容器化设计有利于多租户、资源隔离和权限管理。架构师需要善于利用这种分层来规划系统。
- 区分“策略”与“数据”的边界:关键的设计决策(如复制策略)在键空间级别做出,而具体的数据结构(Schema)则在表级别定义。这是一个重要的职责划分。
- 避免概念混淆:要清晰区分“实体”(如Keyspace, Table)和“属性/组件”(如Schema, Primary Key)。在架构设计中,这种精确性至关重要。
- 数据建模的影响:理解表的主键(特别是分区键)如何直接影响数据在集群中的分布和查询性能,这是Cassandra数据建模最核心、最关键的一环,虽然它在本题中不是正确选项,但必须是架构师深入掌握的知识。
这道题考察的是你对Cassandra数据模型最基本、最核心的抽象层次的理解。选项A准确地描述了这两个逻辑实体。