Module 02 · Introduction to the Hadoop Ecosystem
HIVEHive 数据仓库
欢迎观看《Hive》视频!通过观看此视频,您将能够:
- 说明 为什么使用 Hive
- 列举 Hive 的特性
- 区分 Hive 与传统关系型数据库管理系统(RDBMS)
- 识别 Hive 架构的组件
- 讨论 Hive 的概念
什么是 Hive?
Hive 是 Hadoop 中的一个数据仓库软件,旨在读取、写入和管理大型表格型数据集及数据分析。数据仓库用于存储来自不同来源的历史数据,便于分析和提取有价值的见解,这些见解用于报告和决策。
Hive 的特点
- 可扩展性和速度:Hive 设计用于处理 PB(千兆字节) 级的数据,因此具有很高的可扩展性和快速处理能力。
- SQL 类似的查询语言:如果您熟悉 SQL,使用 Hive 会非常方便,因为 Hive 查询语言(HiveQL)基于 SQL。这使得那些已经使用关系型数据库的用户能更快速地掌握概念。
- 支持的文件格式:Hive 支持多种文件格式,包括:
- Sequence 文件:包含二进制键值对
- 列式存储文件:存储表格的列数据
- 文本或平面文件
Hive 与传统 RDBMS 的比较
关系型数据库管理系统(RDBMS)
RDBMS 是一种专为关系型数据库设计的数据库管理系统,它使用 SQL 语言来操作数据,通常用于实时数据分析,如传感器数据。
Hive 的应用场景
Hive 主要用于数据仓库管理,适用于静态数据分析。与传统 RDBMS 相比,Hive 更适合处理大规模的批量数据分析。
Hive vs 传统 RDBMS 的主要区别:
| 特性 | Hive | 传统 RDBMS |
|---|---|---|
| 数据类型 | 适合静态数据分析 | 适合实时数据分析 |
| 操作方式 | 写一次,读多次(Write once, read many) | 支持频繁的读写操作 |
| 数据规模 | 设计用于处理 PB 级数据 | 通常处理最多 terabyte 级数据 |
| 模式验证 | 不强制验证数据模式 | 强制验证数据模式 |
| 分区支持 | 支持数据分区 | 可能没有内置分区支持 |
Hive 架构
Hive 的架构由三个主要部分组成:
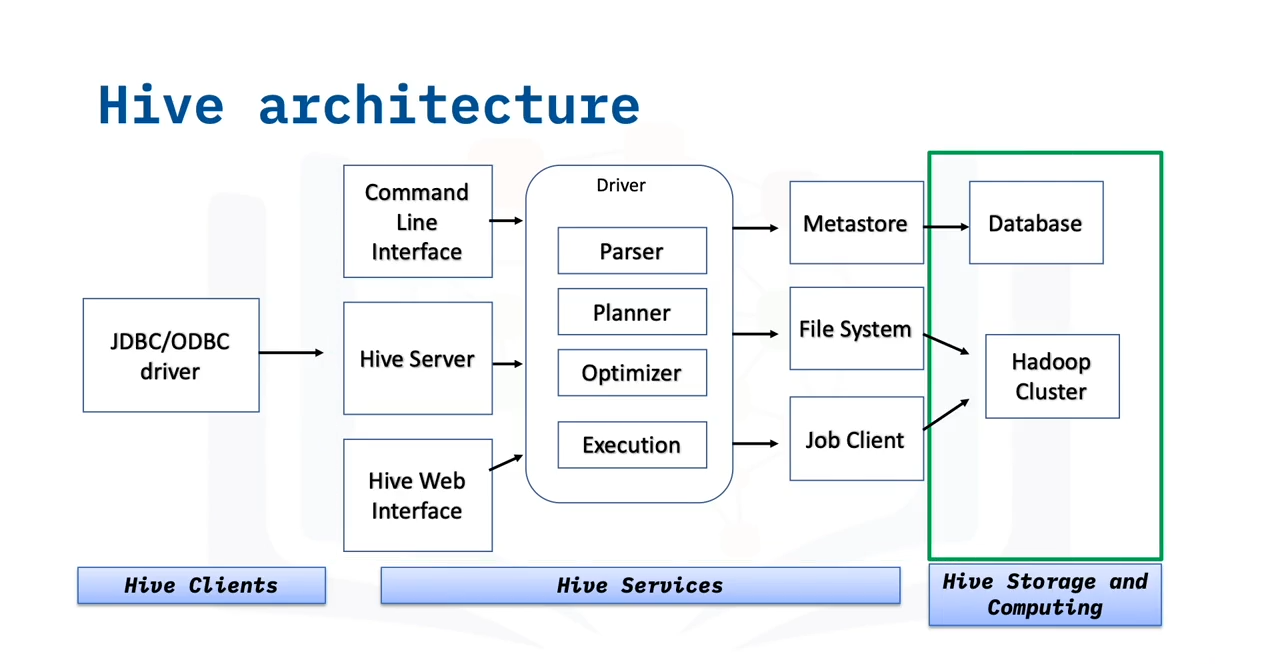
- Hive 客户端
Hive 提供了不同的驱动程序,用于不同类型的应用程序。例如,Java 应用程序使用 JDBC 驱动,而其他类型的应用程序使用 ODBC 驱动。 - Hive 服务
Hive 服务负责执行查询操作。客户端通过命令行接口与 Hive 服务进行交互,Hive 服务负责接收查询语句、启动会话并监控每个会话的生命周期。
- 驱动程序(Driver):接收查询语句,将查询提交给编译器并开始会话。
- 编译器(Compiler):负责解析查询,并生成执行计划。
- 优化器(Optimizer):对执行计划进行转换,并分割任务以提高效率。
- 执行器(Executor):执行任务,确保查询操作的顺利执行。
- Hive 存储和计算
- 元数据存储(Meta Store):Hive 存储表格的元数据,如表格位置和模式。它是 Hive 的中心存储位置,存储有关每个表的信息。
- 文件系统和作业客户端:Hive 的数据和查询结果存储在 Hadoop 集群或 HDFS 中。
Hive 的概念
Hive 的核心概念包括:
- JDBC 客户端:用于连接 Java 应用程序与 Hive。
- ODBC 客户端:用于基于 ODBC 协议的应用程序连接 Hive。
- 查询执行过程:
- 客户端提交查询请求,Hive 驱动程序将查询发送给编译器。
- 编译器解析查询并生成执行计划。
- 优化器对执行计划进行优化,分割任务以提高执行效率。
- 执行器执行任务,最终查询结果通过 Hive 服务返回给客户端。
总结
在本视频中,您学到了:
- Hive 是一个数据仓库软件,用于读取、写入和管理大数据集。
- 虽然 Hive 与传统的关系型数据库管理系统(RDBMS)相似,但两者在使用场景和功能上有一些重要的区别。
- Hive 的 架构 由三个主要部分组成:Hive 客户端、Hive 服务 和 Hive 存储与计算。
Hive 提供了一个强大的平台,帮助用户在大规模数据集上执行高效的数据分析和查询操作。