Module 03 · Apache Spark
Functional Programming Basics函数式编程基础
欢迎观看《函数式编程基础》视频!在观看完该视频后,您将能够:
- 解释什么是函数式编程
- 解释 Lambda 函数
- 将函数式编程与 Apache Spark 联系起来
什么是函数式编程?
函数式编程(Functional Programming,简称 FP)是一种遵循数学函数格式的编程风格。你可以把它想象成代数课上使用的“f(x)”表示法。函数式编程使用的是声明式语法,而不是命令式语法。
声明式 vs 命令式
- 声明式:代码的重点在于“做什么”(what),而不是“如何做”(how)。
- 命令式:代码的重点则在于“如何做”,会明确列出执行步骤。
在函数式编程中,表达式像“f(x)”这样简洁直观,强调的是最终结果,而不是实现的细节。
函数式编程的历史
历史上,LISP(LISt Processing Language)是第一个函数式编程语言,始于20世纪50年代。如今,Scala、Python、R 和 Java 等编程语言都支持函数式编程。Scala 是最新的代表语言,而 Apache Spark 主要是用 Scala 编写的。
Scala 中的函数
在 Scala 中,函数被视为一等公民,意味着函数可以作为参数传递给其他函数,可以由其他函数返回,也可以作为变量使用。
函数式编程示例
假设我们定义一个简单的函数,f(x) = x + 1,用于将数字加一。我们可以将这个函数应用到一个包含四个元素的列表上,程序会将列表中的每个元素都加 1。
传统编程 vs 函数式编程
- 传统编程(命令式):你需要使用
for循环来遍历数组,逐个元素加 1,代码会显式列出每一步骤,关注的是“如何做”。 - 函数式编程:你只需要定义一个函数,然后直接应用到整个列表或数组上,关注的是“做什么”。
函数式编程的优势:并行化
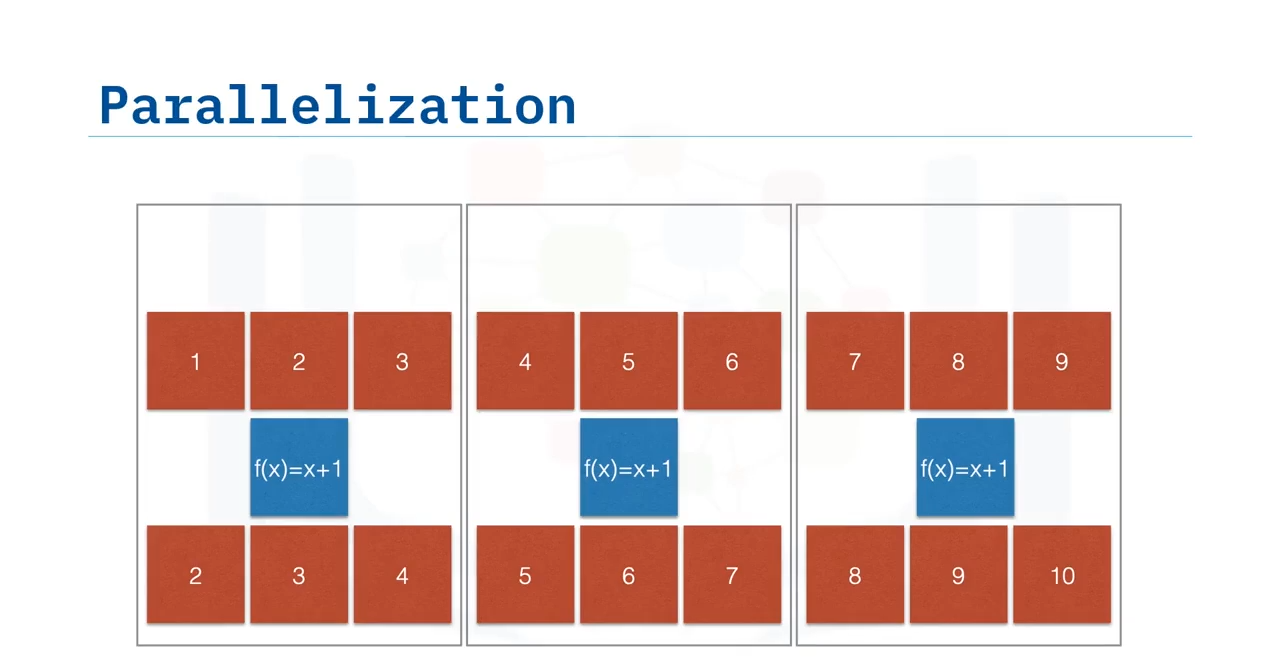
并行化是函数式编程的主要优势之一。考虑之前的例子,如果程序要对一个包含 1 到 9 的更大数组进行加一操作,我们可以将任务分成三个部分,分别在不同的计算节点上并行运行。
并行化的优势
- 你无需修改任何函数定义或代码,只需运行多个实例并行处理任务。
- 通过函数式编程的隐式并行化特性,你可以通过增加更多计算资源来扩展算法的规模,无需修改程序或代码。
即使任务在单个节点上运行,结果也不会改变;不过,在这种情况下,函数会在三个节点上并行运行,而不需要修改代码。
Lambda 计算与 Lambda 函数
函数式编程中应用了一个数学概念:Lambda 计算。简单来说,Lambda 计算表示每个计算都可以通过一个匿名函数来表达,并应用于数据集。
Lambda 函数
Lambda 函数(或 Lambda 操作符)是匿名函数,在函数式编程中广泛使用。以下是使用 Scala 和 Python 两种语言,通过 Lambda 函数将两个数字相加的代码示例:
- Scala(左侧)与 Python(右侧)的代码非常相似,流程一致,直接抽象出结果,这是声明式编程的典型特点。
Apache Spark 与函数式编程
Apache Spark 能够通过 Lambda 函数将工作分发到工作节点并实现并行计算,从而快速处理大数据。所有通过这种方式实现的 Spark 程序本质上都是并行的,无论你分析的是 1KB 还是 1PB 的数据,只需添加更多资源到 Spark 集群即可。
总结
在本视频中,您学到了:
- 函数式编程遵循声明式编程模型,强调“做什么”而非“如何做”,并使用表达式。
- Lambda 函数或操作符是匿名函数,支持函数式编程。
- Spark 利用 Lambda 计算 实现并行计算。
- 所有函数式编程的 Spark 程序天生具备并行性。
一、函数式编程(FP)的本质
FP的核心是数学函数思维,就像f(x)=x+1这样,输入确定,输出就确定(无副作用)。
- 声明式 vs 命令式:
- FP是声明式(Declarative):只关心"做什么"(如"列表每个元素+1"),隐藏实现细节。
- 传统命令式(Imperative)需写循环一步步操作("如何做"),如for循环遍历数组。
- 架构意义:声明式代码更简洁、易维护,适合复杂系统,因为抽象层次高,减少底层干扰。
二、Lambda函数(匿名函数)
- 本质是无名函数,直接定义使用,如Python中
lambda x: x+1。 - 技术价值:
- 作为"一等公民"(First-class Citizen),可被赋值、传递、返回,支持高阶函数(函数处理函数)。
- 在Spark中,Lambda是分布式计算的最小任务单元,可被序列化并分发到集群节点并行执行。
三、FP与Apache Spark的关系
- Spark底层依赖Scala(FP语言):
- Scala的函数特性(如匿名函数、不可变数据)让Spark天然支持分布式并行。
- 例如:RDD的
map(func)操作,直接传入Lambda函数(如x => x+1),Spark自动将其并行化到集群。
- 并行化优势:
- FP的无状态和无副作用特性(函数只依赖输入,不修改外部状态),使得任务可任意拆分到多节点并行,无需修改代码。
- 对比命令式:循环依赖顺序执行,难以并行(需显式处理线程/锁)。
- Spark通过Lambda Calculus模型:将计算抽象为匿名函数+数据集,自动分配任务(如将大数据集分片,各节点处理分片后合并)。
- 架构设计启示:
- 弹性扩展:FP+Spark的并行性允许线性扩容——数据量增大时,仅需增加集群资源(节点),而不重写程序。
- 容错性:FP的不可变性(数据不改写)和纯函数易于重现计算,Spark利用此特性通过血缘(Lineage)机制快速恢复故障。
- 适用场景:大数据ETL、流处理(如Spark Streaming)、机器学习(MLlib)等,因FP天然适合批量数据转换。
四、备考重点关联
- 系统性能架构:FP的并行模式是分布式系统设计的典范(如分治、MapReduce)。
- 软件设计原则:FP强调高内聚低耦合(函数独立),契合架构模块化思想。
- 技术选型:理解Spark为何选Scala(而非Java)——FP特性更直接支持分布式计算模型。
总结:FP在Spark中的核心作用
| 特性 | 传统命令式 | FP+Spark |
|---|---|---|
| 代码焦点 | 如何实现(循环、状态管理) | 做什么(直接声明操作) |
| 并行 | 需显式控制线程/进程 | 隐式并行(自动任务分发) |
| 扩展性 | 修改代码适配规模 | 仅需加资源(节点) |
| 架构设计复杂度 | 高(需处理并发冲突) | 低(无状态函数避免竞争) |
这解释了为何Spark能高效处理PB级数据:FP模型让分布式计算变得简单、自然。作为架构师,理解此模式有助于设计可扩展、易维护的大数据系统。