Module 03 · Apache Spark
Practice Quiz: Introduction to Apache Spark练习测验:Apache Spark 导论
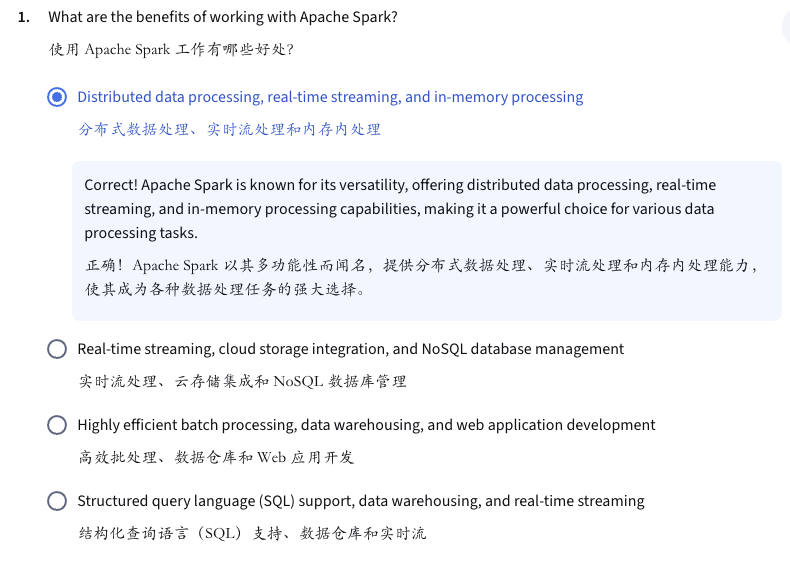
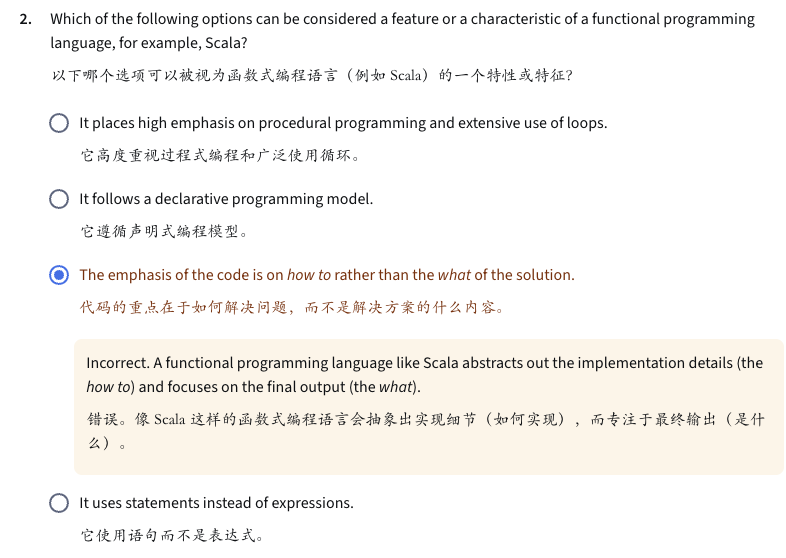
正确答案是:B. It follows a declarative programming model.它遵循声明式编程模型。
深入技术解析
为什么B是正确的?
函数式编程(如Scala)的核心是声明式编程范式。这意味着:
- 关注"做什么"而非"怎么做":你声明想要的结果,而不是一步步指示计算机如何执行
- 实际例子:在Scala中,
list.filter(_ > 10).map(_ * 2)声明了"筛选大于10的元素并加倍",而不需要指定循环细节
为什么其他选项是错误的?
A. 重视过程式编程和循环 ❌
- 函数式编程恰恰避免命令式循环和可变状态
- Scala使用高阶函数(如map、filter、reduce)替代循环,更安全且可并行化
C. 重点在"如何"而非"什么" ❌
- 这描述的是命令式编程(如C、Java)
- 函数式编程正好相反:关注声明结果(什么),而非执行步骤(如何)
D. 使用语句而非表达式 ❌
- 函数式编程的核心是表达式(总有返回值)
- 与语句(执行操作但无返回值)相反,这支持函数的组合和链式调用
架构师视角
在系统架构中,函数式编程的特性:
- 更易推理和测试:无副作用使代码行为更可预测
- 更好的并发支持:不可变性天然避免竞态条件
- 表达力强:简洁的代码表达复杂业务逻辑
这种理解对于构建高并发、高可靠性的系统架构至关重要。
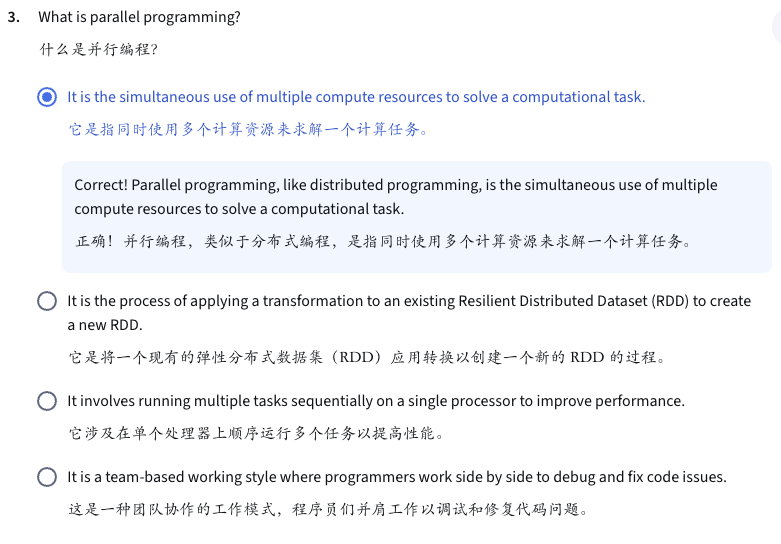
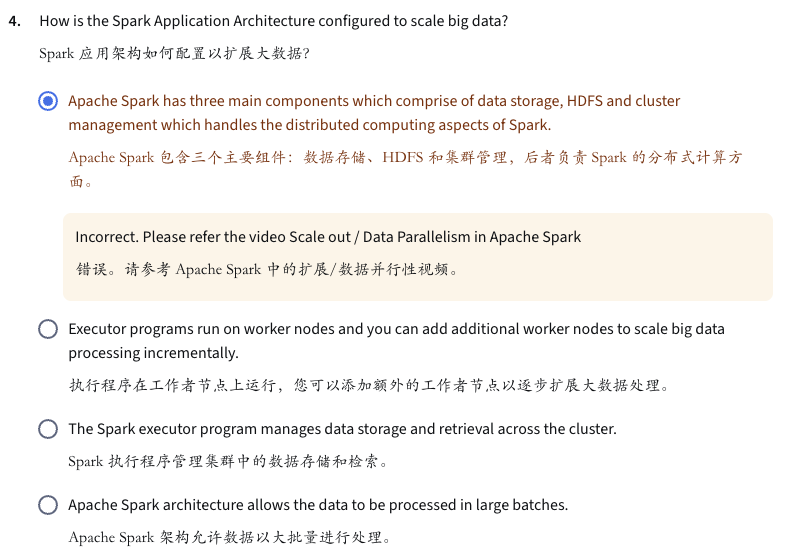
正确答案是:B. Executor programs run on worker nodes and you can add additional worker nodes to scale big data processing incrementally.执行程序在工作者节点上运行,您可以添加额外的工作者节点以逐步扩展大数据处理。
深入技术解析
为什么B是正确的?
这描述了Spark水平扩展(横向扩展) 的核心机制:
- 弹性工作节点架构:Spark采用Master-Worker架构,通过增加Worker节点来扩展计算能力
- 实际扩容方式:在YARN/K8s/Mesos集群中,直接添加物理节点或虚拟机即可提升整体处理能力
- 线性扩展特性:理论上处理能力与Worker数量呈线性关系,这是大数据架构的关键特征
为什么其他选项是错误的?
A. 三个主要组件包含数据存储、HDFS和集群管理 ❌
- 概念错误:HDFS只是可选数据源之一(Spark还支持S3、HBase等)
- 架构组件不准确:Spark核心组件是:
- Driver Program(驱动程序)
- Cluster Manager(集群管理器)
- Executors(执行器)
- 数据存储是外部系统,不属于Spark架构本身
C. Spark执行程序管理数据存储和检索 ❌
- 职责错误:Executors只负责计算任务执行和内存数据缓存
- 数据存储检索由存储系统自身(如HDFS Client、S3 SDK)处理,Spark通过DataSource API进行抽象
D. 允许数据以大批量处理 ❌
- 描述片面:虽然Spark支持批处理,但其扩展性优势在于:
- 微批处理(Spark Streaming)
- 内存计算(比MapReduce快10-100倍)
- 弹性分布式数据集(RDD)的并行处理能力
- 单纯"大批量处理"无法体现Spark的扩展性优势
架构师视角
从系统架构角度,Spark的扩展性设计包含这些关键要素:
- 计算与存储分离架构
- Spark不管理存储,只专注计算,便于独立扩展
- 支持多种数据源,避免存储瓶颈
- 动态资源分配(关键特性)
spark.dynamicAllocation.enabled=true
spark.dynamicAllocation.maxExecutors=100  # 可扩展到100个执行器
根据负载自动调整Executor数量
3. 分片(Partition)并行机制
- 数据自动分片分布到不同节点
- 每个Partition由一个Task处理,天然支持并行
- 容错机制:
- RDD血缘关系(Lineage)支持快速故障恢复
- 不需要像MPP数据库那样完全重新执行
这种架构使Spark能够处理PB级数据,是当今大数据平台的核心计算引擎。