Module 03 · Apache Spark
Scale out / Data Parallelism in Apache SparkApache Spark 中的扩展与数据并行性
欢迎观看《Apache Spark 中的扩展与数据并行性》视频!在观看完该视频后,您将能够:
- 描述 Apache Spark 的组件
- 描述 Apache Spark 如何处理大数据的扩展
Apache Spark 架构
Apache Spark 架构由三个主要组件构成:
1. 数据存储
数据集从数据存储加载到内存中,任何兼容 Hadoop 的数据源都可以作为数据存储。
2. 高级编程 API
Spark 提供了 Scala、Python 和 Java 等多种编程语言的 API,方便开发者进行操作。
3. 集群管理框架
集群管理框架处理 Spark 的分布式计算方面的工作。它可以作为独立服务器运行,也可以基于 Mesos 或 YARN 等集群管理工具来执行。
集群管理框架对于大数据的扩展至关重要,它能够支持分布式计算并管理集群资源。
架构可视化
以下是简化的 Spark 架构示意图:
- 数据从 Hadoop 文件系统中加载,流入计算接口或 API。
- 然后,这些数据流向不同的节点,执行分布式/并行任务。
Spark Core:基础引擎
通常所说的“Spark”是指其基础引擎——Spark Core。
- 容错性:Spark Core 是一个容错的基础引擎,适用于大规模的并行和分布式数据处理。
- 内存管理:Spark Core 负责内存管理和任务调度。
- 任务调度与 RDD 定义:它包含了定义 RDD 和其他数据类型的 API,并且能够将分布式元素集合进行并行化。
Spark 如何扩展大数据
为了更好地理解 Spark 如何扩展大数据,首先需要了解 Spark 应用架构。
Spark 应用架构
- 驱动程序(Driver Program):驱动程序是 Spark 应用的入口,包含应用所需运行的任务。
- 执行程序(Executor Program):执行程序运行在工作节点上。Spark 可以在工作节点上启动额外的执行进程(如果有足够的内存和核心资源)。
- 多核支持:执行程序也可以使用多个核心来进行多线程计算。
RDD 与执行程序
- 任务分配:驱动程序将任务拆分为若干任务并提交给执行程序,执行程序完成任务后,将结果返回给驱动程序。
- 节点通信:驱动程序与执行程序之间通过通信交换任务与结果。
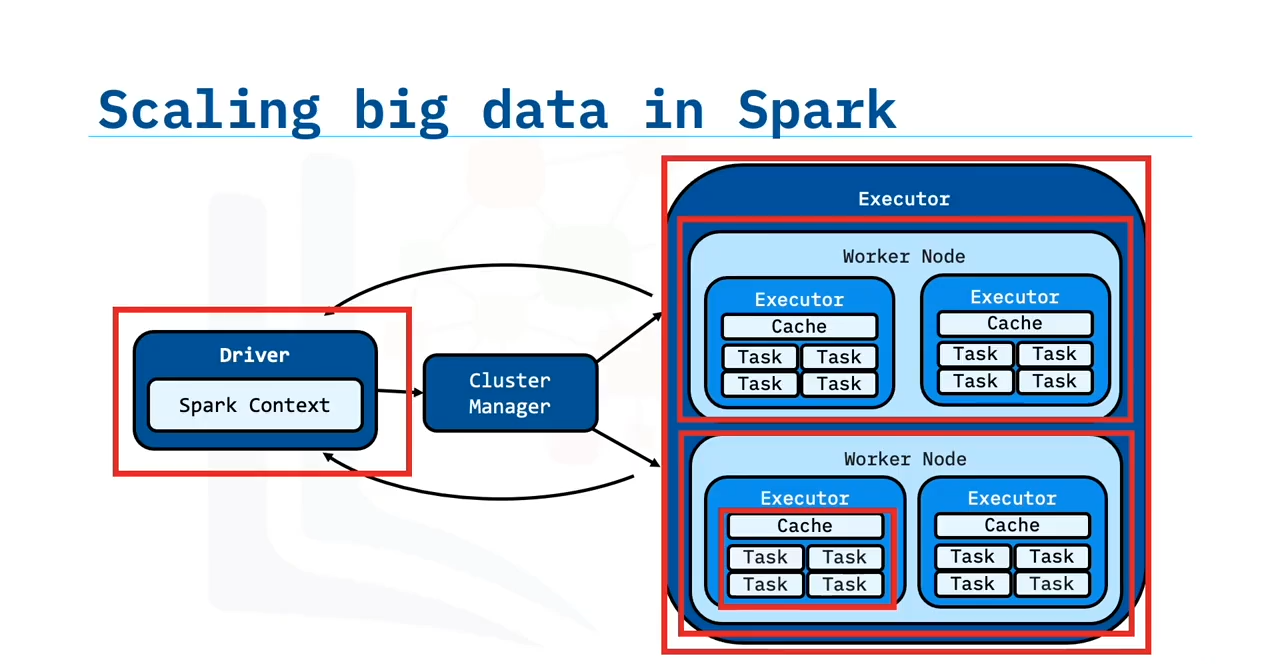
类比:企业管理
- 驱动程序:可以类比为企业的高层管理层,负责做出工作分配、资本分配等决策。
- 执行程序:类比为公司中做具体工作的员工,执行分配给他们的任务,使用公司提供的资源。
- 工作节点:类似于员工的办公空间,您可以通过增加工作节点来逐步扩展大数据处理能力。
总结
在本视频中,您学到了:
- Apache Spark 架构由三部分组成:数据存储、计算输入和集群管理。
- Spark Core 是一个容错的基础引擎,负责大规模并行和分布式数据处理、内存管理、任务调度,并包含定义 RDD 的 API。
- 驱动程序 与集群通信,并将 RDD 分配给工作节点。
一、Spark三大核心组件(架构分层视角)
- 数据存储层(Data Storage)
- 支持Hadoop兼容源(HDFS、S3、HBase等),解耦计算与存储。
- 架构优势:存储可独立扩展(如用S3实现无限存储),计算层无状态。
- 编程API层(High-level APIs)
- 多语言支持(Scala/Python/Java),统一编程模型隐藏分布式复杂性。
- 关键点:API定义RDD转换操作(如
map、reduce),生成计算逻辑图(DAG)。
- 集群管理层(Cluster Manager)
- 支持Standalone/Mesos/YARN,资源调度与隔离的核心。
- 架构选择:
- YARN:兼容Hadoop生态,资源隔离强。
- Mesos:通用资源管理,适合混合负载。
- Standalone:轻量级,但功能较简单。
二、Spark Core引擎的核心能力
- 分布式处理基石:
- 任务调度(DAGScheduler)、内存管理(MemoryManager)、RDD抽象。
- 容错机制:通过RDD血缘(Lineage)实现计算重演而非数据复制。
- 数据并行本质:
- 将数据分片(Partition)分布到集群,每个分区独立处理(无共享状态)。
- 例如:
rdd.map(f)操作会并行应用到所有分区。
三、Spark应用架构(Driver-Executor模型)
1. Driver(驱动节点)
- 角色:类似"大脑",负责:
- 解析用户代码(生成RDD DAG图)。
- 将DAG拆分为任务阶段(Stages)和任务(Tasks)。
- 调度任务到Executor,监控状态并收集结果。
- 关键点:Driver是单点(需高可用部署),但无状态(故障后可重启恢复)。
2. Executor(执行节点)
- 角色:类似"工人",在Worker节点上启动的进程,负责:
- 执行Driver分配的任务(如计算RDD分区数据)。
- 缓存数据(如持久化RDD)加速迭代计算。
- 资源分配:
- 每个Executor可占用多核(并行线程数)和内存(处理数据量)。
- 最佳实践:根据数据大小和计算复杂度调整Executor数量及资源(避免OOM或资源闲置)。
3. Worker Node(物理节点)
- 提供计算资源(CPU、内存),可运行多个Executor进程。
- 扩展性:水平扩展(加节点)即可提升处理能力(线性扩展理想情况下)。
四、扩展性(Scale-out)实现原理
- 数据分区并行:
- RDD分区数决定并行度(如HDFS块数自动分区)。
- 可通过
repartition()手动调整分区数以匹配集群资源。
- 动态资源分配(YARN/Mesos支持):
- 根据负载动态增减Executor数量(如流处理中突发流量)。
- 计算与存储分离:
- 计算层(Spark)无状态,存储层(HDFS/S3)独立扩展,互不影响。
五、架构师需关注的设计权衡
- 分区策略:
- 过多分区 → 小任务开销大;过少分区 → 资源利用不足。
- 建议:分区大小适中(通常128MB~1GB),与HDFS块对齐。
- Executor配置:
- 内存分配:需权衡缓存空间(
executor-memory)与堆外内存(off-heap)。 - 核数分配:太多易竞争,太少浪费资源(通常4~8核/Executor)。
- Driver高可用:
- 单点故障风险,需通过集群模式(如YARN Cluster)或监控重启保障。
- 数据本地性:
- 尽量将任务调度到存储数据的节点(减少网络传输)。
六、与系统架构的关联
- 微服务架构对比:
- Driver类似"网关"或"控制器",Executor类似"无状态服务实例"。
- 容错设计:
- Executor故障时,Driver重新调度任务到其他节点(利用RDD血缘重新计算)。
- 资源管理:
- 集群管理器(如YARN)相当于"云平台调度器",负责资源分配隔离。
总结:Spark扩展性核心思想
| 设计原则 | 实现机制 | 架构启示 |
|---|---|---|
| 数据并行 | RDD分区 + 多Executor并行计算 | 无共享架构避免竞争,简化并发 |
| 计算存储分离 | 兼容外部存储(HDFS/S3) | 存储与计算独立扩展 |
| 动态资源分配 | 集群管理器(YARN/Mesos) | 弹性应对负载波动 |
| 容错通过重算 | RDD血缘关系 | 替代数据复制,节省网络开销 |
作为架构师,需根据业务场景(批处理/流处理/机器学习)调整分区策略、资源分配和持久化机制,以构建高效、可扩展的Spark应用。