Module 01 · What Is Big Data?
Course Introduction大数据、Hadoop 与 Spark 入门课程
欢迎来到本课程!🎉 本课程将为您介绍 大数据、Hadoop 和 Spark 的基础知识,适合任何希望从事数据工程或数据架构岗位的人,也对那些希望掌握大数据技术的 数据科学家 和 机器学习工程师 十分有用。特别是对于那些希望推动技术采纳、管理业务技术部分、生成或使用大数据的技术决策者,本课程是一个理想的选择。
课程推荐背景
为了在本课程中取得成功,建议学习者对以下内容有一定了解:
- 数据素养
- SQL
- Python 💻
我们非常高兴您加入我们!本课程的讲师包括:
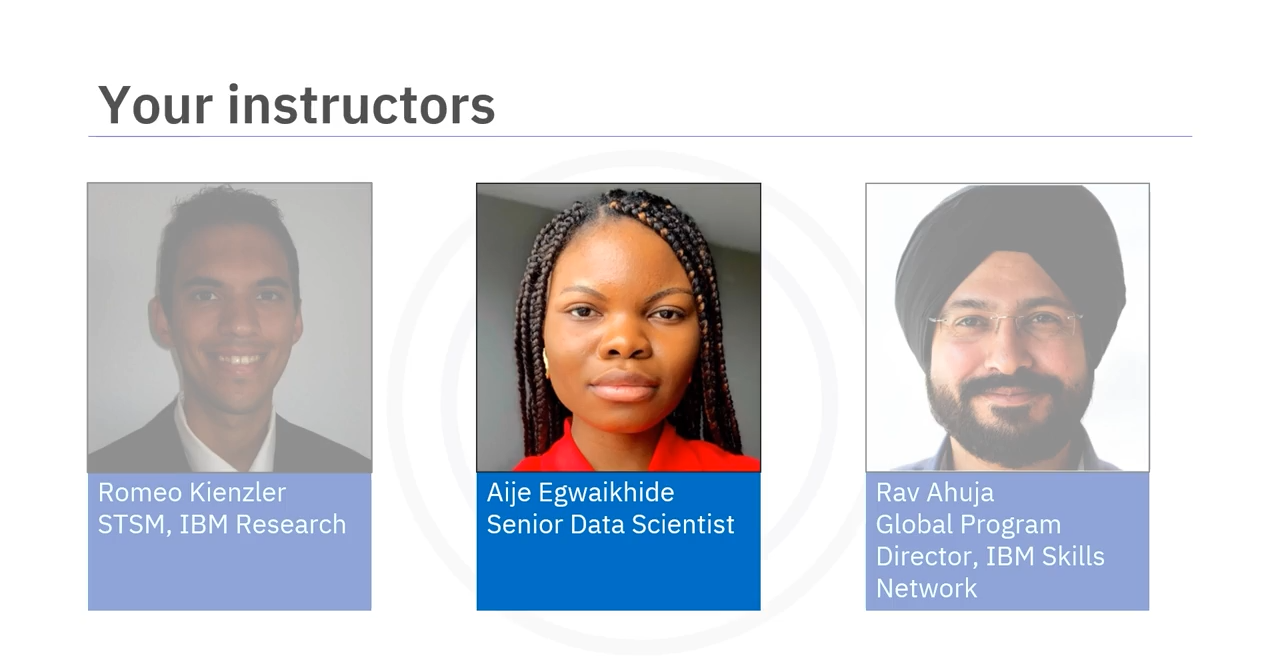
- Romeo Kienzler:IBM Research 的高级软件工程师兼产品主管,拥有超过 20 年的软件工程、数据库管理和信息集成经验。
- Aije Egwaikhide:高级数据科学家,专注于创建端到端的机器学习和统计解决方案以优化操作。
- Rav Ahuja:IBM 全球项目总监,领导 IBM 技能网络的增长战略、课程创建和合作伙伴项目。
课程概述
本课程由 七个模块 组成,涵盖了从大数据基础到 Apache Spark 的深入应用,以下是您将学习的内容:
模块 1:大数据基础
- 了解 大数据 的最新定义。
- 探讨大数据在日常任务和商业交易中的应用案例。
- 学习大数据如何利用 并行处理、扩展性 和 数据并行性。
- 了解常用的大数据工具。
模块 2:Apache Hadoop 架构与生态系统
- 介绍 Apache Hadoop 生态系统,主要包括:
- HDFS(Hadoop 分布式文件系统)
- MapReduce
- Hive
- HBase
- 获得 Hive、Hadoop 集群 和 MapReduce 的实际操作经验。
模块 3:Apache Spark 平台
- 学习 功能编程 和 Lambda 函数。
- 深入了解 弹性分布式数据集(RDDs)、并行编程 和 容错性。
- 探索 Spark SQL 和 数据框架查询 的功能、结构与优势。
模块 4:数据框架与 Spark SQL
- 学习 RDDs 在 Apache Spark 中的应用与转换操作。
- 比较 数据集 和 数据框架 的使用。
- 了解 Apache Spark SQL 的优化技术,包括 Catalyst 和 Tungsten。
模块 5:开发与运行时环境
- 探讨 Spark 如何处理应用程序请求。
- 了解 Apache 集群管理器 及其组件和优势,学会如何连接各个集群管理器。
- 使用 Spark 的统一接口,进行 Spark 提交和配置。
- 学习如何在 IBM Cloud 和 Kubernetes 上使用 Apache Spark,并完成相关实验。
模块 6:Spark 用户界面(UI)连接与应用管理
- 学习如何连接 Apache Spark 用户界面(UI)并管理应用程序进程。
- 使用应用程序 UI 调试 Spark 应用问题,并查找相关日志文件。
- 了解 Spark 如何管理内存和处理器资源,并获得真实世界的操作知识。
模块 7:巩固学习与实践
- 在本模块中,您将进行实践实验,应用各种 RDDs 和 数据框架 的转换和操作。
- 最后,您将创建一个 数据框架,并根据您的学习完成最终的评估。
学习方法
通过实践学习
为了巩固课程内容,您将进行实践活动并获得实际操作经验,实践实验分布在各个学习模块中。通过亲自动手,您可以将理论与实践相结合,提升技能。
充分利用课程资源
- 观看所有视频 并完成所有 测验。
- 完成实践实验,将您的新技能运用到实际中,并建立可分享的作品集。
- 通过 讨论区 与同学互动,或向课程工作人员寻求帮助。
祝贺您迈出激动人心的一步!
祝您在学习的旅程中收获丰富的知识,成功掌握大数据、Hadoop 和 Spark 的核心技术!