Module 03 · Apache Spark
Graded Quiz: Apache Spark评分测验:Apache Spark
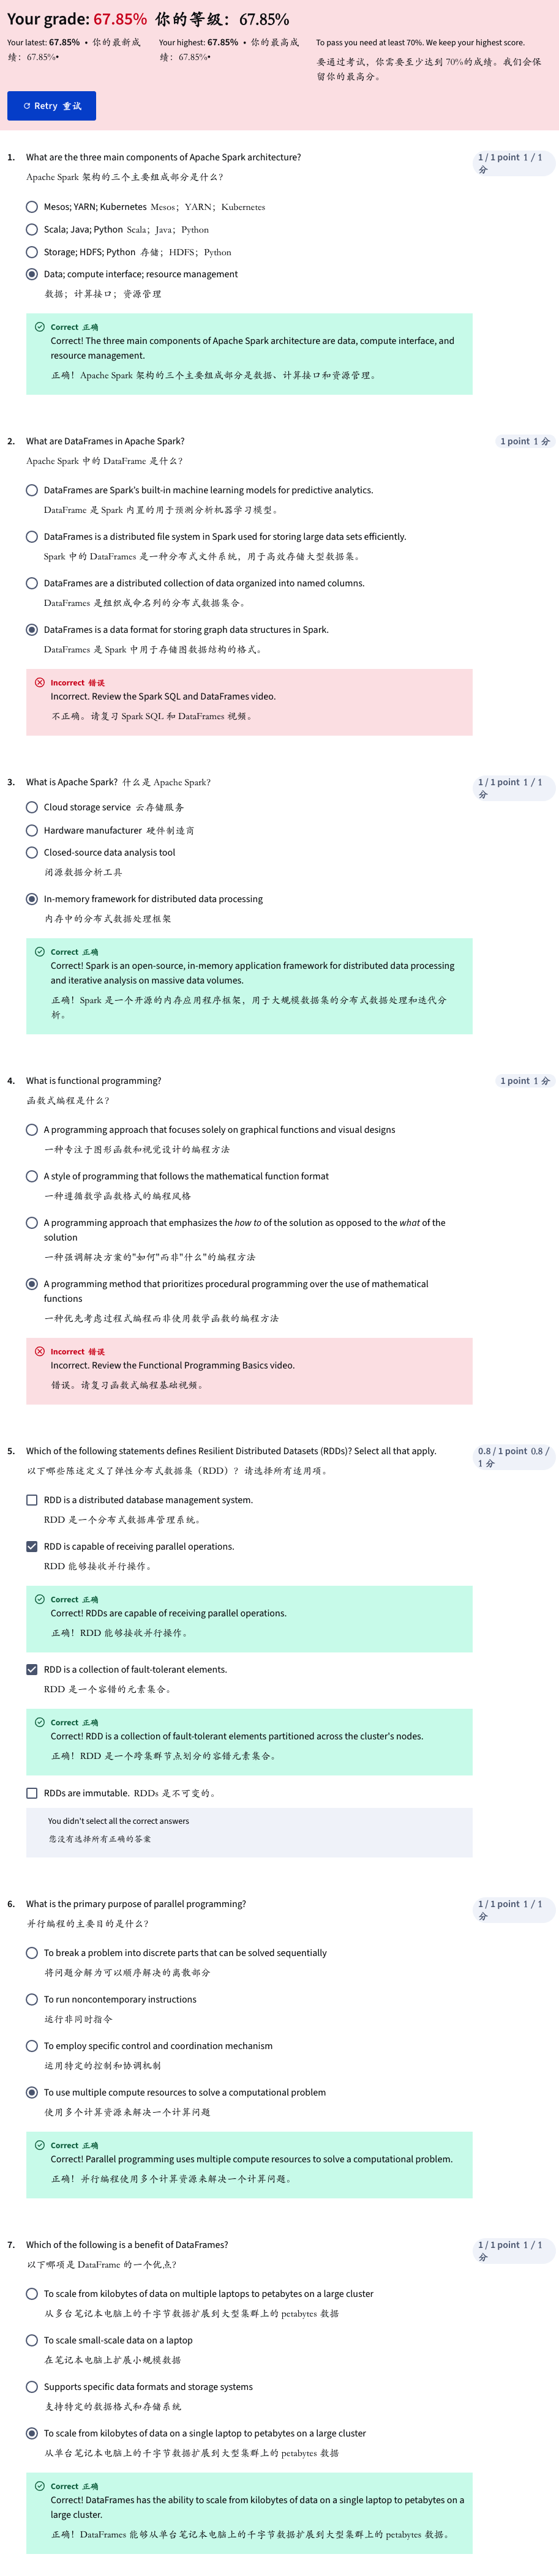
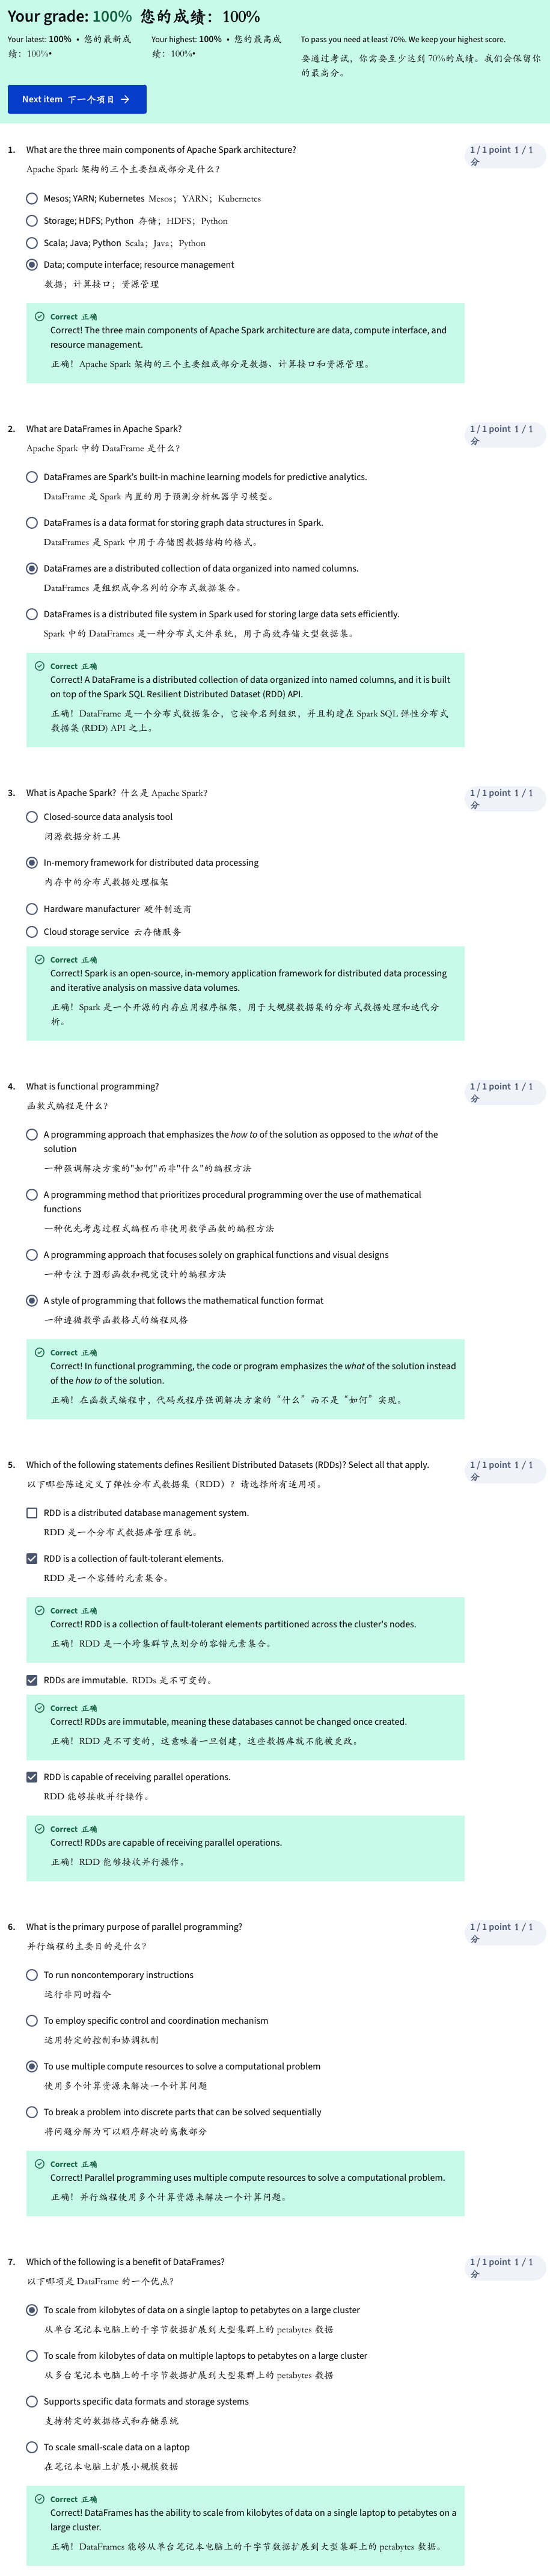
正确答案是:C. DataFrames are a distributed collection of data organized into named columns.DataFrames 是组织成命名列的分布式数据集合。
深入技术解析
为什么C是正确的?
这准确描述了Spark DataFrame的核心架构特征:
- 分布式集合:
- 数据自动分区 across集群节点
- 每个分区包含数据子集,可并行处理
- 架构示例:200GB数据 → 100个分区(每个约2GB)
- 命名列结构:
- 类似关系数据库的表格结构
- 强类型schema(不同于RDD的弱类型)
- 支持结构化和半结构化数据
- 核心架构价值:
# DataFrame的物理执行计划(通过explain()查看)
df.explain()
# 显示:数据扫描 → 过滤 → 聚合 → 结果输出
为什么其他选项是错误的?
A. 内置机器学习模型 ❌
- 混淆概念:DataFrame是数据结构,不是算法模型
- 正确关联:MLlib使用DataFrame作为机器学习的数据输入格式
- 架构关系:DataFrame为机器学习提供特征工程的数据基础
B. 分布式文件系统 ❌
- 根本性错误:DataFrame是内存计算抽象,不是存储系统
- 存储对比:Spark使用HDFS、S3等作为持久化存储,DataFrame是计算层抽象
- 生命周期:DataFrame存在于Spark应用执行期间,是临时数据表示
D. 图数据结构格式 ❌
- 领域错误:图数据由GraphX(基于RDD)处理
- 格式区别:DataFrame处理表格数据,GraphX处理顶点-边关系
- 架构定位:Spark有专门的图计算模块,与DataFrame平行
架构师视角
从系统架构角度看,DataFrame的核心价值:
- 统一数据处理接口:
- 整合了SQL查询、函数式编程和过程式编程
- 支持Python、Java、Scala、R多语言API
- 性能优化机制:
- Catalyst优化器:进行逻辑优化(谓词下推、常量折叠等)
- Tungsten执行引擎:生成高效字节码,堆外内存管理
- 示例优化:
filter("age > 30")会被下推到数据源端执行
- 数据源抽象层:
# 统一访问多种数据源
df = spark.read.format("parquet").load("hdfs://path")
df = spark.read.format("jdbc").option("url", "...").load()
- 与RDD的架构对比:
| 特性 | RDD | DataFrame |
| --- | --- | --- |
| 优化级别 | 无自动优化 | Catalyst+Tungsen优化 |
| 内存使用 | JVM对象,GC开销大 | 堆外二进制格式 |
| 开发效率 | 低级API,灵活但复杂 | 高级API,开发高效 |
这种理解对于设计大数据平台的数据处理层和选择合适的数据抽象至关重要。DataFrame是现代Spark应用的核心编程抽象。
正确答案是:B. A style of programming that follows the mathematical function format一种遵循数学函数格式的编程风格
深入技术解析
为什么B是正确的?
这抓住了函数式编程的数学基础和形式化特征:
- 数学函数特性:
- 纯函数:相同输入永远产生相同输出(引用透明性)
- 无副作用:不修改外部状态(无状态性)
- 函数组合:
f(g(x))类似数学中的函数复合
- λ演算基础:
- 函数式编程基于λ演算这一数学形式系统
- 所有计算都表示为函数应用
- 架构体现:
// 数学函数风格:y = f(x)
val result = list.map(x => x * 2)  // 转换函数
             .filter(x => x > 10) // 过滤函数
// 每个操作都是数学变换,不改变原数据
为什么其他选项是错误的?
A. 专注于图形函数和视觉设计 ❌
- 完全错误:与函数式编程无关
- 可能混淆:与可视化编程或图形库无关
C. 强调"如何"而非"什么" ❌
- 正好相反:这描述的是命令式编程
- 函数式特点:关注"什么"(声明结果),而非"如何"(执行步骤)
- 架构对比:
- 命令式:
for(int i=0; i<list.size(); i++) { ... }(关注如何迭代) - 函数式:
list.map(transform).filter(predicate)(关注转换什么)
- 命令式:
D. 优先过程式编程而非数学函数 ❌
- 根本性错误:函数式编程明确拒绝过程式编程
- 范式冲突:过程式编程依赖可变状态和顺序执行,与函数式理念完全相反
架构师视角
从系统架构角度,函数式编程的关键价值:
- 可预测性与可测试性:
- 纯函数使单元测试更简单(无需mock外部状态)
- 便于形式化验证和数学证明
- 并发安全架构:
// 天然线程安全:无共享可变状态
val processedData = data.par  // 转换为并行集合
                      .map(processFunction)  // 自动并行执行
避免竞态条件和锁机制复杂度
3. 系统可维护性:
- 函数组合产生更模块化的代码
- 更易推理的系统行为(减少隐藏的状态依赖)
- 与现代架构的契合:
- 微服务:无状态服务更易扩展
- 事件溯源:状态变更为事件序列,符合函数式理念
- 响应式系统:数据流处理天然函数式
这种理解对于设计高并发、高可靠性的分布式系统架构至关重要。函数式编程不仅是编程风格,更是一种系统架构哲学。
正确答案是:B. RDD is capable of receiving parallel operations.RDD 能够接收并行操作。
C. RDD is a collection of fault-tolerant elements.RDD 是一个容错的元素集合。
D. RDDs are immutable. RDDs 是不可变的。
深入技术解析
为什么B、C、D是正确的?
B. 能够接收并行操作 ✅
- 架构本质:RDD是Spark的基本并行计算单元
- 分片机制:数据自动分区(Partition),每个分区可在不同节点并行处理
- 执行模型:
map、filter、reduce等操作在所有分区上并行执行
C. 容错的元素集合 ✅
- 弹性(Resilient)的核心:通过血缘关系(Lineage) 实现容错
- 重建机制:节点故障时,可根据Lineage信息重新计算丢失的分区
- 与复制容错的区别:计算容错而非数据复制容错,更高效
D. 不可变的 ✅
- 函数式编程基础:不可变性确保:
- 并发安全(无锁编程)
- 确定性计算
- lineage跟踪可能
- 操作语义:转换操作(transformation)生成新RDD,不修改原RDD
为什么A是错误的?
A. 分布式数据库管理系统 ❌
- 概念错误:RDD是内存计算抽象,不是数据库系统
- 关键区别:
特性 RDD 分布式数据库 持久化 临时计算中间结果 持久化存储 数据管理 无模式(Schema-less) 强模式约束 事务支持 无ACID事务 支持事务 查询语言 编程API SQL接口
架构师视角
从系统架构角度看,RDD设计的精妙之处:
- 基于血统(Lineage)的容错机制:
# RDD操作会记录血统关系
rdd1 = sc.parallelize([1, 2, 3, 4, 5])
rdd2 = rdd1.map(lambda x: x * 2)    # 转换1
rdd3 = rdd2.filter(lambda x: x > 5) # 转换2
# 血统:rdd3 → rdd2 → rdd1 → 原始数据
# 故障时只需重新计算受影响的分区
- 内存计算架构优势:
- 减少磁盘I/O:比MapReduce快10-100倍
- 数据本地性:计算尽量靠近数据位置
- 懒执行(Lazy Evaluation):优化整个执行计划
- 与DataFrame的架构关系:
- DataFrame在RDD基础上增加:
- 结构化schema信息
- Catalyst查询优化器
- Tungsten执行引擎
- 但底层仍然基于RDD的分布式执行模型
这种理解对于设计高性能、高可用的分布式计算系统至关重要。RDD是Spark架构的基石,即使现在的高级API(DataFrame/Dataset)也构建在RDD之上。