Module 02 · Introduction to the Hadoop Ecosystem
HBASEHBase 列式数据库
欢迎观看《HBase》视频!通过观看此视频,您将能够:
- 定义 HBase
- 描述 HBase 作为列式数据库的特性
- 列举 HBase 的功能与用途
- 概述 HBase 和 HDFS 的区别
- 描述 HBase 架构
- 讨论 HBase 的核心概念
什么是 HBase?
HBase 是一种列式非关系型数据库管理系统,运行在 Hadoop 分布式文件系统(HDFS)之上。它为稀疏数据集提供容错存储方式,确保系统在服务器崩溃等不利条件下仍能继续工作。
HBase 的用途与特性
- 实时数据和随机读写访问:HBase 非常适用于需要实时处理和随机读写访问的大数据应用。
- 写重型应用:HBase 主要用于存储大量数据集,并提供实时的处理和分析。
- 线性可扩展性:HBase 支持水平和模块化扩展,能够处理 PB 级别的数据。
- 列族(Column Families):HBase 没有固定的列,数据是根据列族进行定义的。列族是表的一个逻辑分组,列的数据会存储在一起,优化了读取性能。
HBase 与 HDFS 的区别
| 特性 | HBase | HDFS |
|---|---|---|
| 数据存储 | 按行和列存储数据 | 数据在不同节点间以块的形式分布存储 |
| 数据访问方式 | 动态变化,支持增删改查 | 存储不可变,只能进行批量读取操作 |
| 适用场景 | 适用于高频读写、更新和删除 | 适用于大规模数据存储,适合批量数据处理 |
| 架构灵活性 | 允许动态变更 | 架构固定,不允许改变 |
HBase 允许动态更改,而 HDFS 的架构则较为刚性,无法进行更改。HBase 适合用于处理动态的、需要频繁读写的记录级工作负载,而 HDFS 主要用于存储数据,不适用于频繁修改。
HBase 架构
HBase 架构由四个主要组件组成:
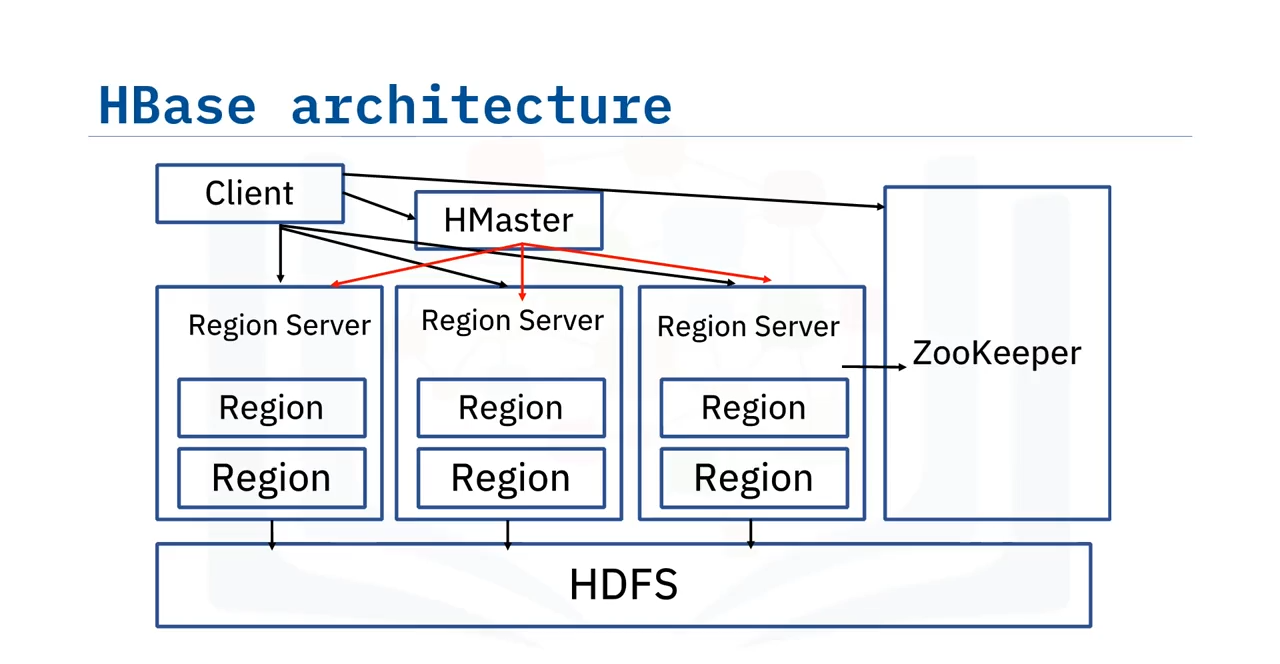
- HMaster:主服务器,负责监控 RegionServer 实例,分配区域给 RegionServer,管理模式和元数据操作的更改。
- HRegionServer:负责处理客户端的读写请求,并将这些请求分配给包含目标列族的具体 Region。
- HRegion:HBase 集群中的基本单元,包含多个列族的数据,每个 Region 由两个主要部分组成:HFile 和 Memstore。
- ZooKeeper:一个集中式服务,负责维护配置,并在节点之间维持健康的连接。它用于跟踪服务器故障、网络分区,并通过触发错误消息来修复失败的节点。
HBase 的数据存储
HBase 数据以列族为单位存储。每个列族包含多个列,它们存储在一起,优化了读取性能。例如,可以将“患者姓名”和“患者年龄”存储在同一个列族“Patient Details”下。
Region 和 RegionServer
- Region 是 HBase 中的最小数据单元,包含多个列族的数据。
- RegionServer 负责管理多个 Region,并处理读写请求。它与客户端直接通信,而不需要每次都通过 HMaster。
ZooKeeper 的作用
- ZooKeeper 维护节点之间的同步,处理服务器故障,并提供集群的一致性。
总结
在本视频中,您学到了:
- HBase 是一个列式非关系型数据库管理系统,运行在 HDFS 上。
- HBase 的列由列族定义,支持线性扩展和高效数据处理。
- HBase 与 HDFS 的主要区别在于,HBase 支持动态数据更改,而 HDFS 主要用于存储数据。
- HBase 架构 由 HMaster、RegionServer、Region、ZooKeeper 和 HDFS 组成,共同提供高效的数据存储与处理能力。
HBase 提供了灵活、高效的数据存储和查询能力,适用于处理大规模数据集,并支持实时分析。