Module 01 · What Is Big Data?
Parallel Processing, Scaling, and Data Parallelism大数据的并行处理与可扩展性
欢迎观看本视频!通过本视频的学习,您将能够:
- 解释为什么大数据需要并行处理。
- 识别线性处理与并行处理的区别。
- 识别为什么并行处理适用于大数据。
- 解释并行处理与可扩展性。
- 描述水平扩展的动机。
- 演示“令人轻松并行”(Embarrassingly Parallel)计算。
- 解释并行计算中的容错机制。
数据处理方式:线性处理 vs 并行处理
1.线性处理(Linear Processing)
- 线性处理 是传统的计算方法,将问题拆解为一组指令,按顺序执行,直到所有指令都执行成功。
- 如果在某个指令执行过程中发生错误,必须从头开始重新执行指令,直到错误解决。
- 线性处理最适合用于简单的计算任务,但对于复杂问题,如大数据处理,它显得低效且耗时。
2.并行处理(Parallel Processing)
- 相较于线性处理,并行处理 将问题拆解为可并行执行的多个指令,分配到多个处理节点上执行。
- 各个节点独立处理指令,错误可以在本地解决,而不影响其他指令的执行。
- 并行处理 在处理复杂问题,如大数据时,具有显著优势。
并行处理的优势
- 减少处理时间:并行处理可以大大缩短大数据处理的时间,比线性处理要高效得多。
- 降低内存和处理需求:指令被分配到多个节点上执行,因此内存和处理需求较低,即使处理大量数据。
- 灵活性:并行处理的最大优势之一是可以根据需要随时添加或移除执行节点,从而显著降低基础设施成本。
可扩展性与水平扩展
1.数据扩展(Data Scaling)
- 处理大量数据的技术称为 数据扩展,即管理、存储和处理数据溢出的方法。
- 一种方法是通过增加更大的单节点计算机进行扩展,但当数据量呈指数级增长时,单一节点最终会超出其承载能力。
- 更好的策略是 水平扩展(Scaling Out),即增加多个具备相同处理能力的节点,直到问题变得可处理为止。
- 这些节点组成了一个 计算集群(Compute Cluster),用于解决“令人轻松并行”的计算任务。
2.“令人轻松并行”计算
- “令人轻松并行”计算 是指可以轻松拆分并独立运行的工作负载。
- 例如,在一个大数据集中的某一列中更改日期格式,数据集被拆分成多个小块存储在不同的节点上。
- 如果某个计算失败,不会影响其他计算,可以重新执行。
复杂计算与协作
- 当排序一个大型数据集时,计算的复杂性增加。此时,多个计算必须相互协调,每个计算过程需要了解其同伴的状态,才能完成整个计算。
- 这需要通过网络相互传递消息,或者通过文件系统进行协调,这显著增加了计算的复杂性。
水平扩展中的并行计算
- 水平扩展 即是添加更多机器或节点来应对增加的工作负载,提升系统的处理能力和灵活性。
- 在 Hadoop 生态系统中,“将计算带到数据” 是设计集群时的核心思想,计算会尽可能地在数据本地进行,这样能减少数据传输的成本。
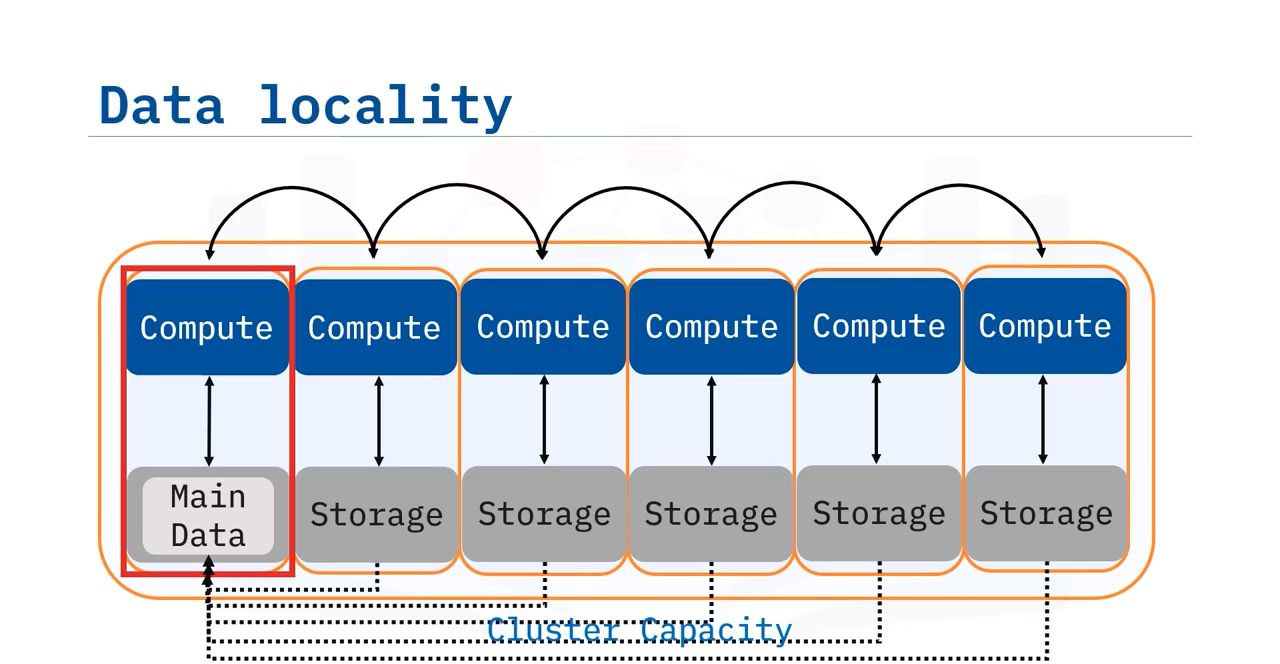
容错机制与大数据处理
1.容错(Fault Tolerance)
- 容错 是指系统在某些组件出现故障时,能够继续正常工作的能力。
- 在 Hadoop 的主数据存储系统 HDFS 中,数据会有多个副本存储在集群的不同节点上。如果某个节点发生故障,可以通过复制其他节点上的数据来恢复丢失的数据分区。
结语
在本视频中,您学到了以下内容:
- 大数据 需要并行处理,因为数据量过大,无法在单台计算机上处理。
- 线性处理 是顺序执行,而 并行处理 则可以同时处理多个指令。
- 并行处理 对比线性处理有显著优势,尤其适合处理大数据。
- 并行计算中的并行化 是通过多个处理器并行工作,将数据分配到不同节点上处理。
- 水平扩展(Scaling Out) 是通过增加更多机器来应对工作负载的增加,提高容量和灵活性。
- “令人轻松并行” 计算任务能够轻松拆分并独立运行,具有高容错性,若某一任务失败,其他任务不受影响,能够重新执行。