Module 02 · Introduction to the Hadoop Ecosystem
Intro to MapReduceMapReduce 简介
欢迎观看《MapReduce简介》视频!通过观看此视频,您将能够:
- 解释 MapReduce 中的 Map 和 Reduce 任务
- 描述 为什么我们使用 MapReduce
- 列举 MapReduce 的组件
- 概述 MapReduce 的常见使用案例
MapReduce 的概述
MapReduce 是一种编程模式,能够实现跨数百或数千台服务器的 大规模扩展,并且是 Apache Hadoop 的核心处理组件。它是一种分布式计算的处理技术和编程模型,基于 Java 实现。
什么是分布式计算?
分布式计算是一种将多个组件分布在不同计算机上的系统。每个组件有自己的任务,但这些组件通过相互通信,协同完成最终的计算任务。
MapReduce 的工作原理
MapReduce 算法包含两个重要任务——Map 和 Reduce。
Map 任务
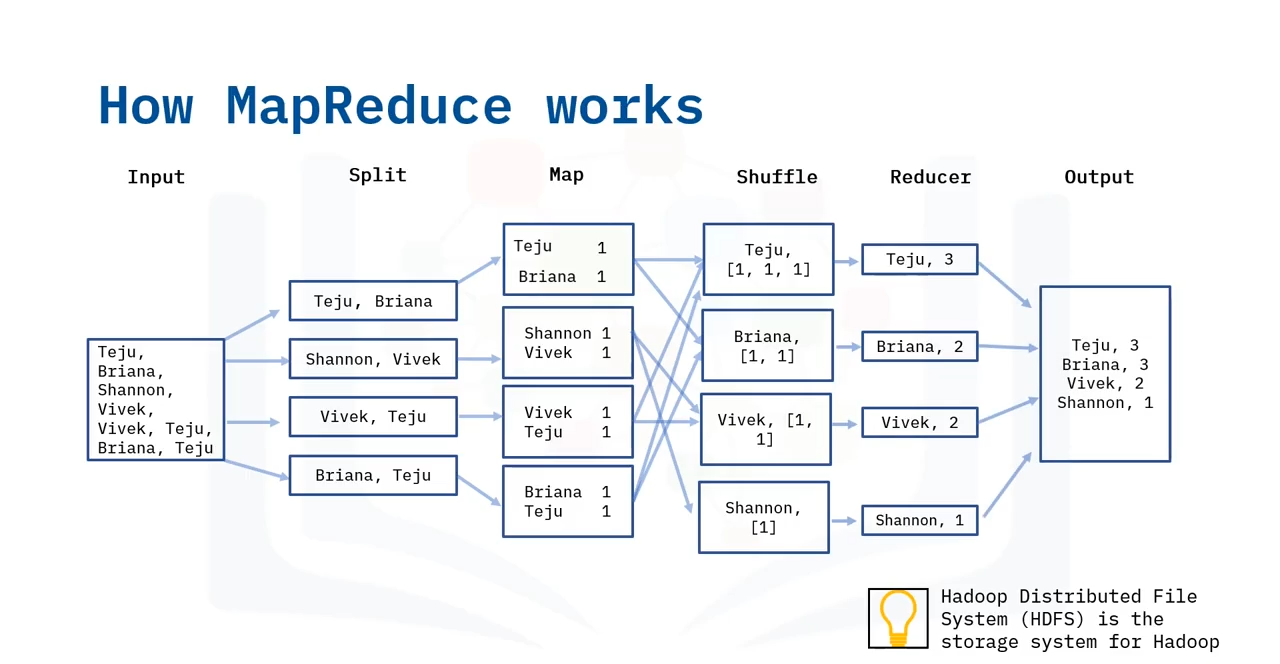
Map 任务接收输入文件,进行一些映射处理,将重要的数据提取并转化为 键值对。这些键值对是初步的输出数据。经过一定的重组后,这些数据会被传送到 Reducer 进行进一步处理。
Map 任务的流程:
- 输入数据 是存储在 Hadoop 文件系统 HDFS 中的文件。
- 比如,我们有一个包含人员姓名的输入文件,目标是对姓名的出现次数进行 词频统计。
- 数据会被拆分成多个文件,每个文件中的内容都是键值对形式。
例如,假设我们有 "Teju" 和 "Briana" 这两个名字,每个名字会生成一个键值对,并且在文件中记录其出现的次数。
Reduce 任务
Reducer 任务接收来自 Map 的数据并进行处理,最终生成新的输出数据,存储在 HDFS 中。
Reduce 任务的流程:
- Shuffle 阶段:它对键和值进行排序。例如,"Teju" 可能对应的值是
[1, 1, 1],意味着 "Teju" 在 Map 阶段出现了 3 次。 - 聚合:Reducer 对这些值进行聚合处理,生成最终的结果。
- 输出结果:最终的结果会保存在一个输出文件中。
MapReduce 的优势
MapReduce 的优势在于它可以在 多个节点 上高效并行地处理任务,从而极大提高处理速度。
节点和并行处理
在 Hadoop 中,我们有两种类型的节点:
- NameNode:负责管理文件系统的元数据。
- DataNode:负责存储实际的数据。
MapReduce 通过将任务拆分为独立的子任务,并行运行,从而节省时间。
灵活性
MapReduce 支持处理各种形式的数据,包括表格数据和非表格数据。它能够适应各种不同数据结构,无论是结构化数据还是非结构化数据,都能提供业务价值。
MapReduce 的使用案例
MapReduce 在多个行业和场景中有广泛应用,以下是一些常见的使用案例:
- 社交媒体平台(如 LinkedIn 和 Instagram):
- 用于分析谁访问了你的个人资料、查看了你的帖子并与之互动。
- 流媒体平台(如 Netflix):
- 用于根据用户的观看历史推荐电影,分析用户兴趣。
- 金融机构(如银行和信用卡公司):
- 用于检测和标记用户交易中的异常行为。
- 广告行业:
- 通过分析用户与广告的互动,了解用户行为。Google 广告就使用 MapReduce 来分析用户对广告的互动情况。
总结
在本视频中,您学到的内容包括:
- MapReduce 是一个并行计算框架,包含两个主要任务:Map 和 Reduce。
- Map 任务将数据处理为键值对,进行排序和组织。
- Reducer 任务对数据进行聚合和计算,生成最终的输出结果。
- MapReduce 对所有类型的数据(如结构化数据和非结构化数据)都非常灵活,并且可以广泛应用于多个行业,如社交媒体、娱乐等。