Module 03 · Object Detection
Transpose Convolutions转置卷积
转置卷积(Transpose Convolution) 是 U-Net 架构中的一个关键组成部分。它的作用是将输入的较小尺寸的特征图放大为更大的输出。例如,如何将一个 2×2 的输入图像扩展为 4×4 的输出?转置卷积正是解决这个问题的工具。让我们深入了解一下它的工作原理。
常规卷积与转置卷积的区别
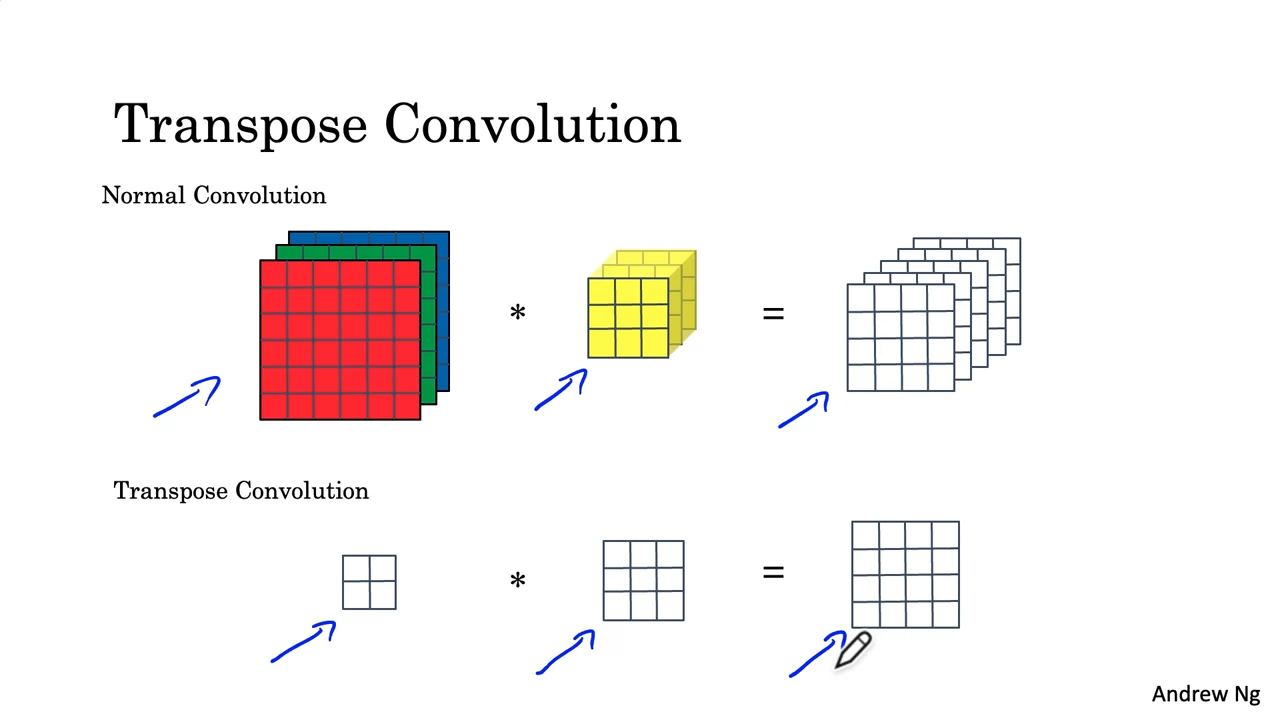
你已经熟悉 常规卷积(Convolution),在常规卷积中,一个典型的神经网络层输入的图像尺寸可能是 6×6×3,经过 3×3×3 的滤波器卷积后,输出图像的尺寸会变为 4×4×5。而 转置卷积 则稍有不同,它的目标是将输入的尺寸放大。
- 比如,输入为 2×2 的激活图,经过一个 3×3 的滤波器卷积,输出将变为 4×4,即大于原始输入的尺寸。
转置卷积的详细示例
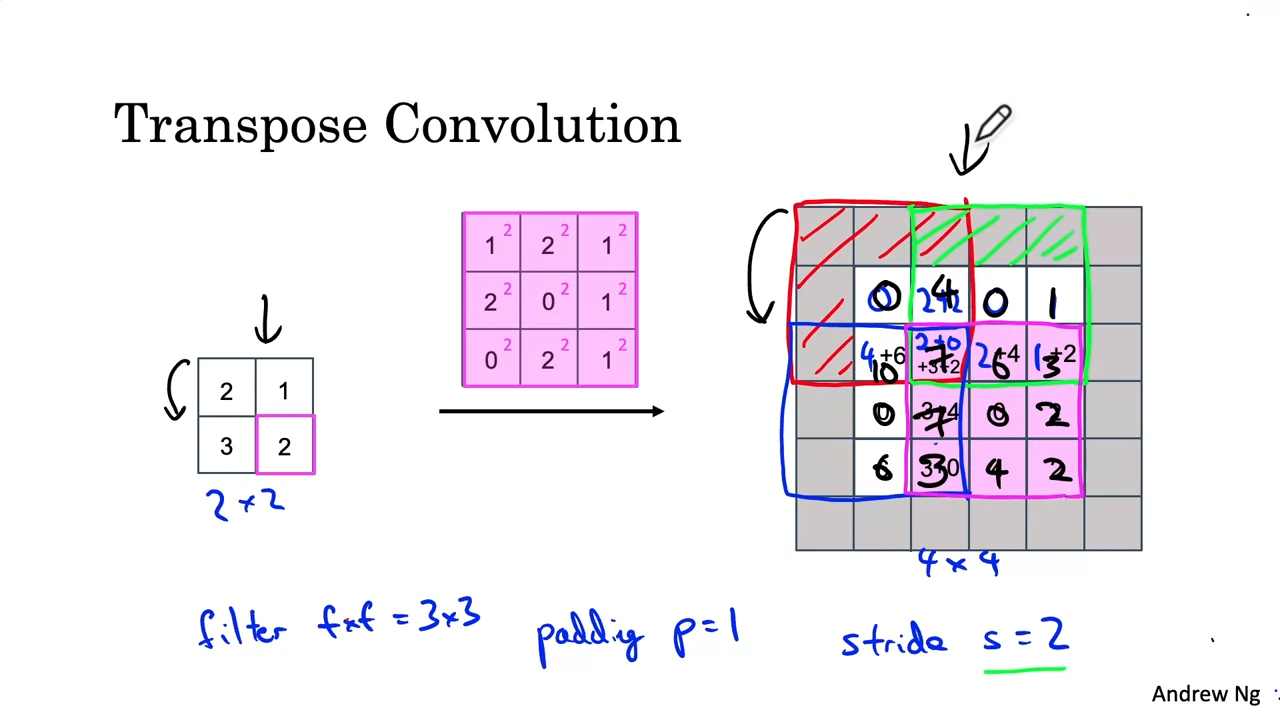
为了更好地理解转置卷积的工作原理,下面我们通过一个具体的例子来讲解如何实现从 2×2 输入扩展到 4×4 输出。
输入与设置
- 输入图像尺寸:2×2
- 滤波器尺寸:3×3
- 填充(Padding):p=1
- 步幅(Stride):s=2
转置卷积计算过程
- 第一步:应用滤波器
从输入图像的左上角开始,选择第一个 2,将其与 3×3 的滤波器中的每个值相乘,并将结果粘贴到输出图像上。这时,填充区域没有数值,因此我们会忽略填充区域,直接填入 4×4 的输出区域。
- 红色区域:我们将滤波器的结果应用到这个区域:
- 第二步:应用第二个输入值
接下来,我们用输入值 1 进行操作,类似地,乘以滤波器中的每个元素,然后将结果复制到输出的适当位置。因为步幅为 2,我们需要将滤波器移动两步:
- 复制数值到 绿色区域,并进行重叠处理,重叠区域的值相加:
- 2 + 2 = 4
- 0 + 2 = 2
- 依此类推。
- 第三步:应用输入值3
对于输入值 3,我们将滤波器应用到其对应区域。并同样处理重叠区域:
- 乘以滤波器中的每个元素,得到新的输出值:
- 第四步:应用最后的输入值2
最后,我们将 2 与滤波器中的每个元素相乘,并将其填入相应的输出区域。
- 结果如下:
- 依此类推填入输出矩阵。
输出结果
最终,通过上面的一系列操作,我们得到了一个 4×4 的输出矩阵。每个位置的值都是前面计算得到的结果。
| 位置 | 输出值 |
|---|---|
| (1, 1) | 0 |
| (1, 2) | 4 |
| (1, 3) | 0 |
| (1, 4) | 2 |
| (2, 1) | 2 |
| (2, 2) | 4 |
| (2, 3) | 2 |
| (2, 4) | 2 |
| (3, 1) | 6 |
| (3, 2) | 3 |
| (3, 3) | 0 |
| (3, 4) | 0 |
| (4, 1) | 2 |
| (4, 2) | 2 |
| (4, 3) | 2 |
| (4, 4) | 2 |
为什么要使用转置卷积?
你可能会问,为什么要使用转置卷积?事实上,转换小的输入为大的输出有多种方法,而转置卷积由于其有效性,在实现 U-Net 等语义分割算法时,能够得到非常好的结果。通过这些卷积操作,能够有效地扩展特征图的尺寸,使得 U-Net 的网络架构可以执行高质量的 语义分割。
构建 U-Net:实现转置卷积
在本视频中,我们详细讲解了如何通过转置卷积将 2×2 的输入放大为 4×4 的输出。这是 U-Net 架构的核心构建模块,而你将在本周的编程练习中实际操作并实现这一部分。
总结
转置卷积 是语义分割中不可或缺的工具,通过将小尺寸的输入图像扩展为更大的输出图像,它帮助 U-Net 在图像分割任务中实现高效的性能。现在,你已经理解了转置卷积的原理,接下来,我们将继续深入了解 U-Net 架构,以及它如何在语义分割中发挥作用。
下一步:U-Net架构中的应用
在下一个视频中,我们将继续探讨 转置卷积 在 U-Net 架构中的具体应用,并介绍如何在语义分割任务中使用这个构建块。我们下个视频见!