Module 03 · Object Detection
YOLO AlgorithmYOLO 算法
在本视频中,我们将把目标检测的所有组件结合在一起,构成 YOLO 目标检测算法。首先,我们来了解如何构建训练集。
构建训练集
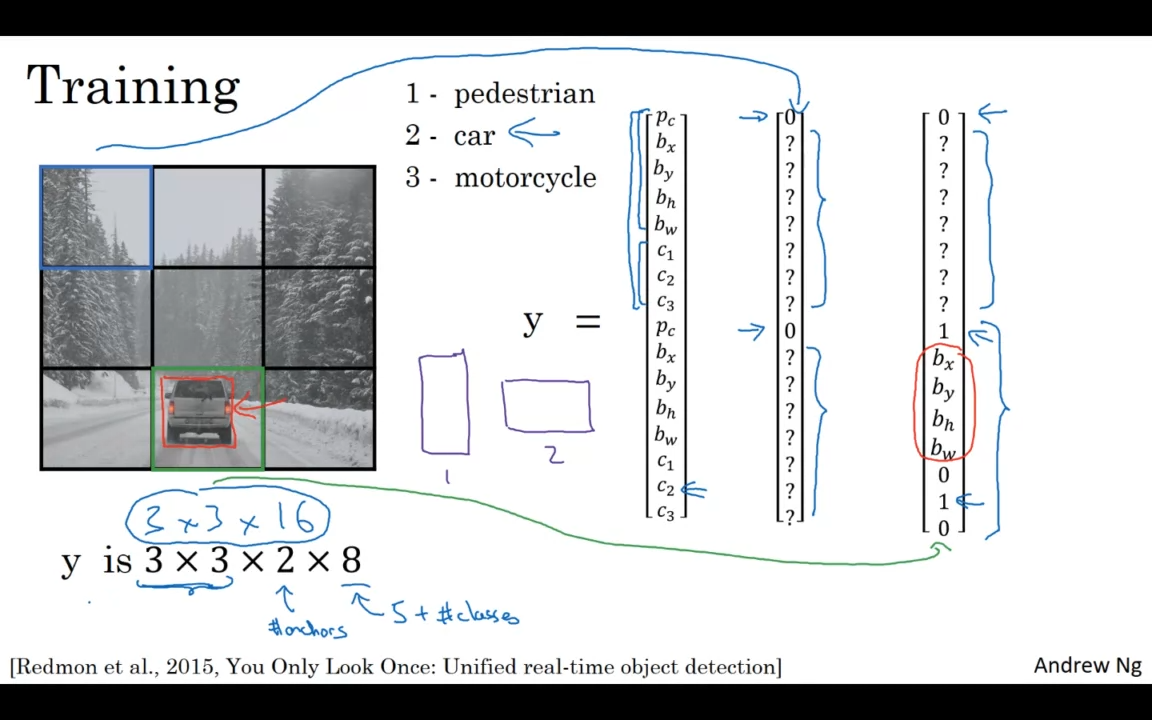
假设你正在训练一个算法来检测三种物体:行人、汽车 和 摩托车。同时,你还需要明确 背景类,即不属于这三类的物体也需要标注为背景。
输入输出维度说明
- 假设你使用 两个锚框,那么输出 y 的维度为 3x3,这是因为你使用的是 3x3 网格单元。
- 输出维度:
- 第一维为 3x3(表示网格单元的数量)。
- 第二维为 2,表示有 两个锚框(Anchor Boxes)。
- 第三维为 8,这表示每个锚框对应的输出维度。8包括:
- 5:包含了 Pc(物体存在的概率) 和 边界框参数(Bounding Box),即 PC, PX, PY, PH, PW。
- 3:表示物体的 类别(C1, C2, C3),即行人、汽车和摩托车。
因此,输出 y 的维度可以表示为:
3x3x2x8 或 3x3x16。
训练过程:为每个网格单元生成目标向量 y
- 空网格单元的处理:
- 对于没有目标物体的网格单元,例如左上角的网格单元,其对应的目标向量 y 应该如下:
- Pc = 0(没有物体存在)。
- 对应的 锚框 和 类别 的其他部分都为“不关心” (don’t care)。
- 包含目标物体的网格单元:
- 假设在某个网格单元中检测到了一辆 汽车,该汽车的边界框比高稍宽。
- 假设有两个锚框,锚框1是较为方形的,锚框2稍微宽一些。
- 如果汽车的形状与锚框2更匹配,那么该汽车的目标向量 y 应该如下:
- 对于锚框1,Pc = 0。
- 对于锚框2,Pc = 1(表示物体是汽车)。
- 包括汽车的 边界框信息 和 类别标签(C2 = 1)。
- 如果汽车的形状与锚框2更匹配,那么该汽车的目标向量 y 应该如下:
通过这种方式,每个网格单元都会输出一个 16维向量(3x3x16)。在实际应用中,可能会使用更大的网格(如 19x19),并且可以使用更多的锚框(例如 5个锚框)。
YOLO的训练过程
你会训练一个 卷积神经网络(ConvNet)输入图像(例如 100x100x3),并最终输出一个形状为 3x3x16 或 3x3x2x8 的输出卷积结果。
YOLO目标检测:预测过程
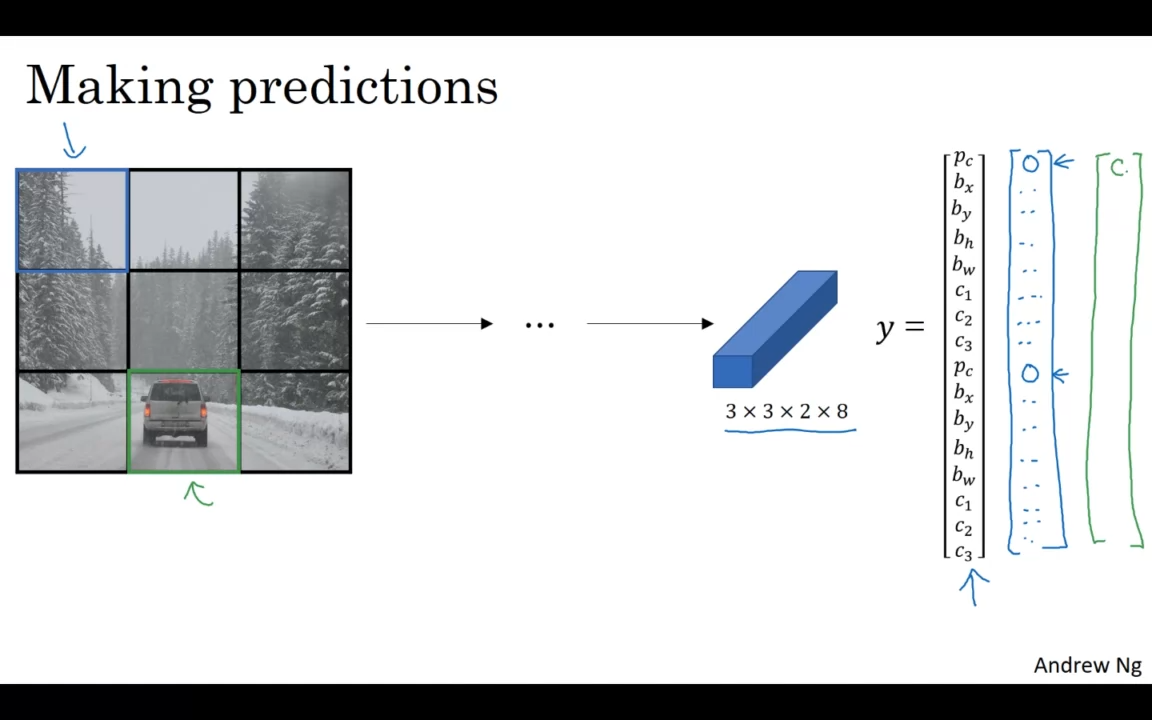
给定一个图像,神经网络 会输出一个形状为 3x3x2x8 的张量,其中每个网格单元会输出一个向量。例如:
- 对于网格单元 左上角,如果没有物体,神经网络应该输出 0(没有物体),并且其它值将被视为“噪声”。
- 对于检测到 汽车 的网格单元,神经网络应该:
- 对 锚框1 输出 0(没有汽车)。
- 对 锚框2 输出正确的边界框信息和类别标签(C2=1),并忽略其它值。
非极大值抑制(NMS)
接下来,我们使用 非极大值抑制(NMS)来优化预测结果。
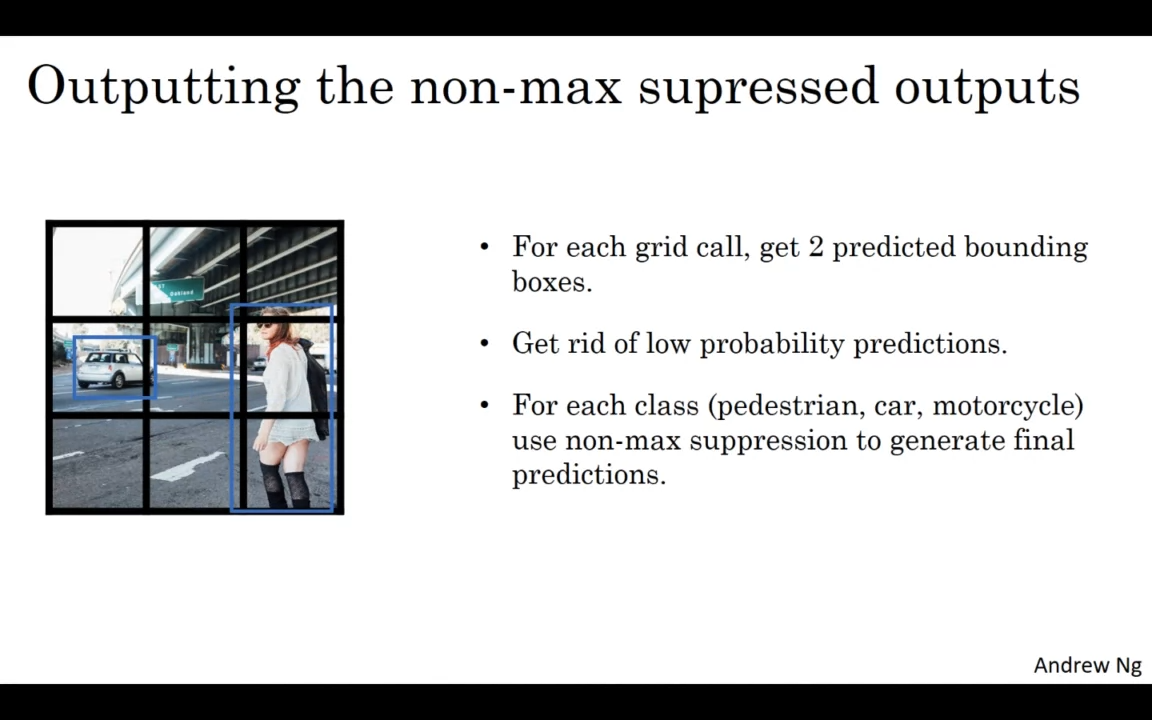
- 每个网格单元的预测:
- 如果你使用 两个锚框,每个网格单元会输出两个预测的边界框。
- 一些边界框可能有很低的概率(Pc),因此需要去除低概率的预测。
- 去除低概率预测:
- 对于那些概率低的预测,即使神经网络认为该物体的概率较低,我们也应该将其去除。
- 对每个类别分别执行NMS:
- 如果你要检测 三类物体(行人、汽车、摩托车),你需要对每个类别分别运行 NMS:
- 对 行人类别运行NMS。
- 对 汽车类别运行NMS。
- 对 摩托车类别运行NMS。
这样可以确保每个类别的物体都被准确检测到。
总结:YOLO目标检测算法
YOLO(You Only Look Once)是一种非常高效的目标检测算法,集成了计算机视觉领域中许多最优秀的想法。它通过将图像划分为网格,并在每个网格上预测多个边界框,从而实现高效的目标检测。
YOLO的应用
- 你将在本周的练习中有机会 实践实现 YOLO算法的各个组件,并加深对目标检测的理解。
- 此外,视频后还有一个 可选的视频,可以根据自己的兴趣选择观看。
下周再见! 🎥