Module 03 · Object Detection
Bounding Box Predictions边界框预测
在上一个视频中,我们学习了如何使用卷积实现滑动窗口目标检测算法,提升了计算效率。然而,这个方法依然存在一个问题:边界框(Bounding Box)的预测不够准确。今天,我们将探讨如何提高边界框的精确度。
滑动窗口问题:边界框不够精确
在传统的滑动窗口方法中,我们通过将图像划分为多个小区域,然后将每个区域传入分类器进行预测。然而,这样的方法有一个明显的缺点:并不是每个框都能完美匹配目标物体的位置。例如,图像中的物体(如汽车)的真实边界框,可能并不是完全正方形的,它可能具有某种水平长宽比。
如何让边界框更加准确?
YOLO(You Only Look Once)算法可以解决这一问题。YOLO的核心思想是:通过将图像划分为网格,并为每个网格单元预测目标的位置和类别。具体实现方法如下:
YOLO 算法原理
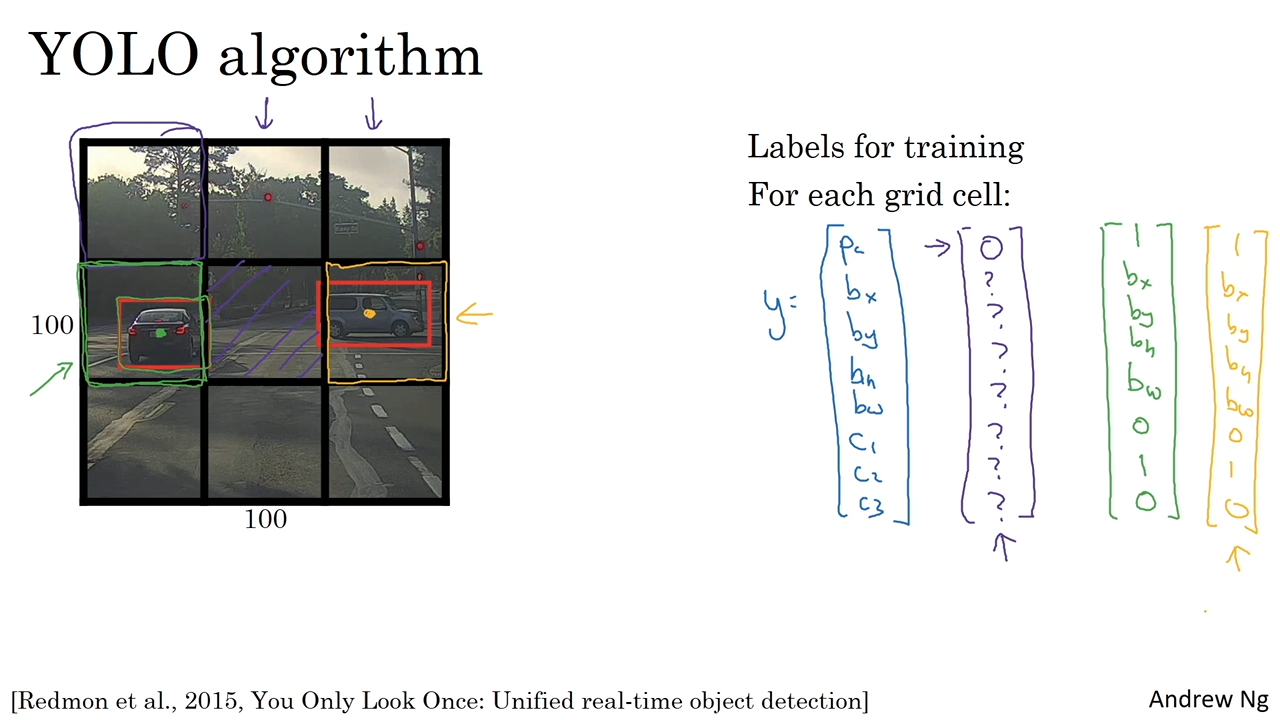
假设我们有一张 100x100 的输入图像,我们将在这张图像上划分一个网格。在示范中,我们使用 3x3 网格(实际应用中可能使用更细的网格,如 19x19)。基本的想法是,将图像分类和定位算法应用到网格中的每个单元格上。
标签定义
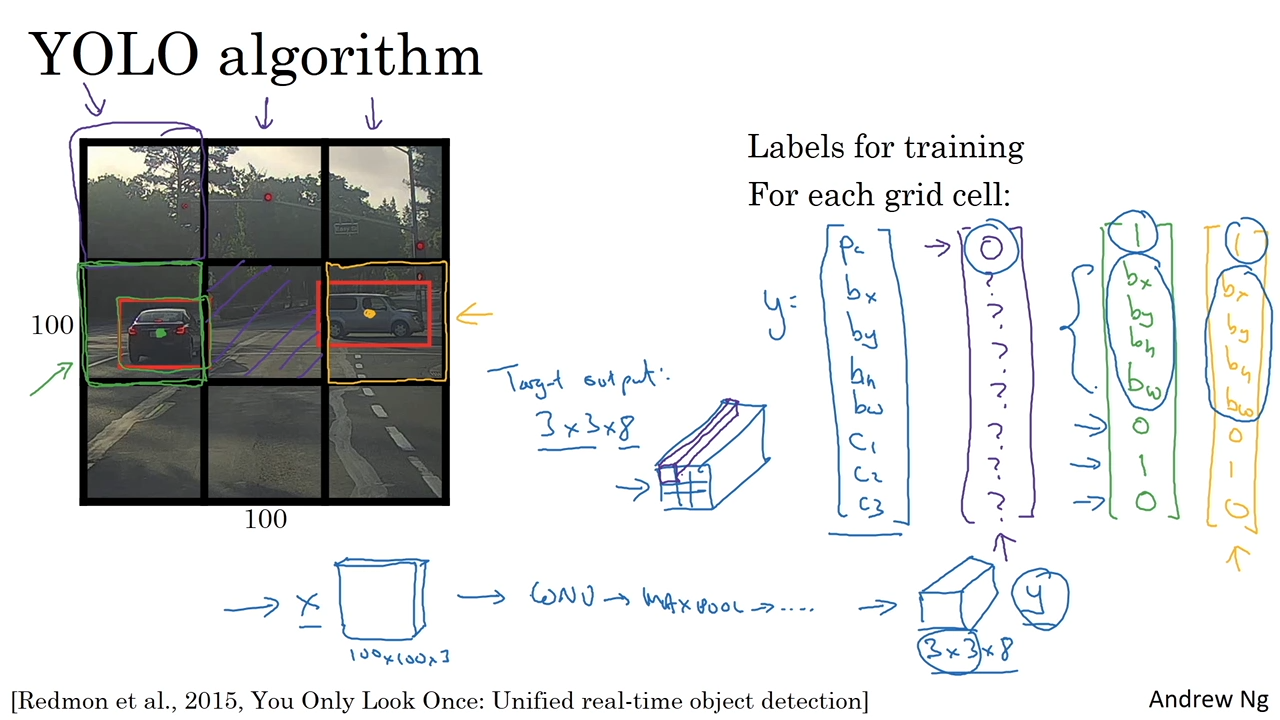
对于每个网格单元格,定义一个标签 Y,该标签是一个8维的向量:
- PC(概率值):表示该网格单元格是否包含物体。
- BX, BY, BH, BW:定义目标物体的边界框(Bounding Box)。
- BX:边界框中心点的 X 坐标。
- BY:边界框中心点的 Y 坐标。
- BH:边界框的高度。
- BW:边界框的宽度。
- C1, C2, C3:如果我们要识别多个类别的物体(如行人、汽车、摩托车),则用这些值表示各个类别的概率。
每个网格单元的标签示例
对于上面提到的 3x3 网格中的每个单元,假设图像中有两个物体:
- 对于没有物体的网格单元,标签为
[0, 不关心, 不关心, ...]。 - 对于包含物体的网格单元,标签为包含物体的位置、尺寸和类别的 8 维向量。
例如,在图像中的左侧,左侧的汽车位于左上网格单元内,所以该单元的标签可能如下:
- PC = 1(表示该位置有物体)
- BX, BY, BH, BW:汽车边界框的坐标。
- C1, C2, C3:对应类别的标签(如 C1 = 0, C2 = 1, C3 = 0,表示是“汽车”)。
在图像右侧,右侧的汽车位于右下网格单元内,标签也会相应定义。
标签矩阵示意图
| 网格位置 | 标签 Y (8维向量) |
|---|---|
| 上左 | [0, 不关心, 不关心, ...] |
| 上中 | [0, 不关心, 不关心, ...] |
| 上右 | [0, 不关心, 不关心, ...] |
| 中左 | [1, BX, BY, BH, BW, C1, C2, C3] |
| 中中 | [0, 不关心, 不关心, ...] |
| 中右 | [0, 不关心, 不关心, ...] |
| 下左 | [1, BX, BY, BH, BW, C1, C2, C3] |
| 下中 | [0, 不关心, 不关心, ...] |
| 下右 | [0, 不关心, 不关心, ...] |
神经网络训练
- 输入:100x100x3的图像。
- 目标输出:3x3x8 的输出体积,每个网格单元输出一个8维的标签。
- 训练:使用反向传播算法,根据真实标签与预测输出之间的误差调整网络参数。
通过这样训练,YOLO算法能够在每个网格单元中准确预测目标的边界框和类别。
YOLO 的优势
- 高效性:YOLO 是一个单一的卷积神经网络(CNN),它能够在一次前向传播中同时预测整个图像的目标位置和类别,而不像传统的滑动窗口方法那样需要多次处理图像。
- 实时性:YOLO的卷积实现使得它能够非常快速地执行,因此可以进行实时目标检测。
- 更精确的边界框:YOLO不仅能够预测目标的位置,还能够预测各种长宽比的边界框,精度较高。
应用细节:边界框编码
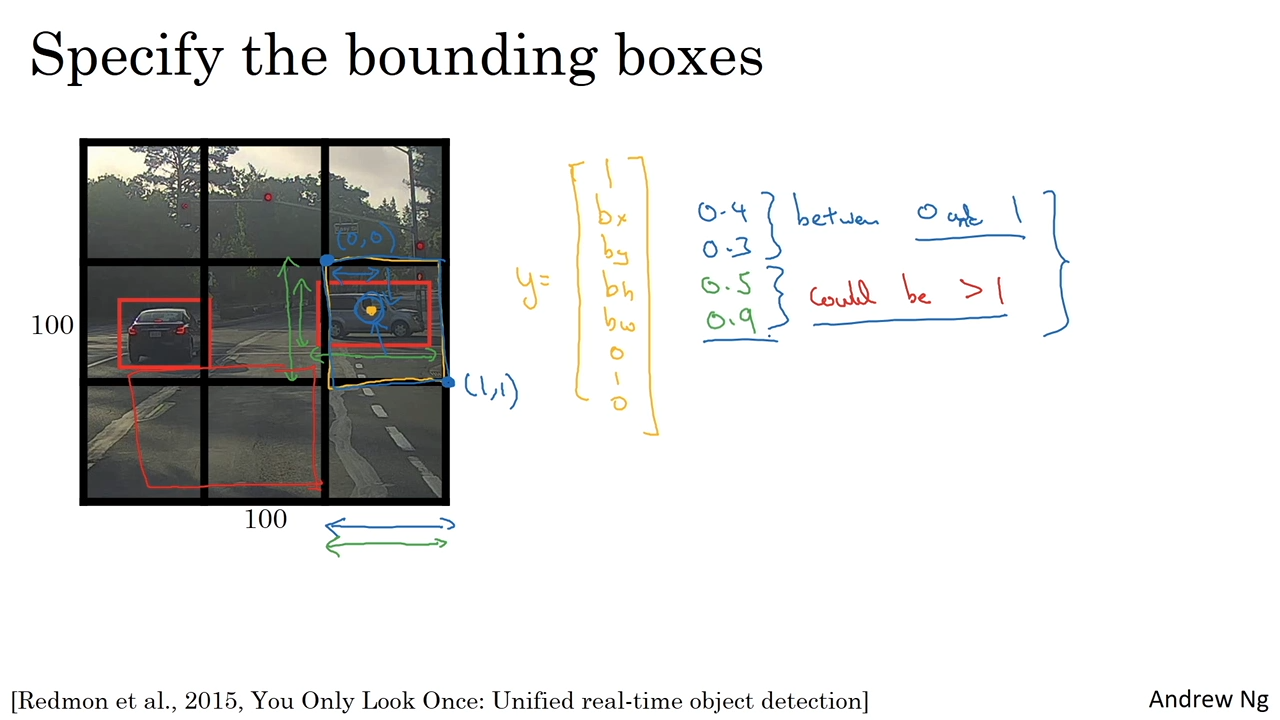
为了精确地定义边界框,我们将采用相对坐标表示方法。
- BX 和 BY:目标中心点的位置,取值范围是 [0, 1]。
- BH 和 BW:目标的高度和宽度,相对于网格单元的比例。
例如,右侧的汽车的边界框可能如下:
- BX = 0.4(表示目标中心点的横坐标位于网格单元的 40% 处)
- BY = 0.3(表示目标中心点的纵坐标位于网格单元的 30% 处)
- BW = 0.9(表示目标高度为网格单元宽度的 90%)
- BH = 0.5(表示目标宽度为网格单元高度的 50%)
YOLO的效率与扩展
YOLO的关键优势之一在于它的卷积实现,使得整个检测过程高效且能够实时运行。你不需要分别为每个网格单元(如 3x3 或 19x19)运行算法,而是通过一个统一的卷积网络共享计算资源。
- 使用 3x3 网格:最终输出是 3x3x8 体积。
- 使用 19x19 网格:输出是 19x19x8 体积,能够更精细地预测边界框,减少多物体分配到同一个网格单元的可能性。
总结与后续步骤
YOLO算法通过卷积神经网络实现快速、高效的目标检测,能够在一个前向传播中直接输出精确的边界框和类别预测。
接下来的视频将介绍一些进一步优化YOLO算法的技巧。如果你感兴趣,可以查看 YOLO 的原始论文,虽然它的内容有些难度,但理解它对深度学习的实践非常有帮助。
提醒:阅读YOLO论文可能会遇到一些困难,尤其是如果你是第一次接触。许多研究者在阅读时也曾遇到类似问题。如果感到困惑,可以参考开源代码或向他人请教。
接下来,我们将继续探讨一些能够提升YOLO算法性能的优化方法! 🚀