Module 03 · Object Detection
Object Detection目标检测
在本视频中,我们将进一步学习如何利用卷积神经网络(ConvNet)进行目标检测,采用的算法称为滑动窗口检测算法。这个算法虽然直观,但在实际应用中也面临一些计算效率的问题。接下来,我们将深入了解如何通过滑动窗口方法进行物体检测,特别是如何检测汽车。
构建目标检测模型
准备标注训练集
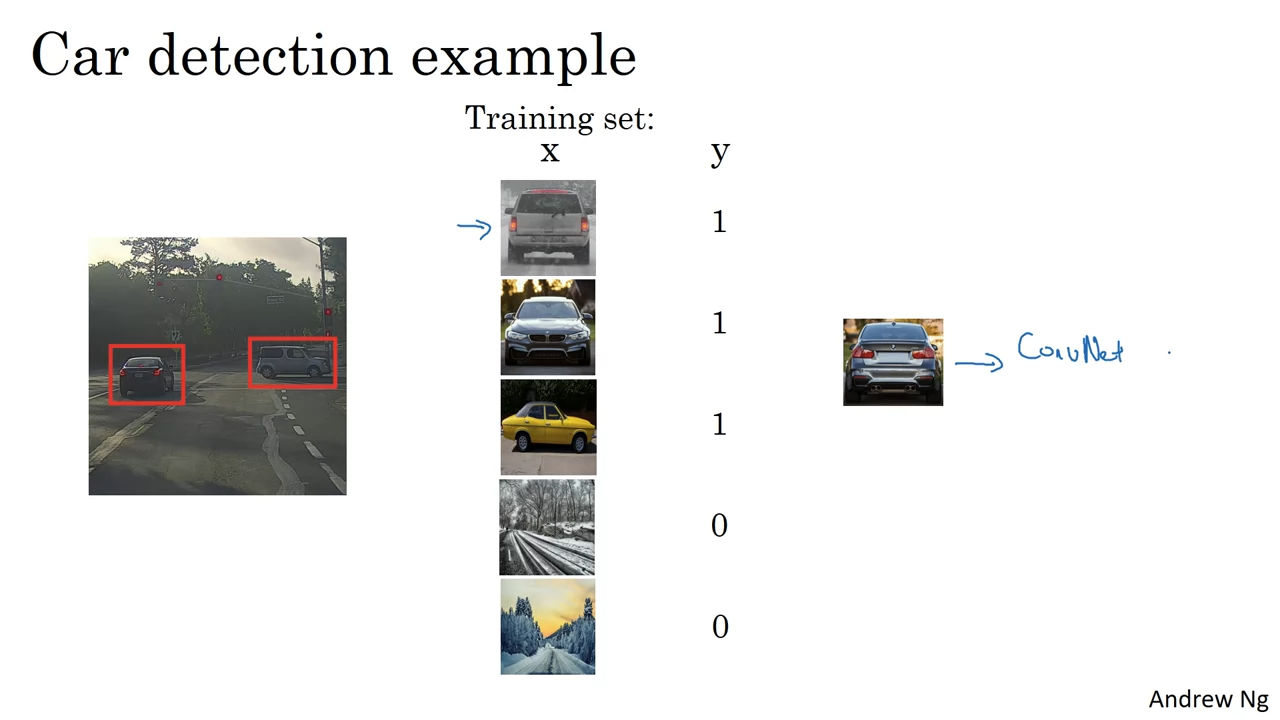
假设你要开发一个汽车检测算法,首先需要准备一个包含汽车图像的标注训练集。你可以通过裁剪图像,去除不属于汽车的部分,只留下汽车的部分。这样,每张训练图像就会包含一辆完整的汽车。训练集的构成如下:
- 正样本:包含汽车的图像。
- 负样本:不包含汽车的图像。
例如,图像 x 包含一辆车,那么相应的标签 y 将为1;如果图像不包含汽车,标签将为0。
使用卷积神经网络(ConvNet)训练模型
你可以使用一个卷积神经网络(ConvNet)来处理这些图像。网络的任务是从输入图像中预测是否存在汽车。
- 输入:经过裁剪的汽车图像。
- 输出:0 或 1,表示图像中是否包含汽车。
训练完成后,ConvNet可以用来进行滑动窗口检测。
滑动窗口检测算法
滑动窗口的基本原理
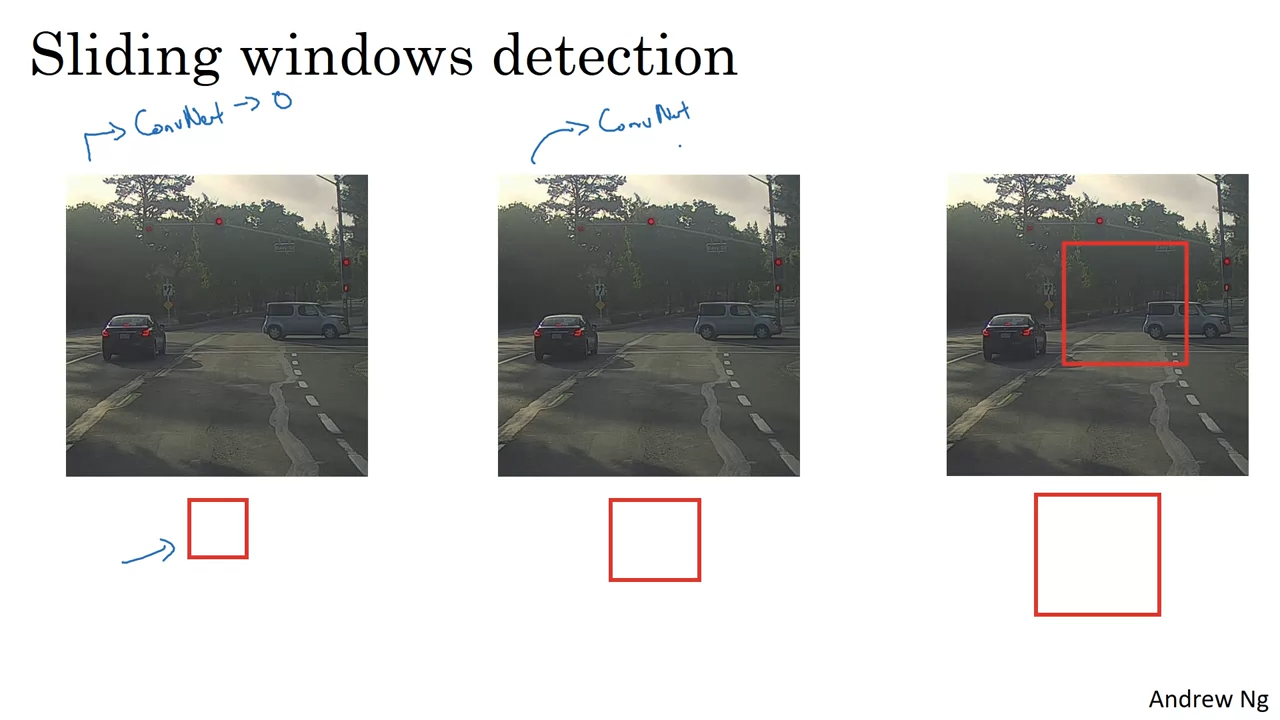
假设你现在有一张待检测的图像。为了应用滑动窗口算法,我们首先需要设置一个窗口大小。接下来,步骤如下:
- 选择一个小窗口,并将其输入到卷积神经网络(ConvNet)中进行预测。
- 如果窗口内没有汽车,ConvNet输出0;如果窗口内有汽车,ConvNet输出1。
然后,你会将窗口沿着图像滑动,逐步检测图像的不同区域。每次滑动时,都会输入一个新的图像区域,ConvNet会对每个区域做出分类判断。
滑动窗口的操作流程
- 初始化窗口:从图像的一个位置开始,将一个小矩形区域作为窗口,输入ConvNet进行检测。
- 滑动窗口:将窗口向右或向下移动,重新输入ConvNet,直到整个图像都被扫描。
- 重复操作:在每个窗口位置都进行分类判断,直到整个图像的每个区域都被处理。
图中的红色框就是我们选择的“窗口”区域。
注意:这里使用了较大的步长(stride),以加快动画演示的速度。在实际应用中,步长的选择会影响检测的精度和计算成本。
逐步增大窗口尺寸
- 在第一次扫描时,你使用一个小窗口。
- 然后,增大窗口尺寸,重新扫描图像。
- 继续增加窗口尺寸,再次扫描,直到整个图像都被处理。
通过这种方式,滑动窗口检测算法能够检测到图像中任何位置的汽车。如果在某个位置,窗口内包含一辆车,ConvNet将输出1,并标记为检测到目标。
滑动窗口检测的挑战
尽管滑动窗口算法直观易懂,但它有一个显著的缺点:计算成本非常高。因为每个窗口都需要单独输入到神经网络进行处理,尤其是当窗口数量非常多时,计算成本急剧增加。
- 大步长:使用较大的步长可以减少需要处理的窗口数,但也可能降低检测精度。
- 小步长:使用较小的步长可以增加检测精度,但会大幅增加计算量,导致处理时间变长。
滑动窗口算法的局限性
- 在没有神经网络的时代,研究人员常用线性分类器和手工特征来进行目标检测。当时,因为计算简单,滑动窗口方法仍能保持可接受的性能。
- 然而,随着卷积神经网络(ConvNet)的出现,单次分类任务的计算变得更加复杂,这使得滑动窗口方法在大规模应用时变得不可行。
优化滑动窗口检测算法
幸运的是,针对滑动窗口算法的计算开销问题,已经有了更高效的解决方案。在接下来的视频中,我们将探讨如何卷积化(convolutionalize)滑动窗口检测,从而显著提高计算效率,解决这一问题。
总结
- 滑动窗口检测算法通过在图像中滑动不同大小的窗口,并使用卷积神经网络对每个窗口进行分类,来检测图像中的目标。
- 该方法的关键步骤包括:选择窗口大小、滑动窗口并分类、逐步增大窗口尺寸。
- 挑战:计算开销巨大,尤其是在处理大图像时,可能导致性能瓶颈。
- 解决方案:在下一期视频中,我们将介绍如何通过更高效的实现方式来优化滑动窗口检测算法。
🎬 在接下来的内容中,我们将展示如何通过卷积化的滑动窗口方法来提高检测效率!