Module 04 · Special Applications: Face recognition & Neural Style Transfer
Face Verification and Binary Classification面部验证与二分类
在面部识别系统的训练中,除了通过 三元组损失(Triplet Loss)来学习网络参数外,还有另一种方法是将面部识别任务视为一个 二分类问题。下面,我们将详细探讨这种方法如何运作。
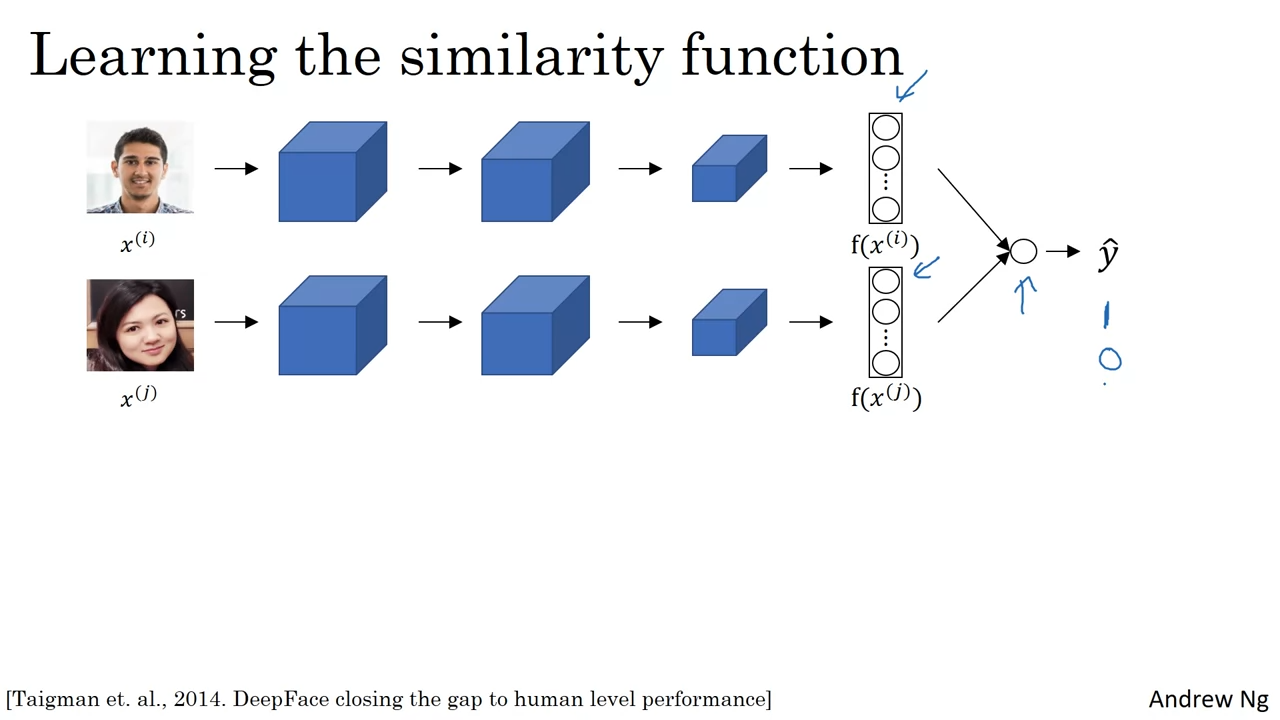
二分类问题:Siamese 网络架构
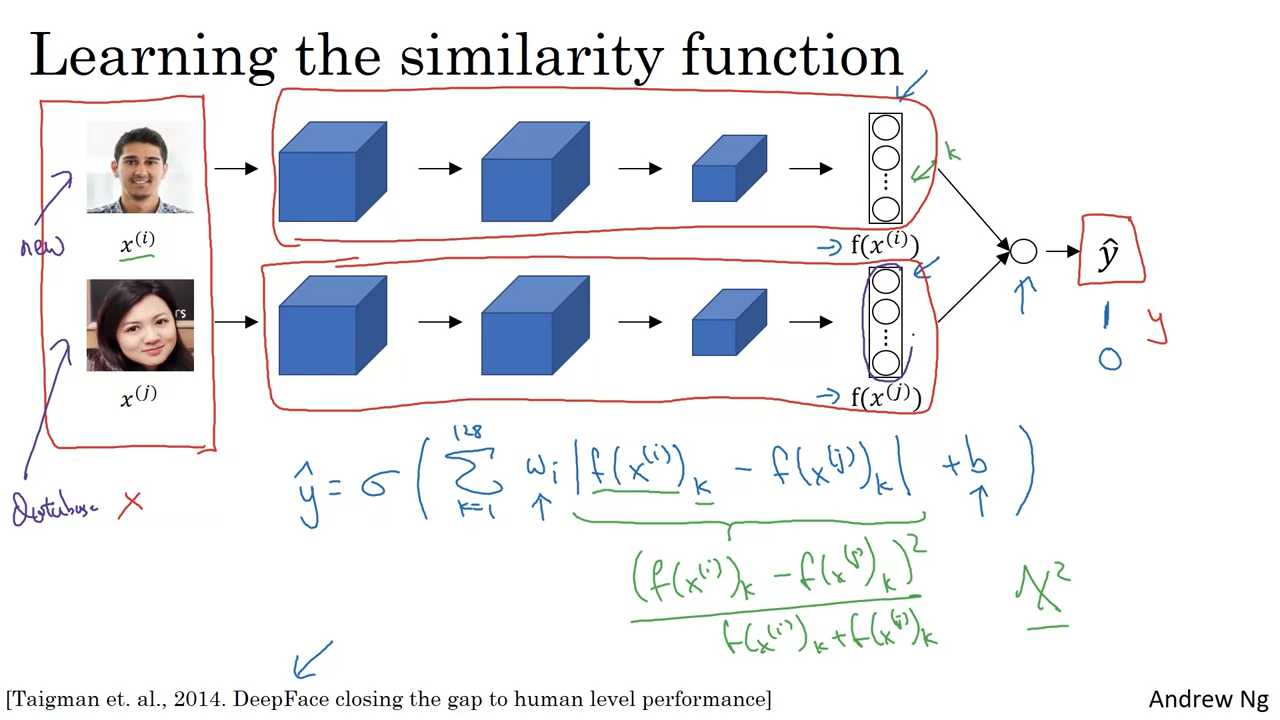
另一种训练神经网络的方式是通过 Siamese 网络(孪生网络)架构,来计算图像的 嵌入向量(embeddings),例如 128维 的嵌入向量,甚至可以更高维。然后,将这些嵌入向量作为输入,传递给 逻辑回归单元(logistic regression unit),进行 二分类预测。
- 如果两张图片属于同一个人,则预测 1。
- 如果两张图片属于不同的人,则预测 0。
这是一种将面部识别问题视为 二分类问题 的方法,也可以作为 三元组损失的替代方法来训练系统。
逻辑回归单元的作用
逻辑回归单元的输出是通过 sigmoid 函数 计算的,这个函数作用于一组特征。除了直接输入这两个图像的嵌入向量外,还可以通过计算这两个嵌入向量的 差值 来生成特征。
计算差异的方法
假设有两个嵌入向量 f(xᵢ) 和 f(xⱼ),我们可以计算这两个向量的 元素级绝对差值:
在这里,f(xᵢ) 表示图像 xᵢ 的嵌入向量,k 表示该向量的第 k 个分量。这个计算结果可以看作是 128 个特征,然后将这些特征输入到 逻辑回归 中,来预测这两张图片是否属于同一个人。
逻辑回归的训练
- wᵢ 和 b 是逻辑回归的参数。
- 训练过程中,逻辑回归模型会学习如何根据这 128 个特征来预测这两张图片是同一个人(输出 1)还是不同人(输出 0)。
其它相似性度量公式
除了简单的差值计算外,还有一些 变种公式 用来计算嵌入向量的差异。例如:
这种公式有时被称为 卡方相似性(Chi-square similarity),在某些应用中也非常有效。
这个公式及其它变种的探讨可以在 Deep Face 论文中找到,之前也提到过。
训练过程
在这个训练过程中:
- 输入:一对图像(xᵢ 和 xⱼ)。
- 输出:目标标签 y,若两张图片是同一人,则 y = 1;若是不同人,则 y = 0。
训练过程中,我们同样使用 Siamese 网络 来共享参数,这样上层网络和下层网络的参数会绑定在一起,保持一致性。
这个方法同样可以有效地完成面部识别任务。
优化计算:预计算嵌入向量
为了提升计算效率,尤其是在大型数据库中,我们可以采用 预计算嵌入向量 的方法。这意味着,我们可以提前计算好每个员工的嵌入向量,而不是每次进行实时计算。具体步骤如下:
- 当 新员工走进门时,可以通过上层组件计算 新图像的嵌入向量。
- 然后,与 数据库中预计算好的图像嵌入向量 进行比较,来预测 ŷ(是否为同一人)。
这种做法的好处:
- 避免了每次都重新计算 所有员工的图像编码。
- 通过 预计算,显著减少了计算量,特别是在大规模数据库的情况下。
这种 预计算 方法不仅适用于 Siamese 网络架构,也适用于基于 三元组损失 的训练方法。
总结:面部验证与识别的训练方法
要进行 面部验证(Face Verification)的监督学习,你需要:
- 创建一个由 图像对 组成的训练集。
- 对于每对图像,目标标签 y 为:
- 1,如果两张图像来自同一个人;
- 0,如果两张图像来自不同的人。
- 使用 反向传播 训练神经网络,优化模型。
这种将面部验证(及扩展的面部识别)视为 二分类问题 的方法,同样能非常有效地进行训练。
通过这两种方法,你可以训练自己的 面部验证系统 或 面部识别系统,甚至实现 一张图片学习(one-shot learning)功能。