Module 04 · Special Applications: Face recognition & Neural Style Transfer
Triplet Loss三元组损失
在面部识别系统中,为了让神经网络能够为人脸图片生成有效的编码,我们可以定义并应用 三元组损失函数(Triplet Loss),通过 梯度下降 来学习网络参数。接下来,我们将详细了解这一过程。
三元组损失函数:比较图片对
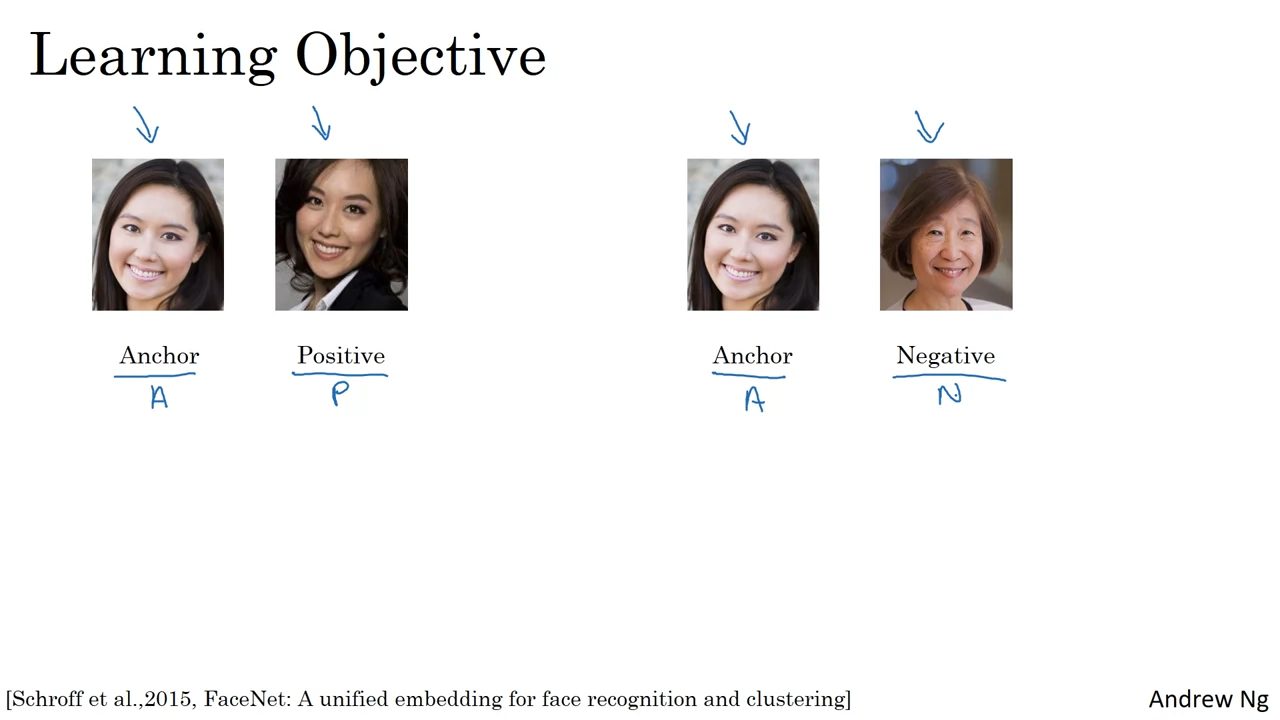
为了应用三元组损失函数,你需要比较一对图片。假设给定以下几种情况:
- 相同人物的两张图片:它们的编码应该非常相似。
- 不同人物的两张图片:它们的编码应该有明显差异。
在三元组损失函数的术语中,我们将始终选择一张 锚点图片(Anchor),并且希望 锚点图片与正样本(Positive,即同一人物的图片)之间的距离较小;而 锚点图片与负样本(Negative,即不同人物的图片)之间的距离应该较大。
锚点(Anchor)、正样本(Positive) 和 负样本(Negative) 通常被简写为 A、P 和 N。
三元组损失函数的公式
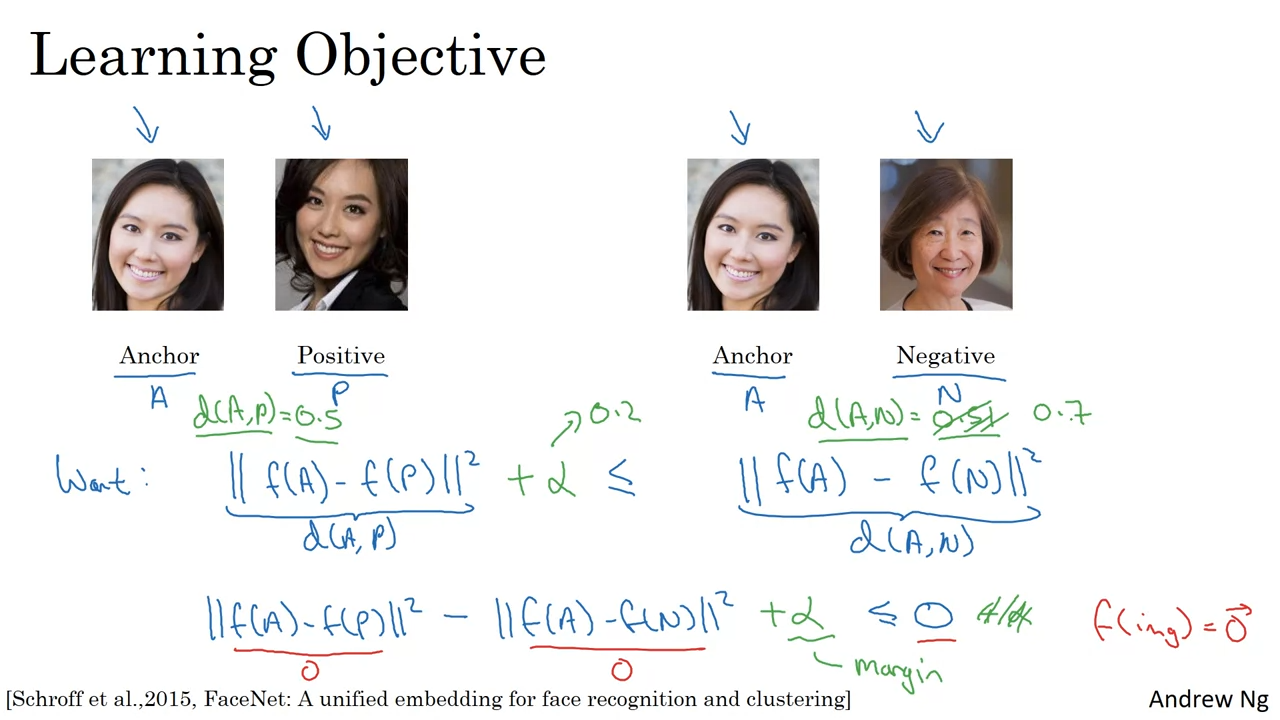
为了使神经网络能够输出良好的编码,我们希望神经网络的参数满足以下条件:
- 锚点图片 A 和正样本 P 的编码差距要小:
- 锚点图片 A 和负样本 N 的编码差距要大:
为了让这个条件成立,通常我们会修改公式,确保锚点与正样本的距离 d(A, P) 小于锚点与负样本的距离 d(A, N),并且在某些情况下,d(A, N) 应该比 d(A, P) 大出一个 margin(间隔),这个间隔通常用 α(一个超参数)来控制。
防止模型输出平凡解
如果我们只是简单地让模型输出 零向量,那么这个目标很容易满足:无论输入什么图片,编码结果都是 0,那么所有的距离都将是 0,这种做法显然不是我们希望的结果。为了防止网络仅仅学习到这种平凡解,我们将目标函数进行修改:
这样,神经网络不会输出零向量,而是会努力让 d(A, P) 和 d(A, N) 之间的差距至少大于一个设定的间隔 α。
计算三元组损失函数
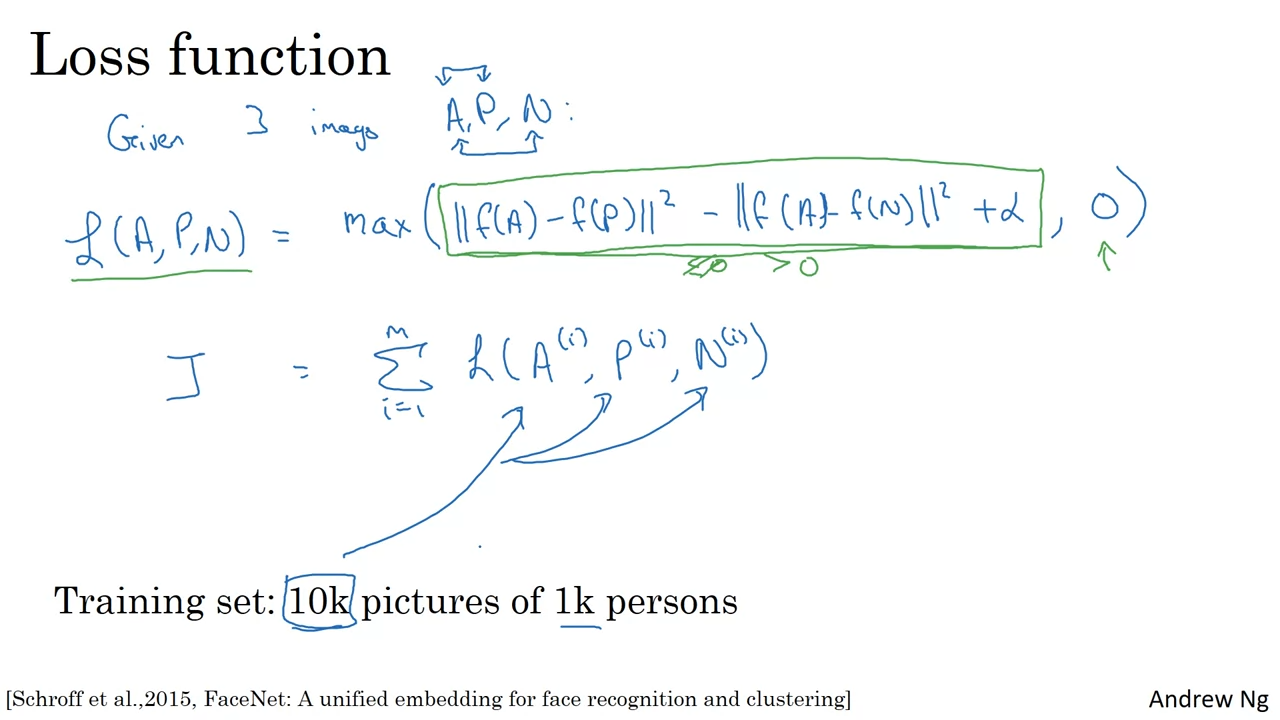
对于每个三元组(A,P,N),我们计算损失函数如下:
- 如果 d(A, P) 和 d(A, N) 的差值大于 α,则损失为 0。
- 如果差值小于 α,损失为 。
这个损失函数的作用是尽可能缩小 d(A, P) 的距离,并尽可能增大 d(A, N) 的距离。
训练神经网络:梯度下降
为了训练神经网络,使得其能够有效地进行面部识别,我们使用 梯度下降 优化这个损失函数,更新网络参数。具体来说:
- 生成一个包含三元组(A、P、N)的数据集。
- 对每个三元组计算损失并将损失最小化。
- 使用 反向传播 更新神经网络的参数,直到损失函数收敛。
数据集与训练集的构建
为了训练这个系统,你需要一个包含多张同一人物的图片的数据集。假设你的训练集包含 10,000 张图片和 1,000 个不同的人,平均每个人有 10 张照片。这样你就能生成大量的三元组数据。
需要注意的是,如果数据集中每个人只有一张图片,那么就无法生成有效的三元组,因为你无法获得 正样本 和 负样本。
选择“困难”的三元组
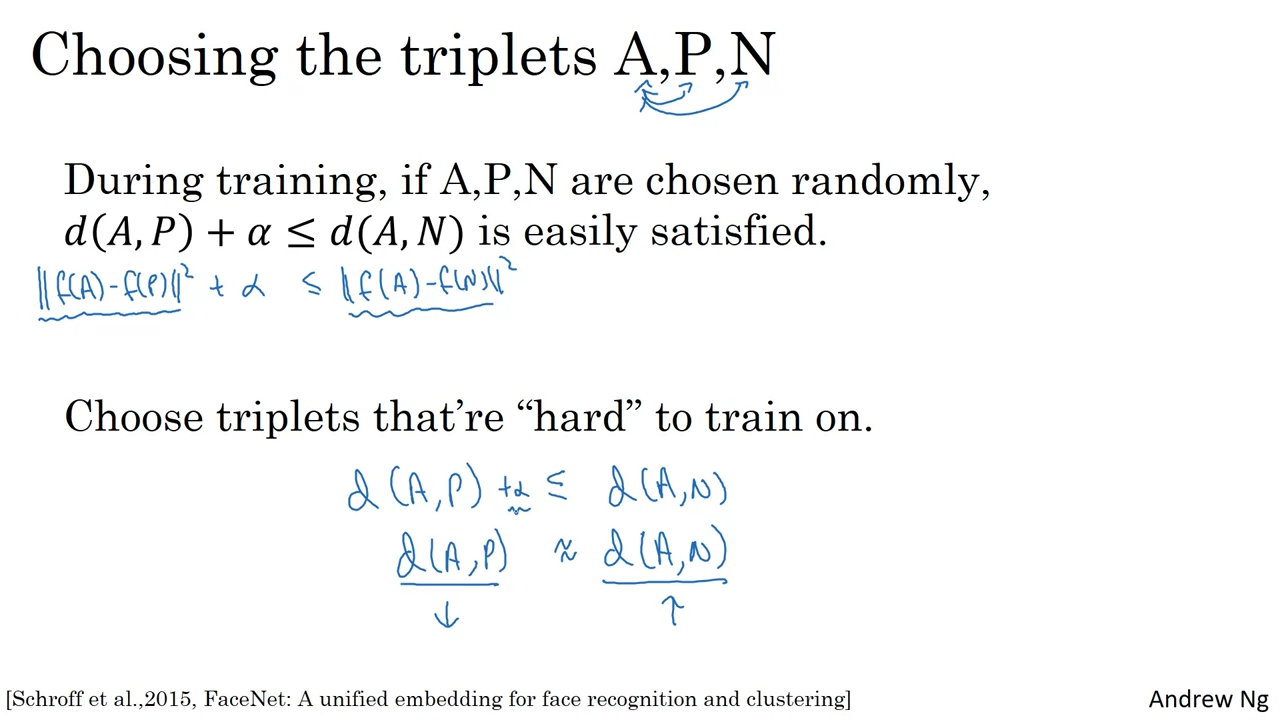
为了提高训练效率,不能随便随机选择三元组。尤其是,当你随机选择 A、P 和 N 时,可能很容易满足 A 和 P 是同一个人的条件,而 A 和 N 是不同人的条件,这样的三元组对训练的意义不大。
因此,我们需要选择那些 “困难” 的三元组,尤其是当 d(A, P) 和 d(A, N) 非常接近时,这样神经网络就必须更加努力地学习,以确保 A 和 P 的距离小于 A 和 N 的距离,并且间隔达到 α。
大规模训练与模型应用
现代的大规模面部识别系统通常是在非常庞大的数据集上训练的,数据集的大小往往超过 百万级,一些公司甚至使用超过 千万级 的图片来训练这些系统。幸运的是,许多公司已经将训练好的 预训练模型 发布在线,因此你可以直接下载并使用,而不必从头开始训练一个模型。
即使你使用了预训练模型,了解这些算法的训练过程仍然非常重要,特别是在你需要自己从头实现类似的系统时。
总结与展望
在本视频中,我们介绍了如何通过 三元组损失函数 来训练神经网络,使其能够有效地进行面部识别。通过对三元组(锚点图片、正样本、负样本)的比较和梯度下降优化,我们能让神经网络输出有区分度的编码。
下一步,我们将讨论 Siamese 网络 的其他变种及其训练方法,敬请期待!