Module 03 · Object Detection
Object Localization目标定位
欢迎回来!本周你将学习目标检测,这也是计算机视觉领域中一个发展迅速且效果越来越好的技术。为了更好地理解目标检测,我们首先会学习目标定位(Object Localization),它是目标检测的基础。让我们先定义一下什么是目标定位。
图像分类与目标定位的关系
你已经熟悉图像分类任务,在这个任务中,算法会查看一张图片,并判断这是一辆车、一个人还是其他物体。例如,如果你在自动驾驶系统中工作,你的任务是从图像中识别并分类对象,例如行人、汽车、摩托车等。
分类与定位的区别
目标定位(Object Localization)是图像分类的扩展,它不仅要求你识别图像中的对象,还要求你标出该对象在图像中的位置。这通常通过画一个**边界框(Bounding Box)**来表示对象的位置。
- 分类:给定一张图片,算法输出该图像属于哪个类别(例如:车、行人、摩托车等)。
- 分类与定位:不仅输出类别,还要在图像中标出物体的位置,通常用一个红色矩形框表示。
因此,分类与定位问题不仅要求识别图像中的对象,还要定位对象的位置。接下来,你将学习目标检测问题,其中图像中可能会有多个对象,我们需要检测并定位所有这些对象。比如在自动驾驶应用中,除了检测汽车,还可能需要检测行人、摩托车,甚至其他障碍物。
图像分类与定位问题的网络结构
标准分类网络
你可能已经熟悉了图像分类问题,通常输入一张图片,通过一个多层的卷积神经网络(CNN),输出一个表示类别的向量。这是我们常见的分类网络。例如,如果你在做自动驾驶的目标分类,可能有如下类别:
- 行人(Pedestrian)
- 汽车(Car)
- 摩托车(Motorcycle)
- 背景(Background)——表示图像中没有目标对象
扩展到分类与定位
如果你希望不仅进行分类,还要定位图像中的目标,可以通过扩展神经网络来输出一个边界框(Bounding Box)。这意味着,你的神经网络不仅要预测类别标签(如车、行人等),还要预测四个数值来表示边界框的位置和大小。
- 四个数值:
- :边界框的x坐标(通常为图像中点的横坐标)
- :边界框的y坐标(通常为图像中点的纵坐标)
- :边界框的高度
- :边界框的宽度
在这个框架中,图像的左上角坐标为 (0, 0),右下角坐标为 (1, 1)。
目标定位的训练标签定义
为了训练模型进行目标定位,我们需要定义合适的标签。假设网络的目标是进行分类与定位,那么目标标签 y 将包含以下内容:
- 是否存在对象:
- 如果图像中存在目标,。
- 如果图像中没有目标(即背景类),。
- 边界框位置:如果图像中有目标对象(),则输出四个值:
- 这些值指定了目标的边界框位置和尺寸。
- 类别:如果图像中存在目标对象,输出该对象的类别:
- :行人
- :汽车
- :摩托车
假设在分类与定位问题中,图像中最多只有一个对象(一个目标)。因此,最多只有一个类别标签是 1,其他类别的标签为 0。
示例:有对象与无对象的训练数据
有对象的情况
假设在训练集中,你有一张图片 x,其中包含一个目标(例如:汽车)。对于这张图片,标签 y 将包含:
- ,因为图像中有目标对象。
- 将指定汽车的边界框位置。
- ,因为这是一个汽车。
无对象的情况
如果图像中没有目标对象(例如,只有背景),则标签 y 将包含:
- ,表示图像中没有目标。
- 其余的部分(边界框和类别标签)都可以忽略或标记为不关心(don’t care)。
在这种情况下,我们不会关心网络输出的边界框或者它认为是什么类别。
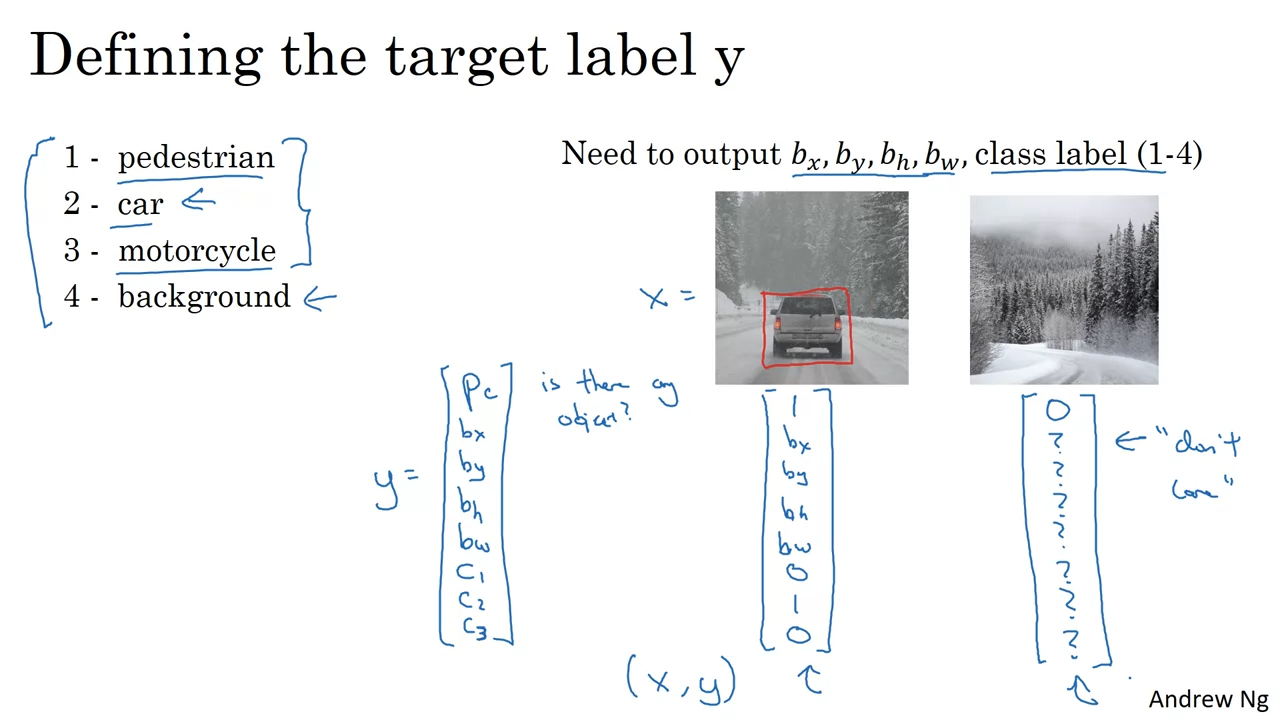
损失函数的定义
在训练网络时,我们需要一个损失函数来评估预测结果与真实标签的差距。假设真实标签为 y,网络的预测为 。
平方误差损失(Squared Error Loss)
- 如果有对象(即 ),损失可以计算为标签与预测之间每个元素的平方差的总和:
其中,y 含有 8 个元素,包含目标是否存在、边界框的四个参数、以及类别的标签。
- 如果没有对象(即 ),则只关心目标检测部分的准确度(即 ),其余部分不关心。此时损失函数简化为:
总结与未来展望
- 分类与定位:通过在神经网络中添加输出节点来实现目标定位,网络不仅要识别目标,还要给出该目标在图像中的位置。
- 训练标签:针对每个目标图像,定义包括目标存在与否、边界框位置和类别标签的训练标签。
- 损失函数:采用平方误差损失函数来衡量网络预测与真实标签之间的差异。
通过这种方式,神经网络不仅能够进行对象分类,还能够进行准确的定位。下一期视频,我们将继续探讨如何将这种技术应用到其他计算机视觉任务中,进一步扩展网络的应用。🎥