Module 03 · Object Detection
Semantic Segmentation with U-Net基于 U-Net 的语义分割
欢迎回来!在这门课程中,您已经了解了 目标识别(Object Recognition),其目标是输入一张图片并判断其中是什么物体,比如这是一只猫还是不是猫。接着,您学习了 目标检测(Object Detection),在此基础上,目标是为检测到的物体画出一个 边界框(Bounding Box)。在本视频中,我们将更进一步,介绍一种更加精细的算法 —— 语义分割(Semantic Segmentation)。它的目标是为检测到的物体绘制精确的轮廓,从而准确地标注出每个像素是否属于物体。这种算法在很多实际的商业应用中非常有用。
什么是语义分割?
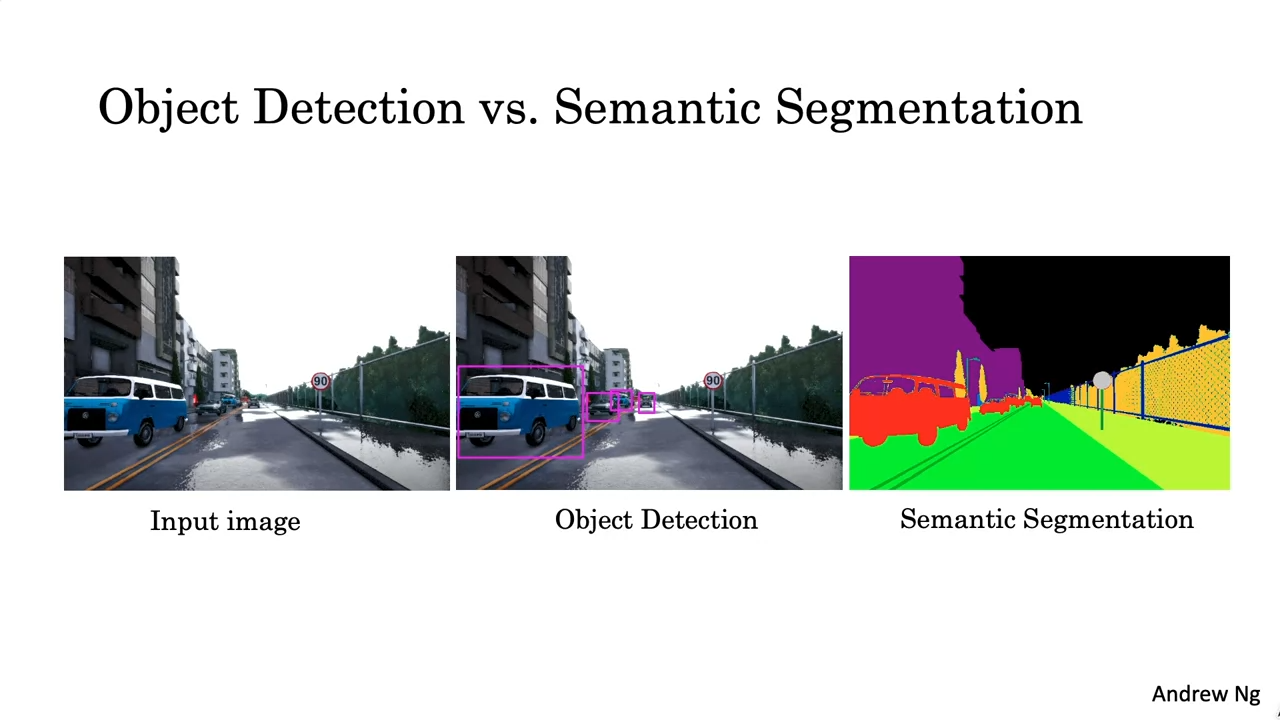
假设你正在开发 自动驾驶汽车,并且获得了如图所示的输入图像,目标是检测其他车辆的位置。如果使用目标检测算法,可能只会在其他车辆周围绘制像这样的 边界框(Bounding Boxes)。对于自动驾驶系统来说,这或许足够了,但如果你希望算法能判断出图像中每一个像素的类别,那么你需要使用语义分割算法,其目标是生成这样的输出图像:
- 例如,语义分割算法不只是检测道路并画出边界框,而是对图像中的每个像素进行标记,判断该像素是否属于 可驾驶道路(Drivable Roads),用深绿色表示。
自动驾驶中的应用
语义分割的一个重要应用是在自动驾驶中,帮助算法识别哪些像素表示的是 可驾驶的表面,因此,哪些地方是安全的可以行驶。
医学图像中的语义分割
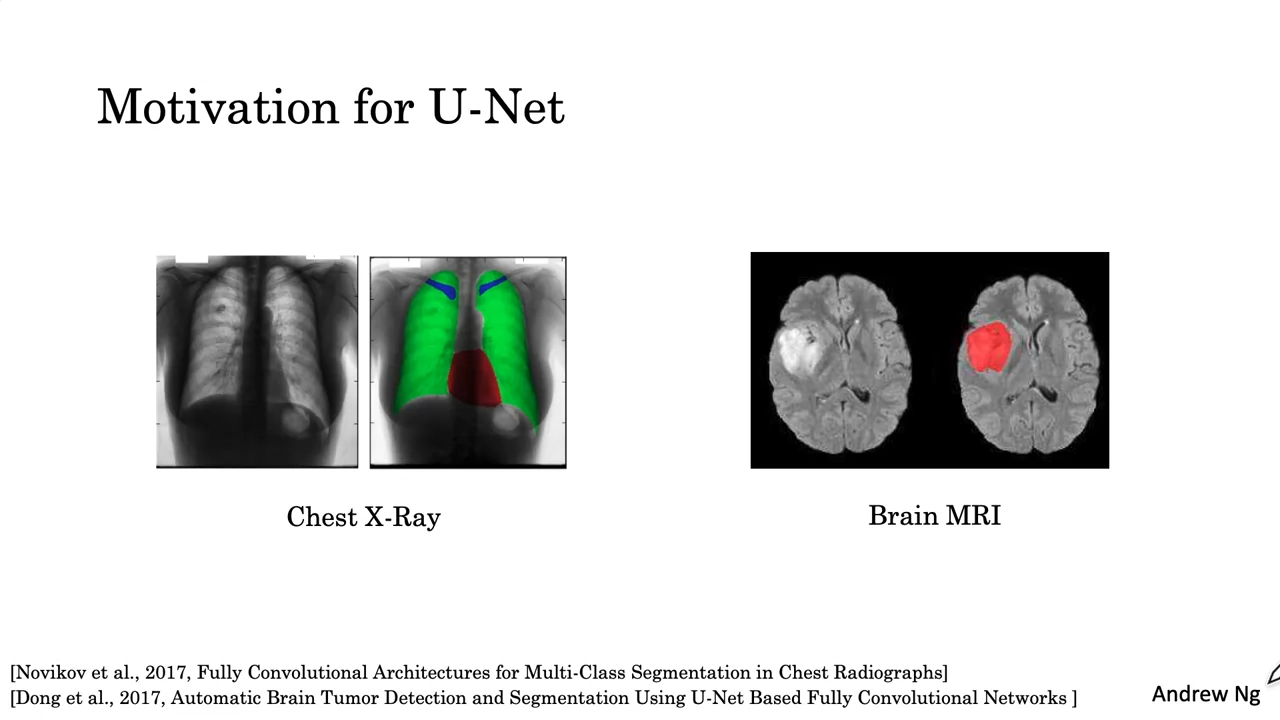
语义分割在医学影像学中的应用也非常广泛。比如,给定一张 胸部X光片,你可能想要诊断某人是否患有某种疾病,但对于医生来说,更有帮助的是,能够在图像中精确地分割出患者的 解剖结构,例如:肺部、心脏、锁骨等。
- 左侧图像中,肺部、心脏和锁骨使用不同颜色进行了分割。
- 这种分割可以帮助医生更容易地发现异常,诊断严重疾病,也有助于外科医生进行 手术规划。
此外,在脑部肿瘤检测中,利用 MRI扫描 对肿瘤进行分割可以节省放射科医生大量的时间,并且为手术规划提供有用的信息。生成这些结果的算法是一个叫做 U-Net 的算法,稍后你将在本视频中深入了解。
语义分割的实现:分割汽车与背景
为了简化起见,我们先用一个简单的例子来说明语义分割的工作原理:从背景中分割出一辆汽车。假设目前你只关心分割图像中的汽车部分,方法如下:
- 你可以为 汽车 分配一个标签为 1,而 非汽车 部分分配一个标签为 0。
- 语义分割算法的任务是,输出每个像素的标签。如果该像素属于汽车部分,标签为 1;否则,标签为 0。
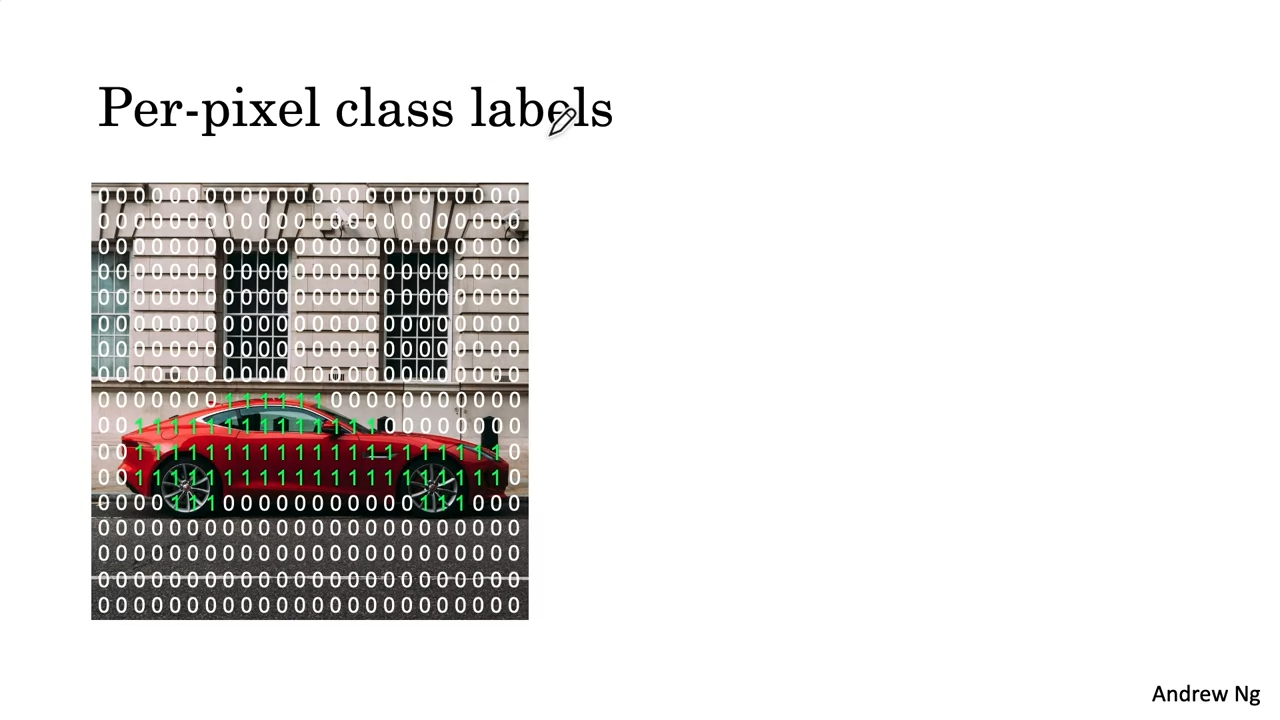
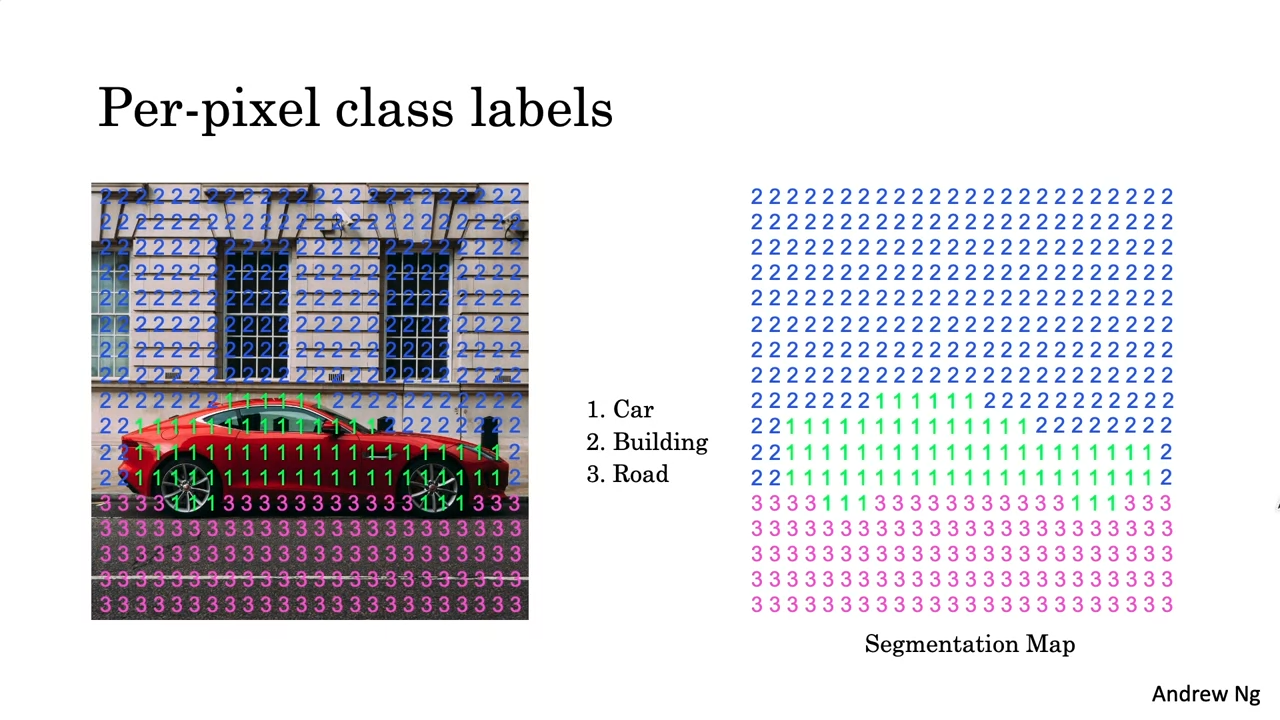
如果你希望进行更精细的分割,你可以引入更多类别。例如,你可能还想知道 建筑物 的位置,那么你可以添加一个标签 2 代表建筑物,最终形成如下的标签输出:
- 汽车 → 标签 1
- 建筑物 → 标签 2
- 道路或地面 → 标签 3
神经网络架构:从目标识别到语义分割
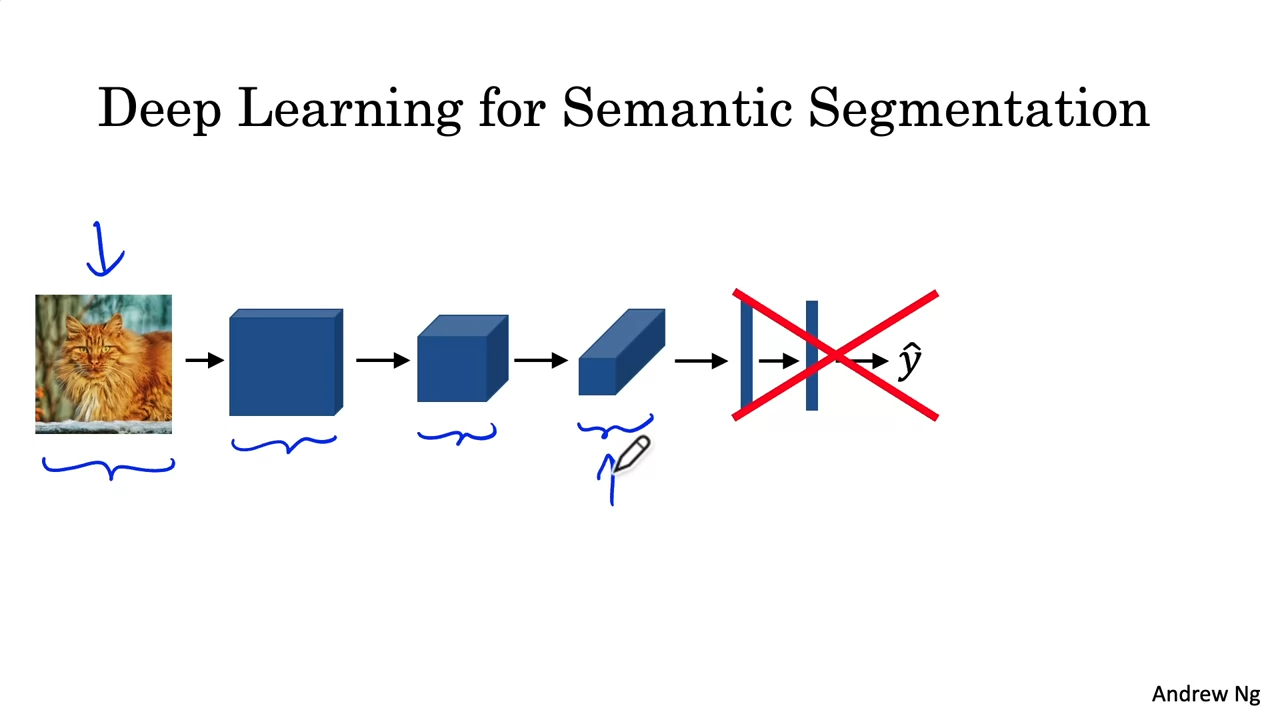
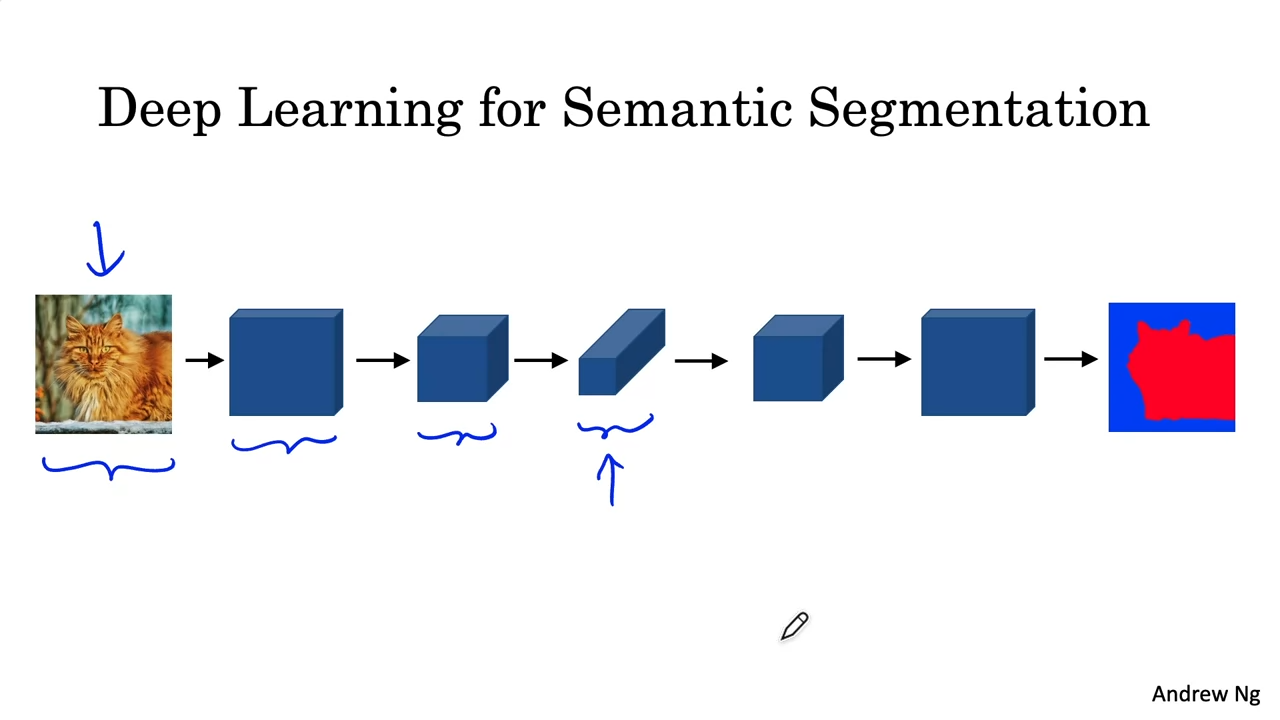
要实现语义分割,我们需要对已有的 目标识别神经网络架构 进行修改,使其能够输出一个包含所有类标签的矩阵,而不仅仅是一个类标签。
卷积神经网络(CNN)架构调整
- 输入图像 会通过多个卷积层传递,最终产生一个类标签(ŷ)。
- 为了将其转变为语义分割架构,我们需要 去掉最后几层,并进行重要的调整:
- 由于图像的尺寸在神经网络的层级中逐渐变小,现在需要让图像尺寸变大,这样最终能够恢复到目标输出的 全尺寸图像。
U-Net架构
U-Net 是一个经典的语义分割架构,具体来说:
- 在网络的深层,图像的 高度 和 宽度 会逐渐增大,而 通道数 会逐步减少。
- 最终,网络输出一个 分割图,该图标识了图像中每个像素的类别。
转置卷积(Transpose Convolution)
一个关键的操作是 转置卷积(Transpose Convolution),它能够将图像的激活值从较小的尺寸 “放大” 成更大的尺寸,这是语义分割中不可缺少的步骤。
转置卷积在 U-Net架构 中使用多次,帮助恢复图像的原始尺寸,从而生成高质量的分割图。
总结:语义分割的重要性与应用
语义分割是一种 非常有用的算法,广泛应用于 计算机视觉 各个领域,其关键思想是对每个像素进行 单独分类,确保每个像素都能够被精确地标注为对应的类别。为了实现这一目标,我们需要通过 转置卷积 等技术将图像的特征从小尺寸扩展到大尺寸,从而获得 全尺寸的分割图。
下一步:转置卷积
在下一个视频中,你将学习如何实现 转置卷积,了解它如何帮助网络恢复图像的尺寸。我们在下一个视频中见!