Module 04 · Emergent Trends and Practices新兴趋势与实践
Serverless Computing无服务器计算
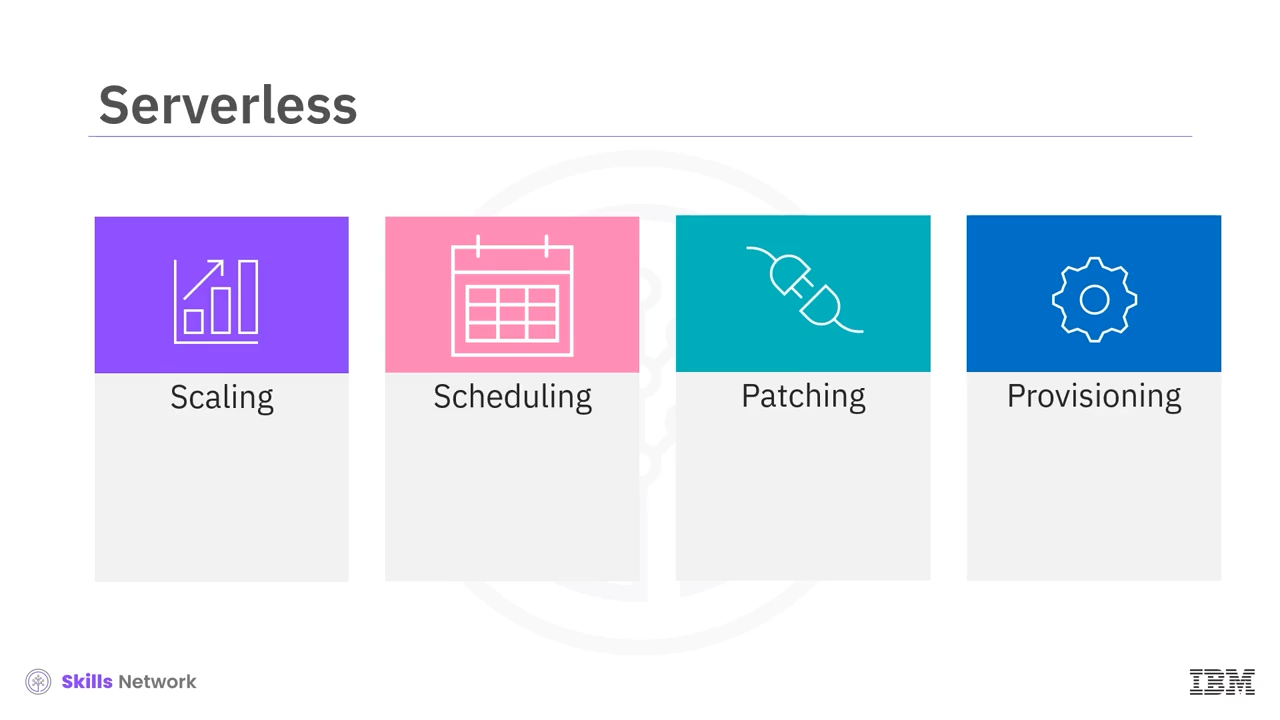
无服务器计算(Serverless)是一种将传统基础设施管理任务(如扩展、调度、修补和配置应用堆栈)卸载到云服务提供商的计算方法,使开发者能够专注于应用程序的代码和业务逻辑。无服务器并不意味着没有服务器,而是指开发者不再负责管理底层的物理或虚拟服务器。
无服务器计算的关键特点
无服务器计算环境根据需求为应用程序分配资源,按需运行代码。以下是一些区分无服务器计算与其他计算模型的关键特征:
| 特性 | 描述 |
|---|---|
| 无需服务器配置 | 开发者无需配置服务器、安装应用堆栈或操作基础设施。 |
| 按需运行代码 | 无服务器计算按请求运行代码,随着请求量的增加,自动扩展。 |
| 仅为使用的资源付费 | 用户只为实际使用的资源付费,而不是像虚拟服务器那样为运行的虚拟机付费,即使虚拟机空闲。 |
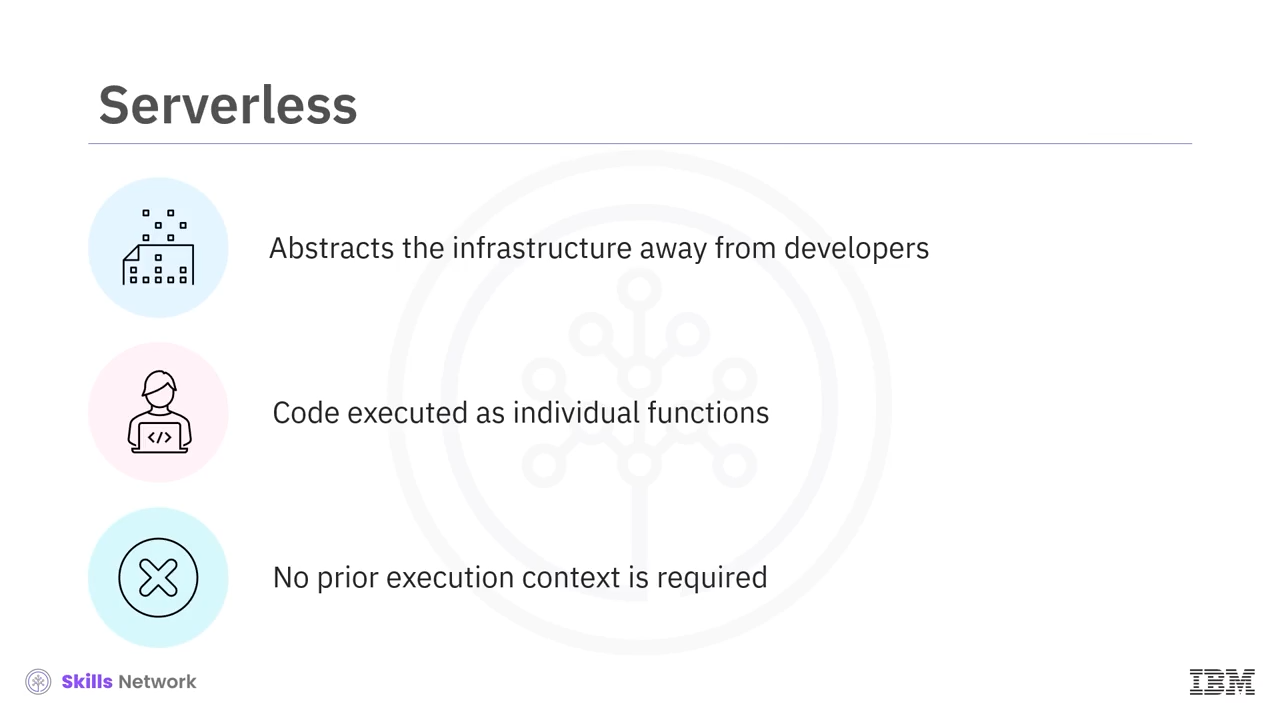
| 抽象化基础设施 | 基础设施对开发者进行了抽象,每个功能都在无状态的容器内执行。 |
| 无执行上下文 | 不需要先前的执行上下文来服务请求,每次新请求时都会调用新的函数实例。 |
无服务器计算的实际应用场景
案例:翻译文本文件
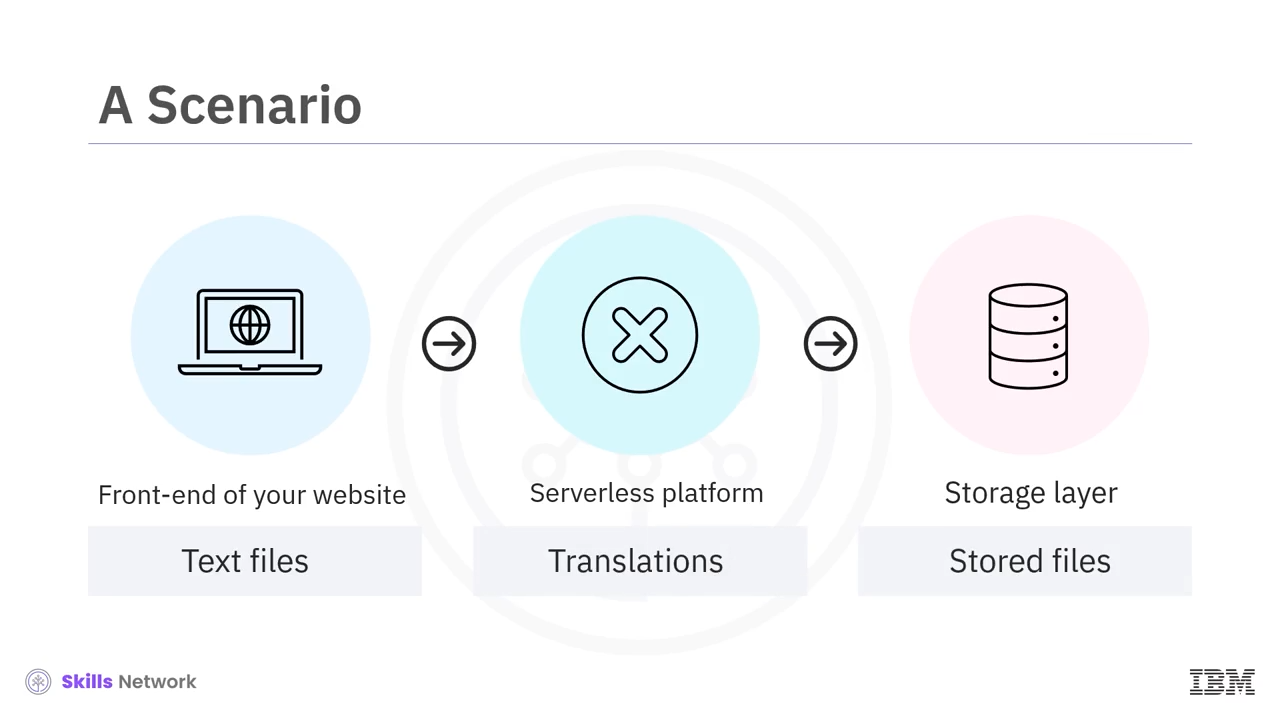
在无服务器平台的支持下,您可以在网站前端与存储层之间运行独立的功能。例如,假设您有一个无服务器应用程序,负责翻译文本文件并将翻译后的文件存储在云端存储服务中。
- 工作流程:用户通过网站前端上传文本文件,无服务器应用程序 将这些文件翻译成不同的语言,并将翻译后的文件存储在云存储中。之后,系统返回文件的下载链接。
关键服务
目前,一些主要的无服务器计算服务包括:
- IBM Cloud Functions:基于 Apache OpenWhisk。
- AWS Lambda:亚马逊提供的无服务器计算服务。
- Microsoft Azure Functions:微软提供的无服务器计算平台。
无服务器计算的适用性与挑战
适用场景
无服务器架构并非适用于所有应用或场景。以下是一些适合使用无服务器架构的应用特点:
- 短期运行的无状态函数:通常运行几秒钟到几分钟。
- 季节性工作负载:具有不同时期的低峰和高峰负载。
- 大量空闲时间的生产性数据:如果应用程序中存在大量空闲时间,使用无服务器可以更节省成本。
- 事件驱动或异步请求处理:适合处理基于事件的任务。
- 微服务:可以作为无状态函数构建的微服务。
应用领域
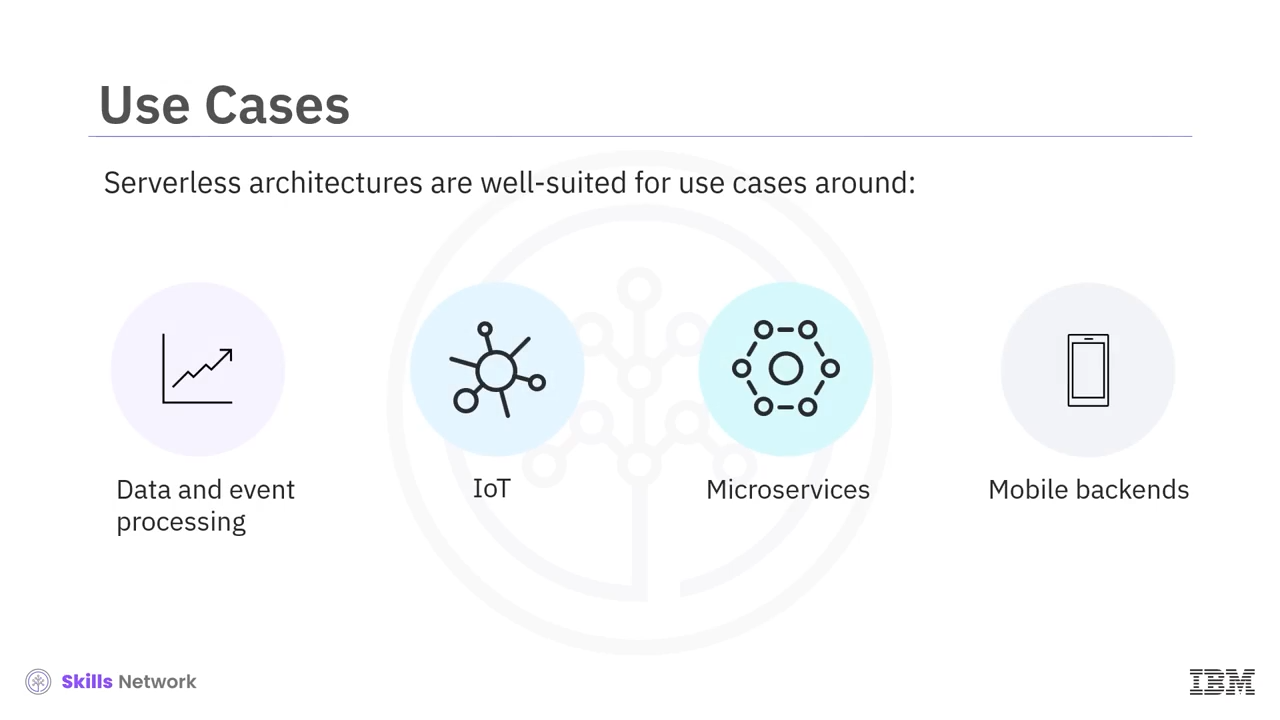
无服务器架构特别适用于以下场景:
- 数据和事件处理:数据清洗、转换、验证等任务。
- 物联网(IoT):适用于传感器数据流处理。
- 微服务架构:与微服务架构结合,处理高并发请求。
- 移动后端:为移动应用提供后端支持。
数据处理任务
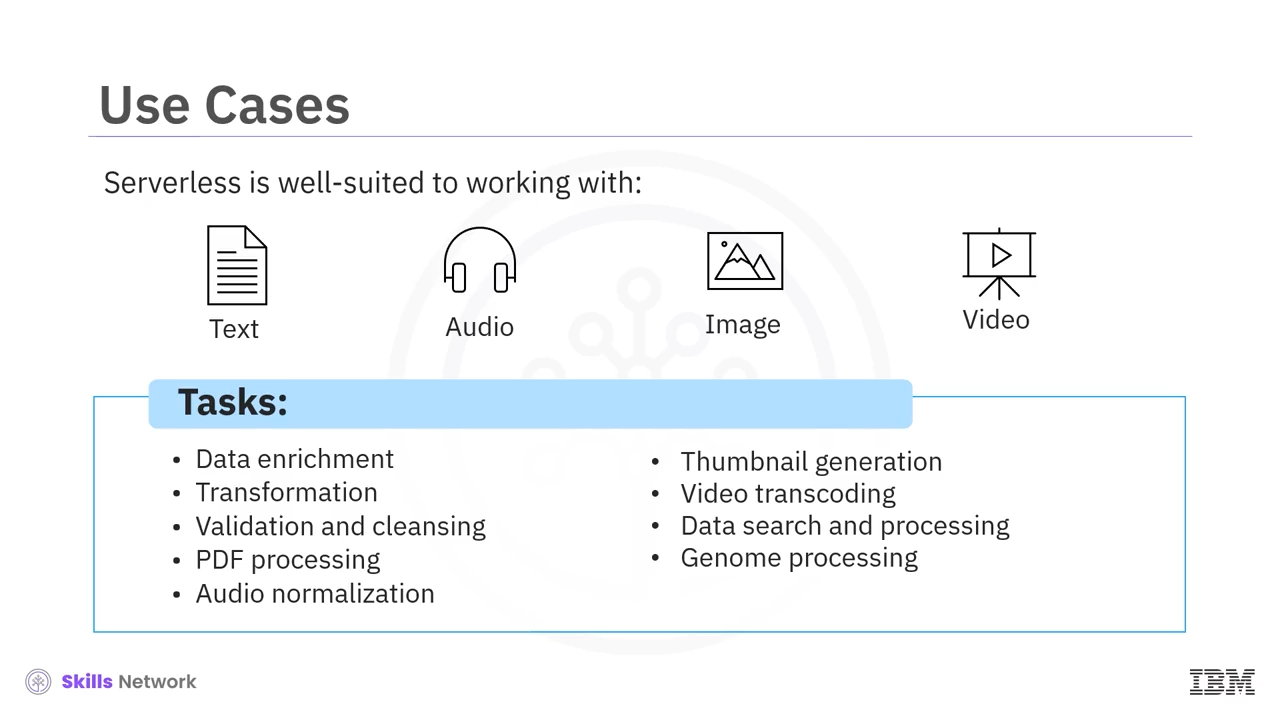
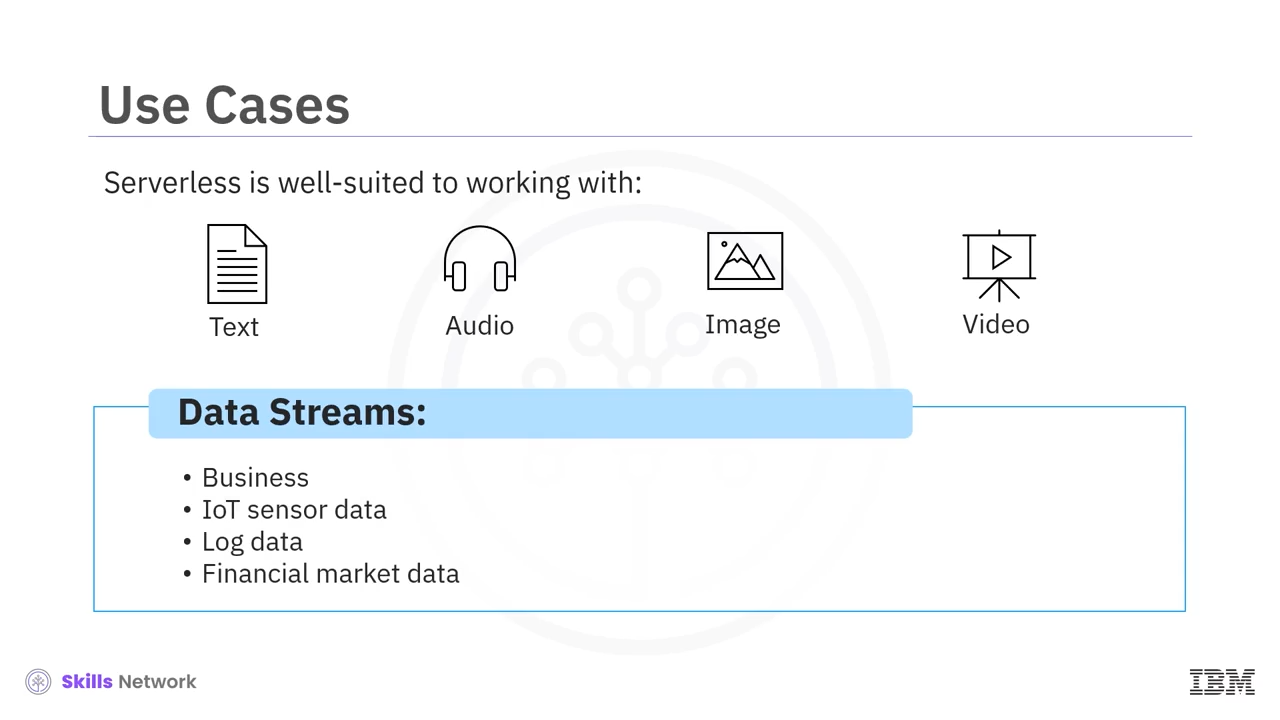
- 结构化数据处理:文本、音频、图像和视频数据的处理,如数据清洗、格式转换、音频标准化、视频转码等。
- 并行任务:数据搜索与处理、基因组数据处理等任务非常适合在无服务器环境下运行。
流数据处理
无服务器计算还适用于各种类型的数据流摄取任务,包括:
- 商业数据流
- 物联网传感器数据
- 日志数据
- 金融市场数据
无服务器计算面临的挑战
1. 适应长期运行任务的挑战
无服务器工作负载会根据工作量自动扩展或缩减,但对于长期运行的任务,传统的服务器环境可能更加简单且成本更低。
2. 供应商依赖性与锁定
无服务器架构通常依赖于特定的云供应商平台,因此存在供应商锁定的风险,特别是在涉及平台功能(如身份验证、扩展、监控或配置管理等)时。
3. 启动延迟问题
由于无服务器架构按需启动和停止,有时需要从零开始启动才能处理新请求。这对某些应用(例如低延迟的金融应用)可能会造成不可接受的延迟。
总结
无服务器计算(Serverless) 是一种创新的计算方法,能够将传统的基础设施管理责任从开发者身上转移,让他们将精力集中在应用的核心功能和业务逻辑上。
无服务器计算的优势:
- 按需资源分配:用户仅为实际使用的资源付费,不必为空闲资源支付费用。
- 自动扩展:根据需求自动调整资源,适应高并发和高峰期负载。
- 简化开发:开发者可以专注于编写核心代码,无需关心基础设施和扩展问题。
适用场景:
无服务器计算适合短期运行的无状态函数、季节性工作负载、微服务架构以及数据处理等任务,尤其是在 数据处理、物联网 和 流数据处理 中表现出色。
然而,对于长时间运行的任务或低延迟需求的应用,传统服务器环境可能更加适合。
无服务器计算是现代云计算的一种重要发展趋势,能够大大提高应用的灵活性和开发效率。