Module 04 · Accessing Databases using Python
Analyzing data with Python使用 Python 进行数据分析
欢迎观看本视频,了解如何使用 Python 进行数据分析。
观看本视频后,您将能够:
- 使用 Pandas 执行探索性数据分析 (EDA)。
- 利用 Python 搭配 SQLite 3 进行数据存储和检索。
- 使用 Seaborn 进行数据可视化,以发现洞察和模式。
数据集介绍:麦当劳菜单营养成分
在本视频中,我们将使用关于麦当劳热门菜单项目的营养成分数据,并利用 Python 进行基本的探索性分析。
📌 麦当劳简介
麦当劳是一家美国快餐公司,也是全球收入最高的连锁餐厅。
尽管麦当劳以汉堡包、薯条、软饮料、奶昔和甜点等快餐食品闻名,但该公司也在菜单中添加了沙拉、鱼、冰沙和水果等。
麦当劳提供其菜单项目的营养分析,以帮助消费者平衡在麦当劳的用餐与其他食物的摄入。
本课程中使用的数据集来源于 Kaggle 上的麦当劳菜单营养成分数据。
数据库的创建与数据导入
我们需要在 SQL 服务器上创建一个数据库表,用于存储将使用的麦当劳菜单营养成分数据集。
1. 使用SQLite 3
我们可以使用 SQLite 3,它是一个进程内(in-process)的 Python 库,实现了自包含、无服务器、零配置的事务性 SQL 数据库引擎。
2. 数据导入步骤
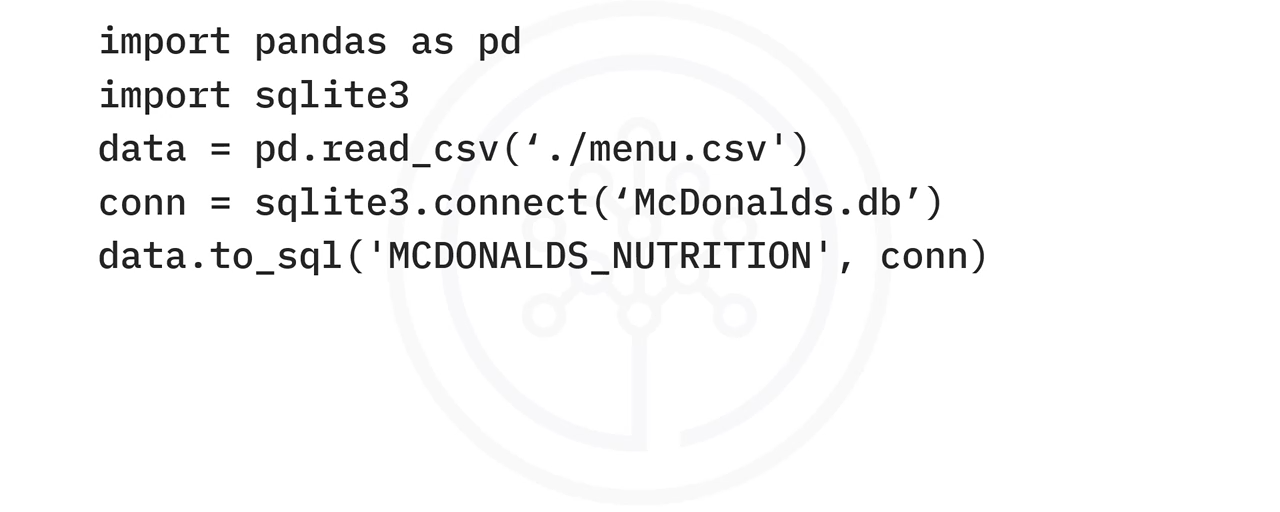
- 使用
pandas.read_csv函数将数据库 CSV 文件读取到一个变量(例如data)。 - 使用
SQLite3.connect函数建立与数据库mcdonalds.db的连接,并将连接对象保存到一个变量(例如conn)。 - 利用 Pandas 变量
data的to_sql属性方法,将data变量的内容作为一个表加载到mcdonalds.db数据库中。
💡 示例:CSV 文件中的内容现在可以作为表
mcdonalds_nutrition,可根据需要进行查询。
使用 Pandas 检索数据与探索性分析
现在,我们来看看如何使用 Pandas 从数据库表中检索数据。
1. 数据检索
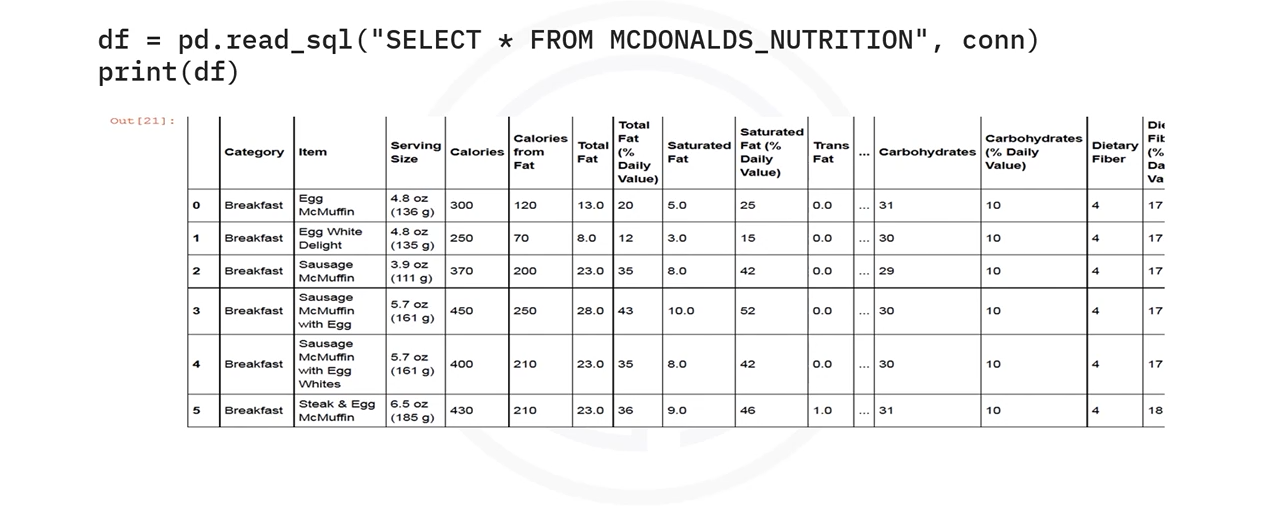
- 通过
read_sql方法,我们将数据从mcdonalds_nutrition表加载到数据框df中。 - 将 SQL SELECT 查询和连接对象作为参数传递给
read_sql方法。 - 我们可以使用
.head()方法查看创建的数据框df的前几行。
2. 数据概览与描述性统计
是时候了解您的数据了! Pandas 方法配备了一套常见的数学和统计方法。
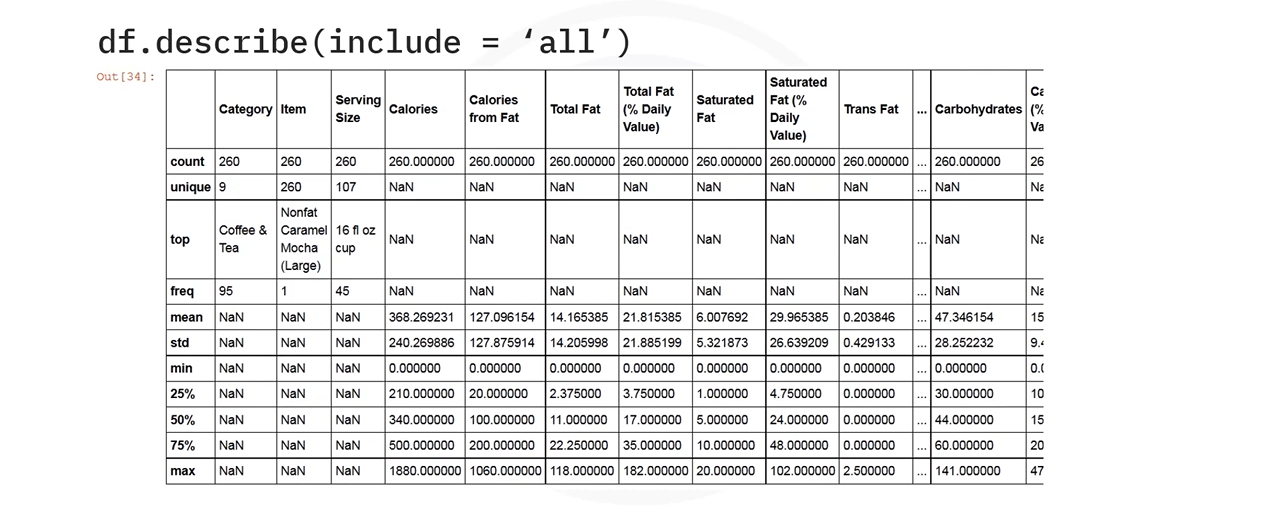
- 使用
.describe()方法查看数据框的摘要统计信息。 - 探索
.describe()的输出结果:- 数据框中有 260 个观察值(或食物项目)。
- 食物项目有 9 个独特的类别。
- 可以看到包括频率 (frequency)、平均值 (mean)、中位数 (median)、标准差 (standard deviation) 等统计信息。
- 例如,总脂肪 (Total Fat) 的最大值为 118。
案例分析:最大钠含量食物项目
让我们进一步调查这些数据,尝试理解食物项目中的一种营养素:钠 (Sodium)。
1. 钠的重要性与健康建议
| 描述 | 详情 |
|---|---|
| 主要来源 | 食盐。 |
| 日常摄入 | 普通美国人每天摄入 5 茶匙或更多的盐,约为身体所需量的 20 倍。 |
| 存在形式 | 天然存在于食物中,但在加工和准备过程中会添加大量。许多尝起来不咸的食物可能钠含量仍然很高。 |
| 生理功能 | 控制体内液体平衡,维持血容量和血压。 |
| 健康风险 | 摄入过多可能升高血压并导致液体潴留,可能导致腿脚肿胀或其他健康问题。 |
| 膳食目标 | 限制钠摄入量的常见目标是每天摄入少于 2000 毫克的钠。 |
2. 数据分析:哪个食物项目的钠含量最高?
现在,利用麦当劳的营养数据集,进行一些基本的数据分析来回答这个问题。
阶段一:可视化探索(Swarm Plot)
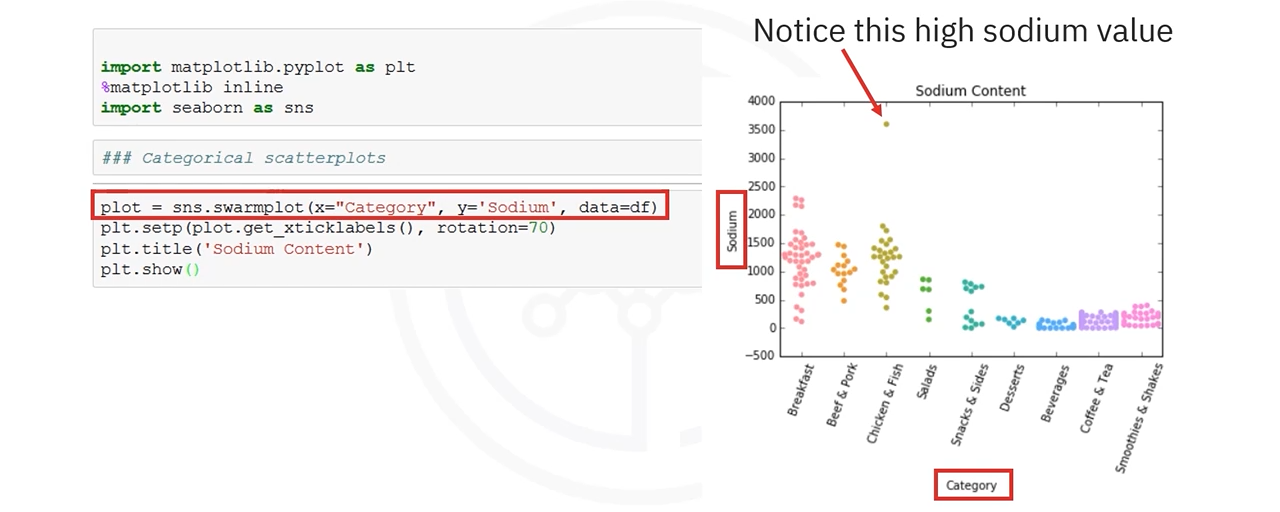
- 使用 Seaborn 包提供的
swarmplot方法创建分类散点图。 - 输入参数:x 轴为类别 (Category),y 轴为钠 (Sodium),数据源为数据框
df。 - 图表显示了不同类别食物项目的钠含量值。
- 注意:散点图上有一个约为 3600 的高钠值。
阶段二:使用代码找出最大值
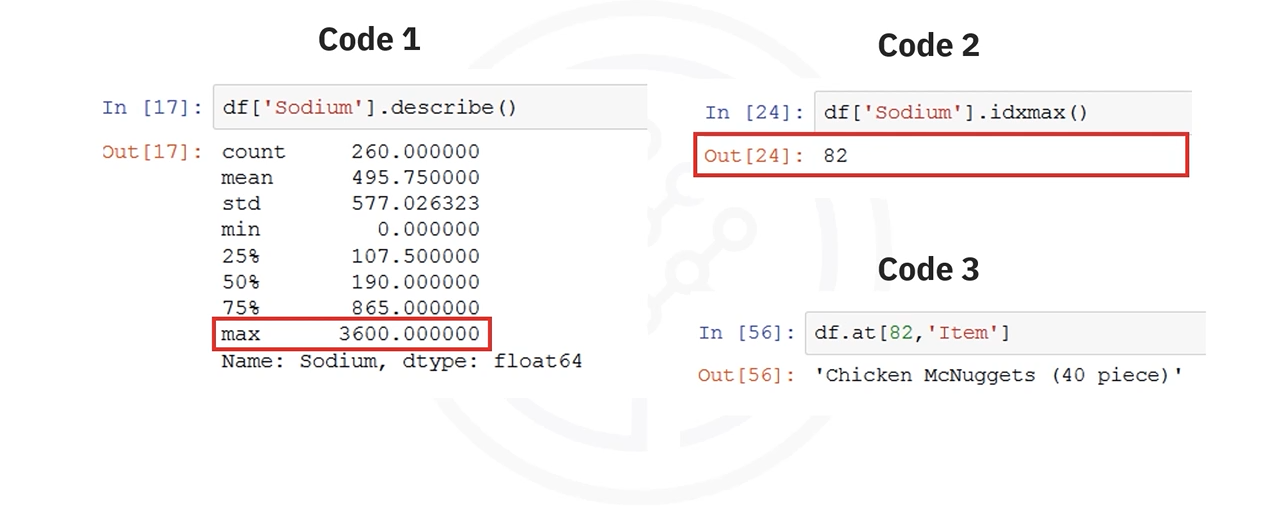
代码 1:查看钠的摘要统计信息
使用 .describe() 方法来理解与钠 (Sodium) 相关的摘要统计信息。
🔎 观察结果:钠的最大值显示为 3600。
代码 2:查找最大钠含量值的索引
使用 idxmax 方法计算数据框中钠达到最大值时的索引值。
➡️ 输出结果:82。
代码 3:找出对应食物名称
使用 .at 方法,通过传递索引 82 和列名 Item,找到第 82 行对应的项目名称。
🏆 最终结果:菜单上钠含量最高的食物项目是:Chicken McNuggets (40 piece)(40 块麦乐鸡)。
数据可视化:模式、关系与异常值
可视化对于初始数据探索非常有用。它们可以帮助我们理解数据中的关系、模式和异常值 (outliers)。
1. 散点图 (Scatter Plot)
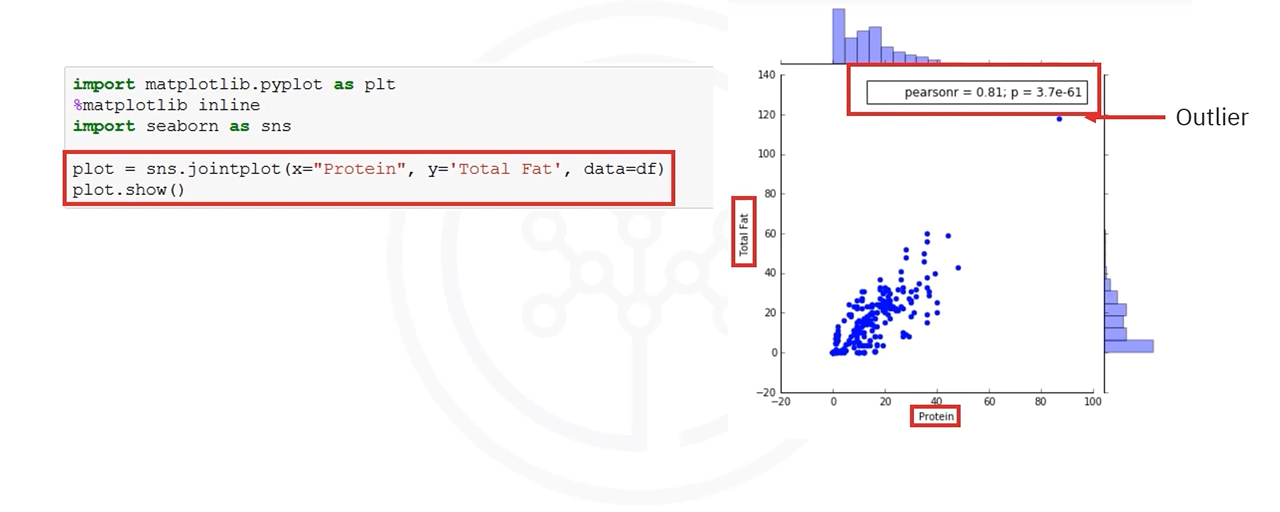
目的:探索蛋白质和总脂肪之间的关系。
- 工具:使用 Seaborn 包提供的
jointplot函数。 - 输入:x 轴为蛋白质 (Protein),y 轴为总脂肪 (Total Fat)。
- 图表分析:
- 图表显示了两个变量之间的相关性。相关性是衡量两个变量关联程度的指标,其值在 和 之间。
- 散点图上的点更接近正向的直线,表明两个变量之间存在正相关。
- 图表右上角显示 Pearson 相关系数为 0.81,表明变量确实高度相关。
- 图表还显示了蛋白质和总脂肪的两个直方图。
- 异常值:图表上有一个点偏离了一般模式,可能是一个异常值。
2. 箱线图 (Box Plot)
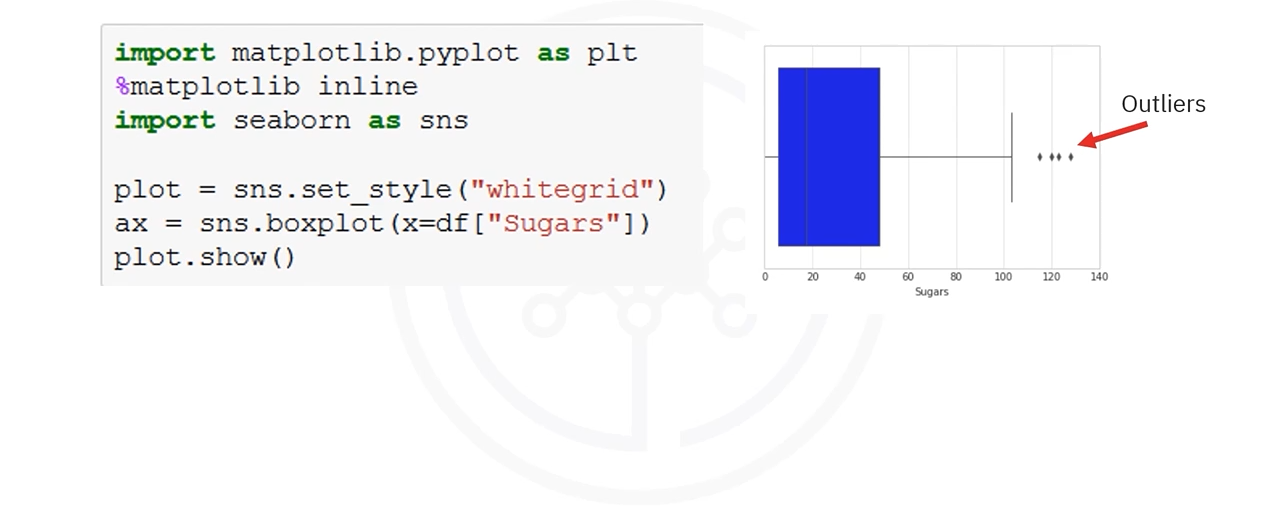
目的:可视化糖分的分布情况。
- 概念:箱线图显示一个或多个变量的分布。箱子捕获了数据的中间 50%,线条和点表示可能的偏斜和异常值。
- 工具:使用 Seaborn 包的
boxplot函数。 - 输入:列名
Sugars。 - 图表分析:
- 箱线图显示食物项目中的糖分平均值约为 30 克。
- 异常值:也观察到一些异常值,表明食物项目的糖分含量极高,例如某些食物的糖分含量约为 128 克。菜单上的糖果类产品可能属于这些高糖分食物项目。
总结回顾
- SQLite 3 是一个进程内 Python 库,实现了自包含、无服务器、零配置的事务性 SQL 数据库引擎。
pandas.read_csv函数用于读取 CSV 文件。SQLite3.connect函数用于连接到数据库。- 使用 Pandas 的
read_sql方法和 SQL SELECT 查询,可以从数据库表中检索数据。 - 使用 Seaborn 包的
swarmplot方法可以创建分类散点图。