Module 01 · Overview of Data Science Tools
Open Source Tools for Data Science - Part 2数据科学开源工具(第二部分)
欢迎观看《开源数据科学工具 第二部分》。观看本视频后,您将能够:
- 比较和对比 不同的开源工具。
- 描述 开源工具的相关特性。
交互式开发环境
目前,数据科学家们使用的最著名的开发环境是 Jupyter。
Jupyter Notebooks
- 起源与支持: Jupyter 最初是作为交互式 Python 编程的工具出现的。
- 现在,Jupyter 通过 “内核” (kernels) 支持一百多种不同的编程语言。
- 内核封装了不同编程语言的执行环境。
- 核心特性: Jupyter Notebooks 的一个关键特性是能够将以下内容统一在一个单一文档中:
- 文档 (Documentation)
- 代码 (Code)
- 代码输出 (Output from the code)
- Shell 命令 (Shell commands)
- 可视化 (Visualizations)
Jupyter Lab
- 定位: Jupyter Lab 是 Jupyter Notebooks 的下一代版本,从长远来看将取代 Jupyter Notebooks。
- 架构优势: 架构上的大量变化使其更现代化和模块化。
- 用户差异: 从用户的角度来看,Jupyter Lab 与 Jupyter Notebooks 的主要区别在于其打开不同类型文件的能力,包括:
- Jupyter Notebooks
- 数据文件
- 终端
- 并将它们排列在画布上。
Apache Zeppelin
- 灵感与体验: 尽管是从零开始重新实现的,但 Apache Zeppelin 的灵感来源于 Jupyter Notebooks,并提供了相似的体验。
- 关键区别: 一个关键的区别在于其集成的绘图能力 (integrated plotting capability)。
- 在 Jupyter Notebooks 中,您需要使用外部库进行绘图。
- 在 Zeppelin 中,绘图不需要编写代码。
- 扩展性: 您还可以使用额外的库来扩展其功能。
RStudio
- 历史与定位: RStudio 是最古老的统计学和数据科学开发环境之一,起源于 2011 年。
- 语言支持:
- 它专有运行 R 及其所有关联的 R 库。
- 在 R 环境中,Python 开发是可能的。
- R 紧密集成到 Jupyter 工具中,并提供了最佳的用户体验。
- 统一功能: RStudio 将以下功能统一在一个工具中:
- 编程 (Programming)
- 执行 (Execution)
- 调试 (Debugging)
- 远程数据访问 (Remote data access)
- 数据探索 (Data exploration)
- 可视化 (Visualization)
Spyder
- 目标: Spyder 试图模仿 RStudio 的行为,将其功能带到 Python 世界。
- 现状: 尽管其功能尚未完全达到 RStudio 的水平,但数据科学家们仍将其视为一个替代选项。在 Python 世界中,Jupyter 的使用更为普遍。
- 集成特点: Spyder 将代码、文档和可视化等集成到单一画布中。
集群执行环境
有时您的数据不适合单个计算机的存储或主内存容量,因此存在集群执行环境。
Apache Spark
- 普及度: Apache Spark 是最著名的 Apache 项目之一,它在所有行业中都有应用,包括许多财富 500 强公司。
- 核心特性: Apache Spark 的关键特性是线性可扩展性 (linear scalability)。
- 这意味着如果您将集群中的服务器数量增加一倍,其性能也将大致增加一倍。
- 数据处理范式: Apache Spark 是一个批处理数据处理引擎 (batch data processing engine),能够逐个或逐文件地处理海量数据。
Apache Flink
- 发展: Apache Flink 是在 Apache Spark 持续占据市场份额后开发的。
- 关键区别:
- Apache Flink 是一个流处理引擎 (stream-processing engine)。
- 其主要关注点是处理实时数据流。
- 选择偏好: 尽管这两个引擎都同时支持这两种数据处理范式,但在大多数用例中,Apache Spark 仍然是首选。
Ray
- 最新发展: Ray 是继 Apache Spark 和 Apache Flink 之后,数据科学执行环境中的最新发展之一。
- 关注点: 它明确专注于大规模深度学习模型训练。
完全集成且可视化的工具
这些开源工具是完全集成且可视化的,这意味着不需要编程知识。
- 支持任务: 这些工具支持重要任务的一个子集,包括:
- 数据集成和转换 (Data integration and transformation)
- 数据可视化 (Data visualization)
- 模型构建 (Model building)
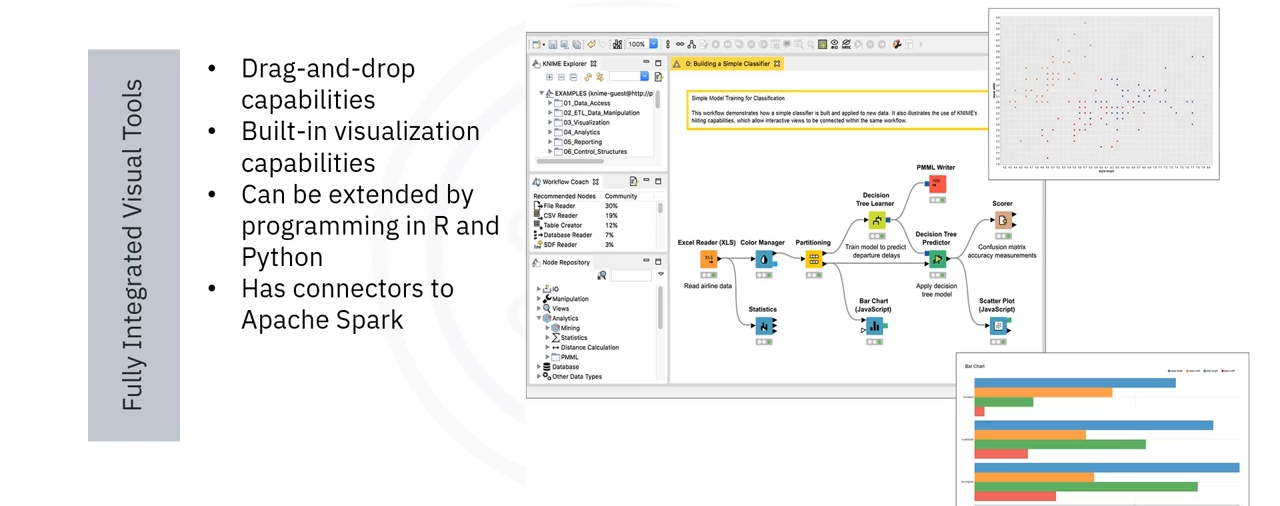
KNIME
- 起源: KNIME 起源于 2004 年的康斯坦茨大学 (University of Konstanz)。
- 用户界面: KNIME 具有可视化用户界面,支持拖放功能。
- 核心功能:
- 它具有内置的可视化能力。
- 此外,它可以通过 R 和 Python 编程进行扩展。
- 它甚至具有与 Apache Spark 的连接器。
Orange
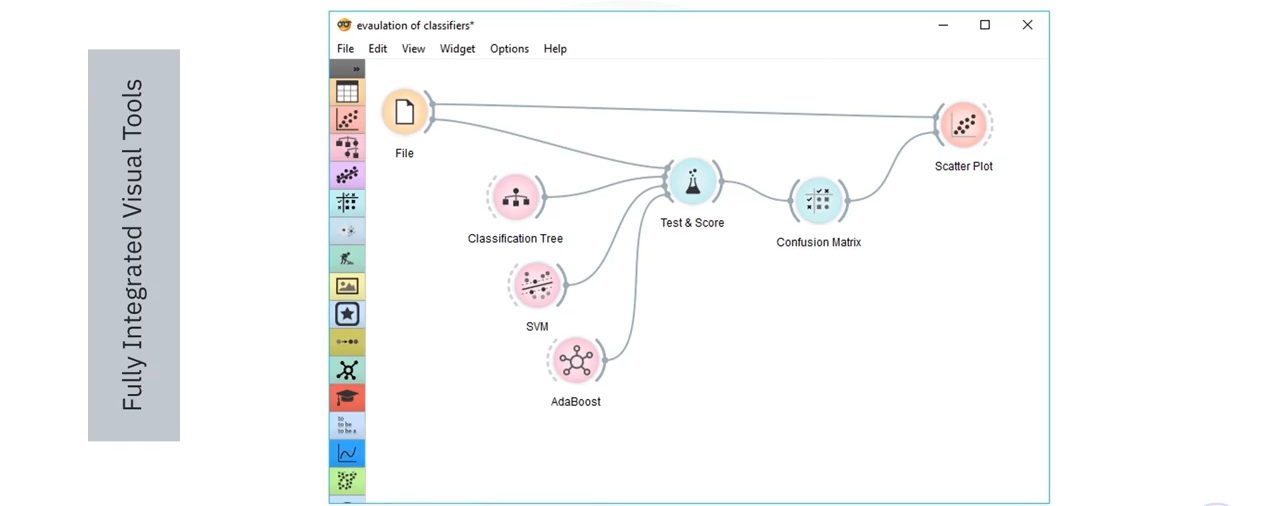
- 定位: Orange 是这类工具的另一个代表。
- 特点: 它不如 KNIME 灵活,但更易于使用。
🎓 在本视频中,您了解了数据科学中最常见的任务以及相关的开源工具。