Module 03 · Packages, APIs, Data Sets, and Models
Machine Learning Models – Learning from Models to Make Predictions机器学习模型与预测
欢迎观看“机器学习模型——从模型学习以进行预测”视频。看完本视频后,您将能够:
- 定义机器学习模型
- 描述不同的学习模型类型
- 描述如何使用学习模型解决问题
机器学习模型的概念
数据蕴含着丰富的信息,可用于解决某些类型的问题。
- 传统数据分析方法 可能是人工检查数据,或使用自动化人类分析的专用计算机程序。
- 这些方法在面对大量数据或问题复杂度高时会达到极限。
机器学习 (Machine Learning, ML) 使用 算法(也称为 “模型”)来识别数据中的模式。
- 模型从数据中学习这些模式的过程称为 “模型训练 (model training)”。
- 一旦模型经过训练,它就可以用于做出预测。
- 当模型接收到新数据时,它会根据从过去数据中学习到的模式尝试做出预测或决策。
机器学习模型的三大基本类型
机器学习模型可以分为三类:监督学习 (Supervised Learning)、无监督学习 (Unsupervised Learning) 和 强化学习 (Reinforcement Learning)。
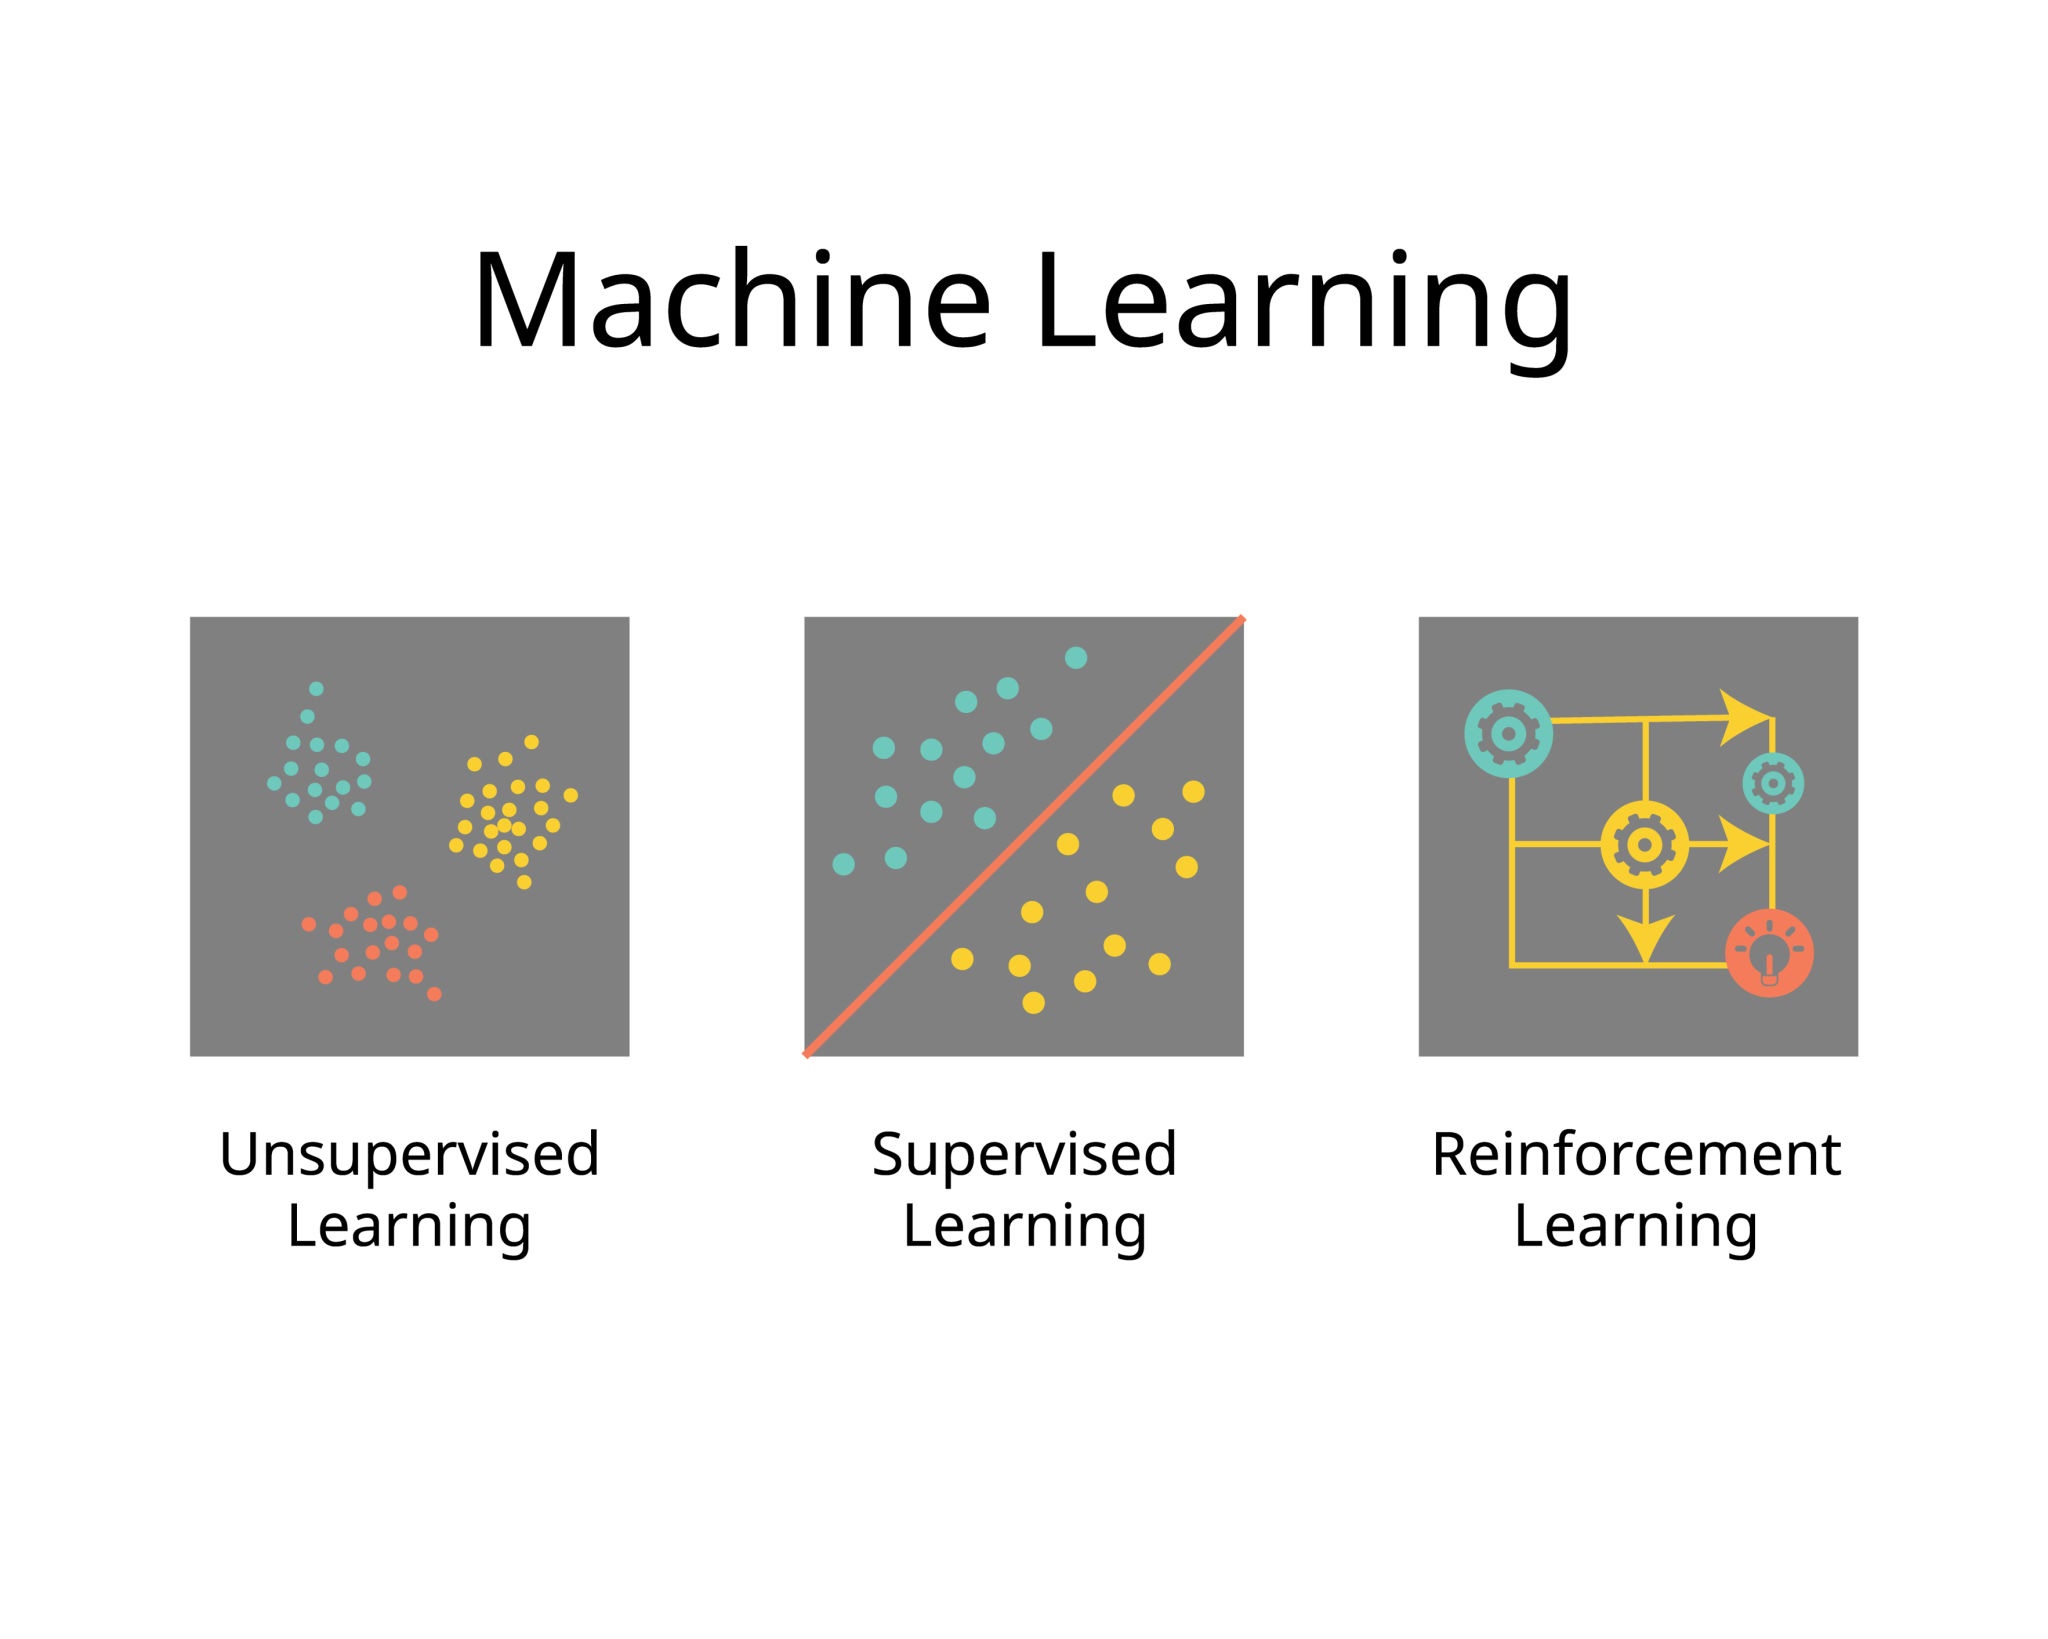
1. 监督学习 (Supervised Learning)
这是最常用的机器学习类型。
- 特点: 人类提供输入数据和正确的输出 (correct outputs)(即标签)。
- 模型任务: 模型尝试识别输入数据和正确输出之间的关系和依赖性。
- 模型类型: 监督学习包括两种类型的模型:
| 模型类型 | 目标 (预测) | 示例 |
|---|---|---|
| 回归模型 (Regression Models) | 用于预测一个数值(或“实数”)值。 | 如果提供过去房屋销售信息(地理位置、大小、卧室数量和销售价格),您可以训练模型来预测具有相似特征的其他房屋的估计销售价格。 |
| 分类模型 (Classification Models) | 用于预测某些信息或数据是否属于一个类别(或“类”)。 | 对于一组附有指示的电子邮件,您可以训练算法来识别它们是否应被视为垃圾邮件 (spam)。 |
2. 无监督学习 (Unsupervised Learning)
- 特点: 数据未经过人类标记。
- 模型任务: 模型必须分析数据并尝试根据数据的特征识别数据中的模式和结构。
- 模型示例:
- 聚类 (Clustering):用于将数据集的每条记录划分到相似的组中。
- 应用示例: 根据过去的购物行为和购物篮内容,为电子商务商店提供购买推荐。
- 异常检测 (Anomaly Detection):用于识别数据集中的异常值 (outliers),例如欺诈性信用卡交易或可疑的在线登录尝试。
- 聚类 (Clustering):用于将数据集的每条记录划分到相似的组中。
3. 强化学习 (Reinforcement Learning)
- 特点: 粗略地基于人类和其他生物的学习方式。
- 学习过程:
- 想象一只迷宫中的老鼠:如果老鼠到达迷宫终点,它会得到一块奶酪。这是完成任务的**“奖励 (reward)”**。
- 老鼠通过试错 (trial and error) 学习如何穿过迷宫,以获得尽可能多的奶酪。
- 模型任务: 强化学习模型以类似的方式,根据其当前环境学习采取最佳行动组合,以在一段时间内获得最大奖励。
- 应用示例: 这种类型的学习最近在击败围棋、国际象棋和流行的策略视频游戏等游戏中的最优秀人类玩家方面取得了巨大成功。
深度学习 (Deep Learning)
深度学习 是一种专业化的机器学习类型。
- 定义: 它指的是一套通用的模型和技术,大致模仿人类大脑解决各种问题的方式。
- 应用领域:
- 分析自然语言(口语和文本)
- 图像、音频、视频
- 预测时间序列数据
- 等等。
- 重要性: 深度学习最近在这些领域取得了巨大成功,因此它正成为数据科学中越来越流行和重要的工具。
深度学习模型的特点与实现
| 特点 (Characteristics) | 实现与工具 (Implementation) |
|---|---|
| 数据需求 | 需要大量的标记数据来训练模型。 |
| 计算需求 | 计算密集型 (compute intensive)。 |
| 硬件需求 | 通常需要专用硬件 (special purpose hardware) 才能实现可接受的训练时间。 |
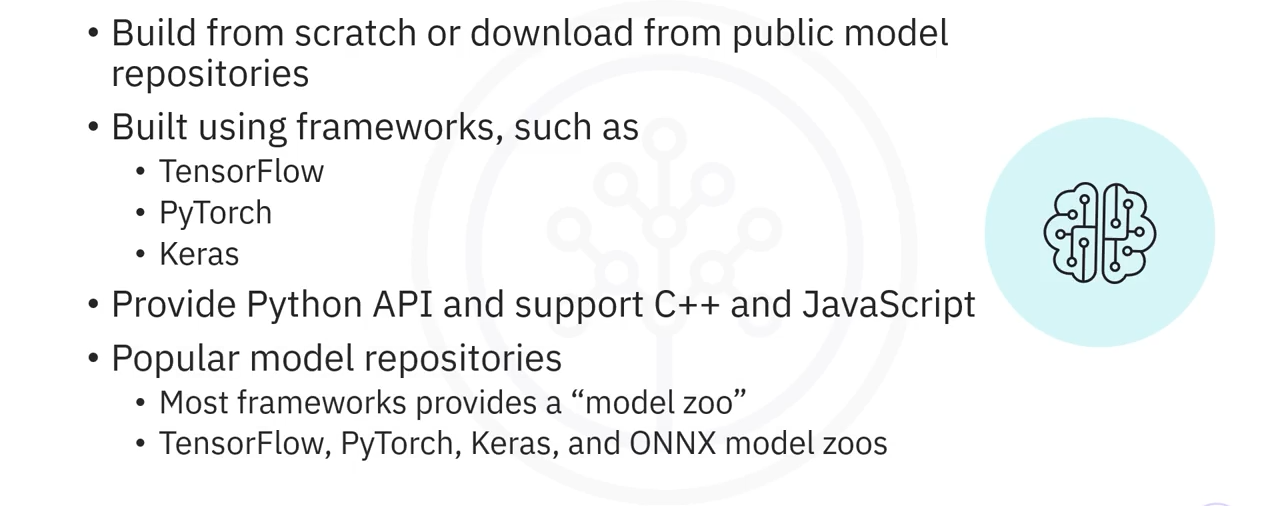
构建深度学习模型的高级任务
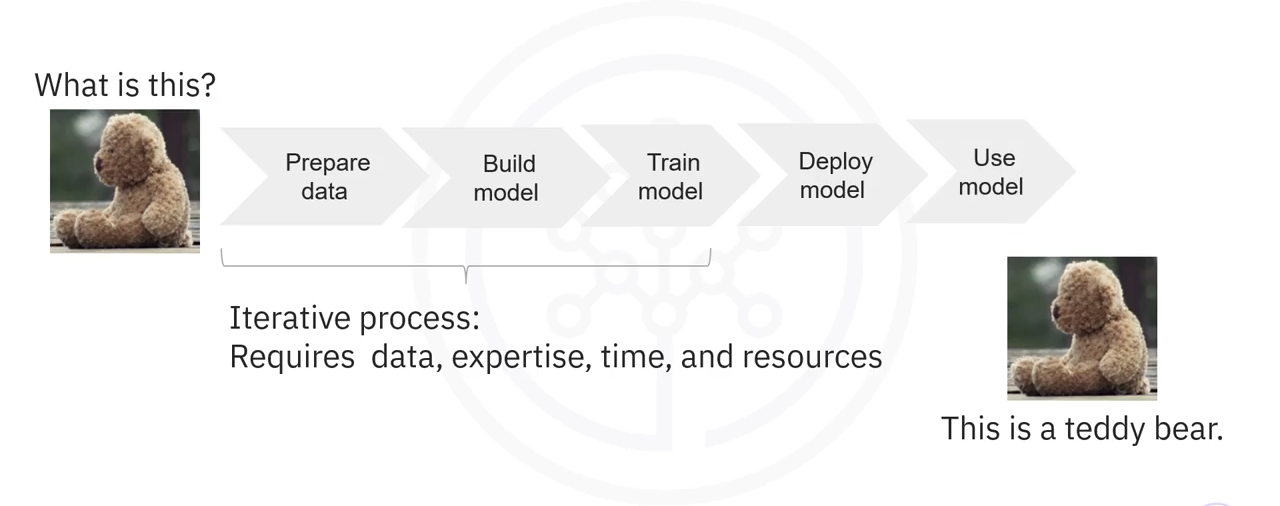
我们以训练一个深度学习模型来识别图像中的对象为例,简要概述构建模型所涉及的高级任务:
- 数据收集与准备 (Data Collection and Preparation) 📝
- 收集和准备将用于训练模型的数据。
- 数据准备可能是一个耗时且劳动密集的过程。
- 为了训练模型检测图像中的对象,您需要标记 (label) 原始训练数据。
- 示例: 您可以围绕对象绘制边界框 (bounding boxes) 并进行标记。
- 模型构建与选择 (Model Building or Selection) 🏗️
- 从头开始构建模型,或从公共或私有资源中选择一个可能非常适合该任务的现有模型。
- 模型训练 (Model Training) 🏋️
- 在您准备好的数据上训练模型。
- 在训练期间,您的模型从标记数据中学习如何识别图像中描绘的对象。
- 结果分析与迭代 (Analysis and Iteration) 🔄
- 训练开始后,您分析训练结果并重复该过程,直到训练模型的性能满足您的要求。
- 模型部署 (Model Deployment) 🚀
- 当训练模型的性能符合预期时,您将其部署以供应用程序使用。
总结要点
在本视频中,您了解到:
- 机器学习 (ML) 使用算法(也称为 “模型”)来识别数据中的模式。
- 模型学习数据模式的过程称为 “模型训练”。
- 机器学习的类型 有:监督学习、无监督学习 和 强化学习。
- 监督学习 包括两种类型的模型:回归 和 分类。
- 深度学习 指的是一套通用的模型和技术,大致模仿人类大脑解决各种问题的方式。