Module 01 · Recurrent Neural Networks
Notation序列模型的符号表示
在上一期视频中,您看到了许多可以应用序列模型的广泛领域。在本视频中,我们将开始定义一个符号系统,以帮助我们构建这些序列模型。作为一个动机性例子,假设您希望构建一个序列模型,输入一个句子:
Harry Potter and Hermione Granger invented a new spell.
(这些人物来自J.K. Rowling的《哈利·波特》系列小说)
假设您希望模型自动识别句子中哪些是人物姓名。这就是一个经典的命名实体识别(Named-Entity Recognition, NER)问题,这种技术常被搜索引擎用来识别新闻文章中的人物、公司、时间、地点等信息,以便为其正确索引。
1.命名实体识别的应用场景
命名实体识别系统广泛应用于:
- 新闻索引:搜索引擎可以通过NER技术,识别过去24小时内新闻文章中提到的所有人物姓名,并进行适当的索引。
- 多种文本类型的实体识别:包括人物姓名、公司名称、时间、地点、国家、货币等。
2.输入与输出的符号表示
假设输入 X 是如下的句子:
Harry Potter and Hermione Granger invented a new spell.
该句子包含 9 个单词,因此输入是一个长度为 9 的序列。在模型中,我们希望为每个输入的单词预测一个标签,输出的 Y 是与输入单词相对应的标签序列。目标输出是:
- 对于每个输入的单词,模型将告诉您该单词是否是一个人的名字。
2.1符号定义
我们用以下符号来表示输入和输出的序列:
- 输入序列:X,其中 表示序列中第 t 个位置的词。
- 输出序列:Y,其中 表示第 t 个词的标签(例如,是否是人的名字)。
- 输入序列的长度:,在本例中,。
- 输出序列的长度:,在本例中, 也为 9。
当处理多个训练样本时,记作:
- 表示第 i 个训练样本的输入序列。
- 表示第 i 个训练样本的输入序列的长度。
- 表示第 i 个训练样本中输出序列的第 t 个标签。
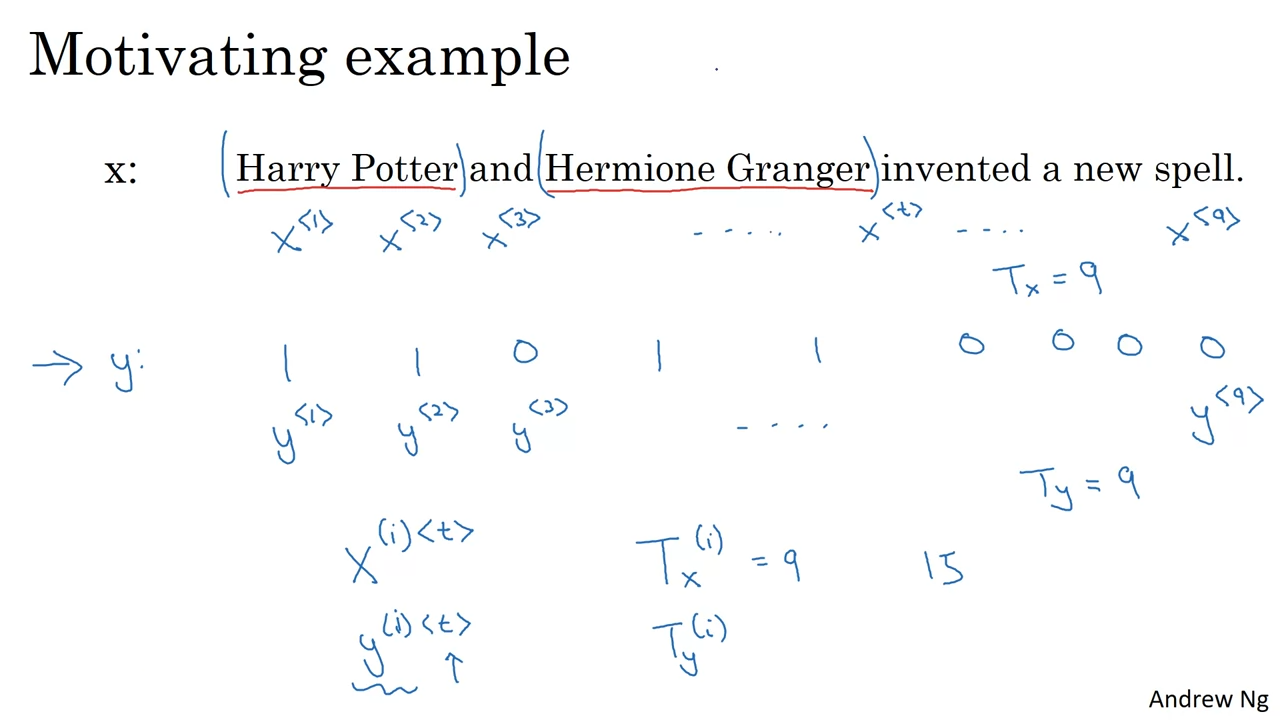
3.表示单词的方式
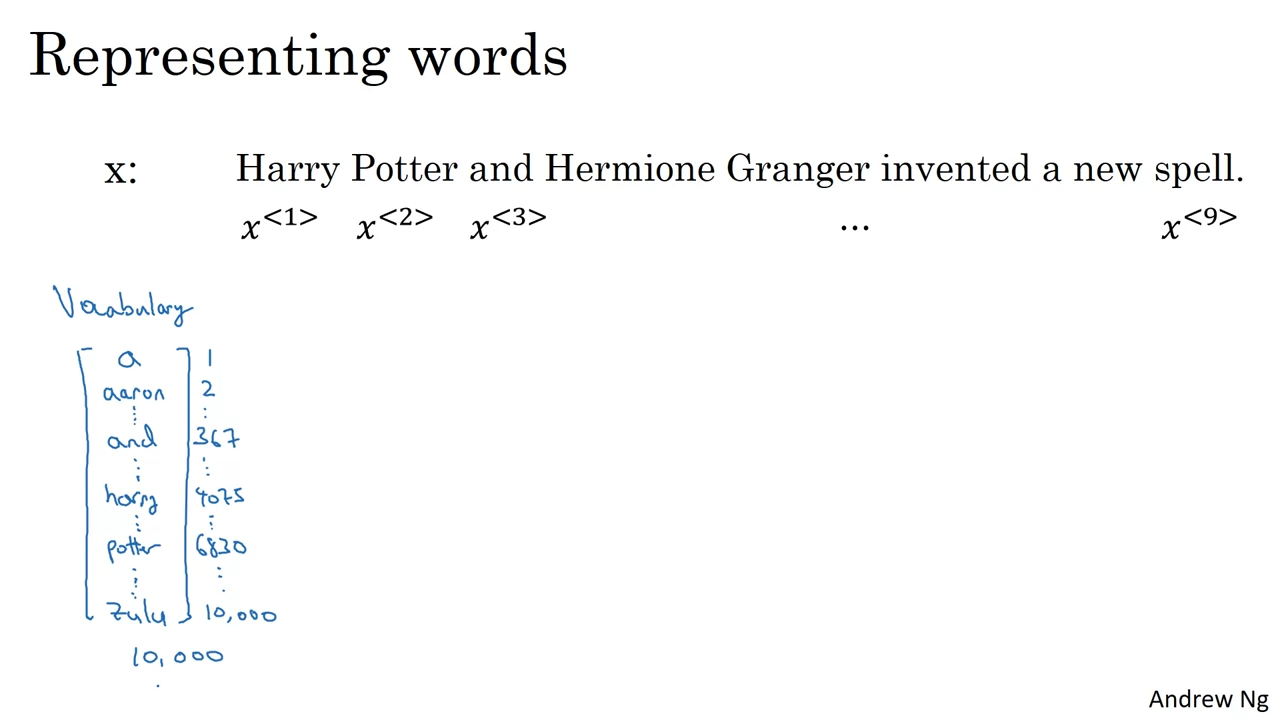
接下来,我们讨论如何表示一个句子中的单词。为了表示单词,首先需要构建一个词汇表(Vocabulary),也叫做字典(Dictionary)。词汇表的构建步骤如下:
- 列出训练数据集中所有的单词。
- 为每个单词分配一个唯一的索引,比如:
- 第一个单词
a在词汇表中为词汇位置 1。 - 第二个单词
Aaron为词汇位置 2。 Harry在位置 4075。Potter在位置 6830。Zulu可能在词汇表的最后,位置 10000。
- 第一个单词
在实际应用中,词汇表大小通常很大:
- 小型词汇表:10,000 个单词(本例所用词汇表大小)。
- 中型词汇表:30,000 到 50,000 个单词。
- 大型词汇表:一些互联网公司会使用高达 100,000,甚至达到 1,000,000 的词汇表。
3.1独热编码(One-hot Encoding)表示法
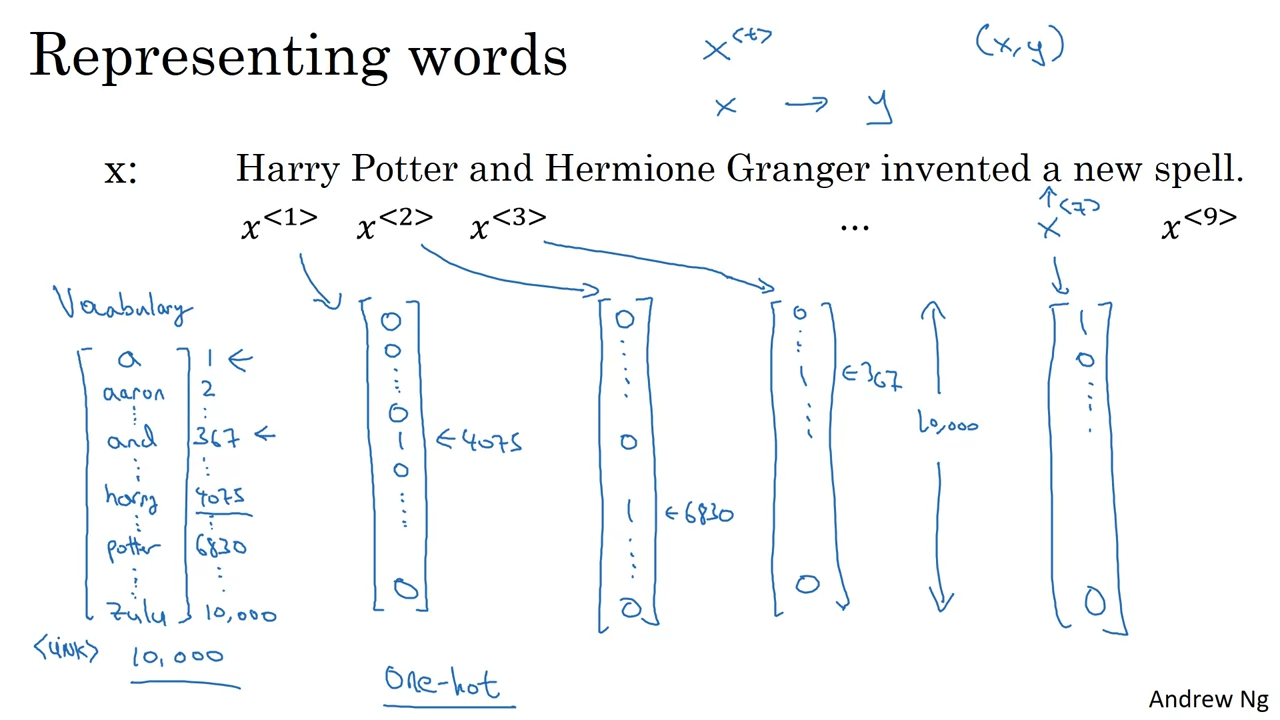
在独热编码中,每个单词都被表示为一个向量,向量的长度等于词汇表的大小。在本例中,词汇表大小为 10,000,因此每个单词的表示是一个 10,000 维的向量,只有一个位置为 1,其他位置均为 0。例如:
Harry在词汇表中的位置是 4075,因此x₁是一个全零向量,只有第 4075 个元素为 1。Potter在词汇表中的位置是 6830,因此x₂是一个全零向量,只有第 6830 个元素为 1。
3.2句子的表示
假设句子有 9 个单词(如 Harry Potter and Hermione Granger invented a new spell),每个单词用一个独热编码向量表示,总共有 9 个独热编码向量,每个向量的长度是 10,000。
x₁:Harry 的独热编码。x₂:Potter 的独热编码。x₃:and 的独热编码。- ...
4.词汇表外的词处理
如果在测试数据中出现一个在词汇表中没有的单词,怎么办?
- 答案是:使用一个特殊标记(通常称为 UNK,即“未知词”),表示该单词不在词汇表中。
总结
在本视频中,我们介绍了用于描述序列数据的符号系统,包括:
- 输入序列(X)和输出序列(Y)的表示。
- 如何构建一个简单的词汇表并使用独热编码表示单词。
在下一期视频中,我们将开始介绍递归神经网络(Recurrent Neural Networks, RNNs),并探讨如何使用这些网络来学习从 X 到 Y 的映射。