Module 02 · Natural Language Processing & Word Embeddings
Sentiment Classification情感分类
情感分类(Sentiment Classification)是指通过分析一段文本来判断人们对某个事物的喜好程度。它是自然语言处理(NLP)中的一个重要任务,广泛应用于各类实际场景中。尽管情感分类任务具有挑战性,但借助 词向量(Word Embeddings),即便是较小的标注数据集,也能构建出高效的情感分类模型。让我们一起来探索如何实现这一目标!🚀
情感分类任务
情感分类问题示例
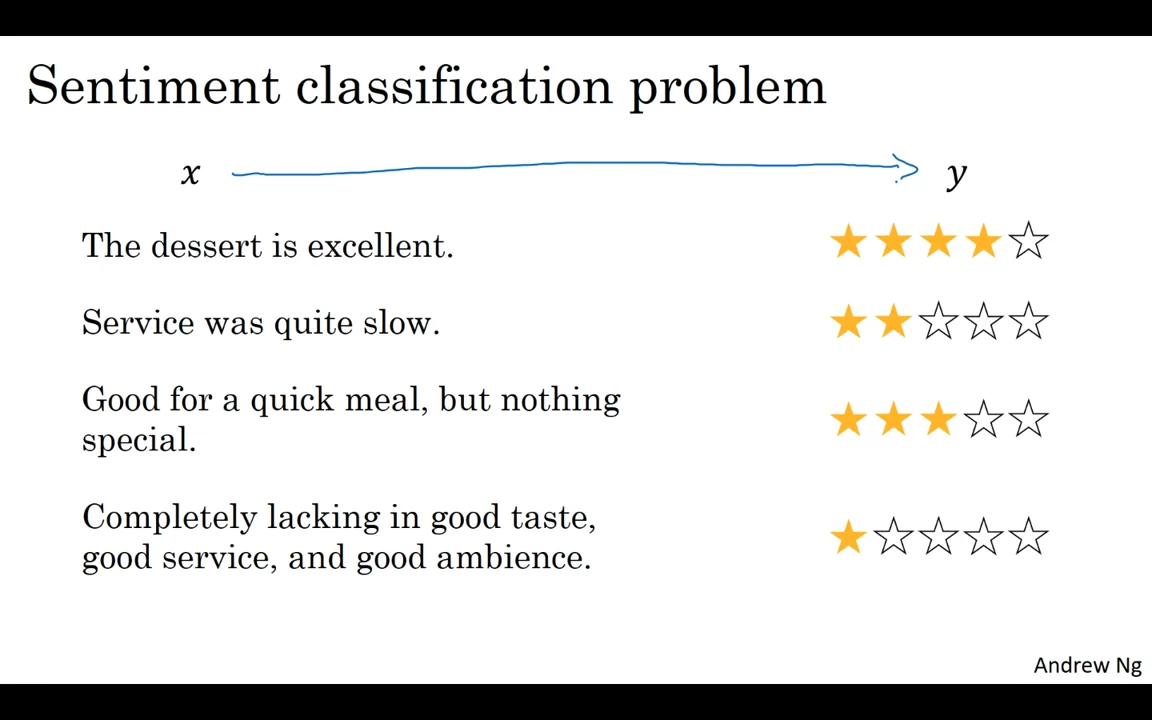
情感分类的输入 X 是一段文本,而输出 Y 则是对应的情感标签,通常为评分值(例如餐厅评论的星级评分)。例如:
- "The dessert is excellent" ➡ 四星评价
- "Service was quite slow" ➡ 两星评价
- "Good for a quick meal but nothing special" ➡ 三星评价
- "Completely lacking in good taste, good service, and good ambiance." ➡ 一星评价
通过训练模型将输入 X 映射到输出 Y,我们就能够监测人们对餐厅的评价,甚至可以通过社交媒体(如 Twitter、Facebook、Instagram)上的评论,自动判断评论内容是积极的还是消极的。
挑战
情感分类的一个挑战是:标注数据集的规模可能不大。比如,情感分类的训练集可能包含从 10,000 到 100,000 个词,甚至更少。然而,通过使用词向量,即使是在小规模标注数据集下,我们也能有效地进行情感分类。词向量能够从更大的语料库中捕获到丰富的语义信息,即便是一些不常见的词,也能在模型中起到作用。
构建情感分类模型
简单情感分类模型
我们可以通过以下步骤构建一个简单的情感分类模型:
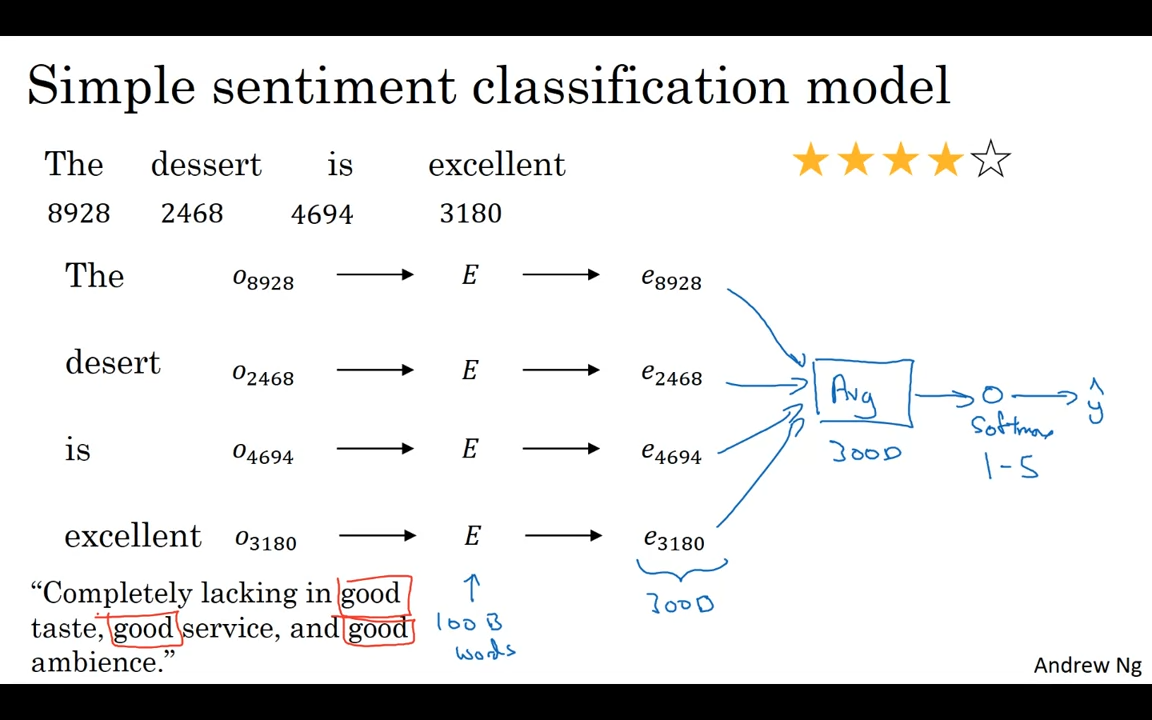
- 词汇查找与词向量提取 🔑 假设输入句子是 "dessert is excellent"。首先,我们可以从一个 10,000 词的词汇表中查找这些词,并利用词向量矩阵 E 提取每个词的嵌入向量。例如,通过查找每个词的 one-hot 向量,再将其与预训练的词向量矩阵 E 相乘,就能得到词汇的词向量。
- 词向量组合 ➗ 假设每个词的词向量是 300 维的,我们可以通过 加法 或 平均 的方式将这些词向量结合在一起。例如,句子 "dessert is excellent" 中的词向量可以通过加和或平均处理,得到一个 300 维的特征向量。
- 分类器预测 🧠 这个特征向量将作为输入传递给 Softmax 分类器,用来预测对应的情感标签(如 1 星到 5 星的评分)。
| 情感评分 | 预测概率 |
| --- | --- |
| 一星(1 Star) | 0.1 |
| 二星(2 Stars) | 0.2 |
| 三星(3 Stars) | 0.3 |
| 四星(4 Stars) | 0.3 |
| 五星(5 Stars) | 0.1 |
最终,分类器会输出最可能的情感评分。
该方法的优缺点
优点
- 简洁有效:即使是短小的评论,词向量的平均或加和方式也能提供有效的句子表示。
- 适用于长短评论:通过加和或平均所有单词的词向量,不论评论长度如何,都能生成统一的 300 维特征向量。
缺点
- 忽略词序信息:该方法将所有词的词向量简单加和或平均,忽略了词语的顺序信息。举个例子,句子 "Completely lacking in good taste, good service, and good ambiance" 中的“good”一词频繁出现,这种简单加和方法可能会导致模型误判为好评,即使这条评论实际上是非常负面的。
更复杂的情感分类模型:RNN
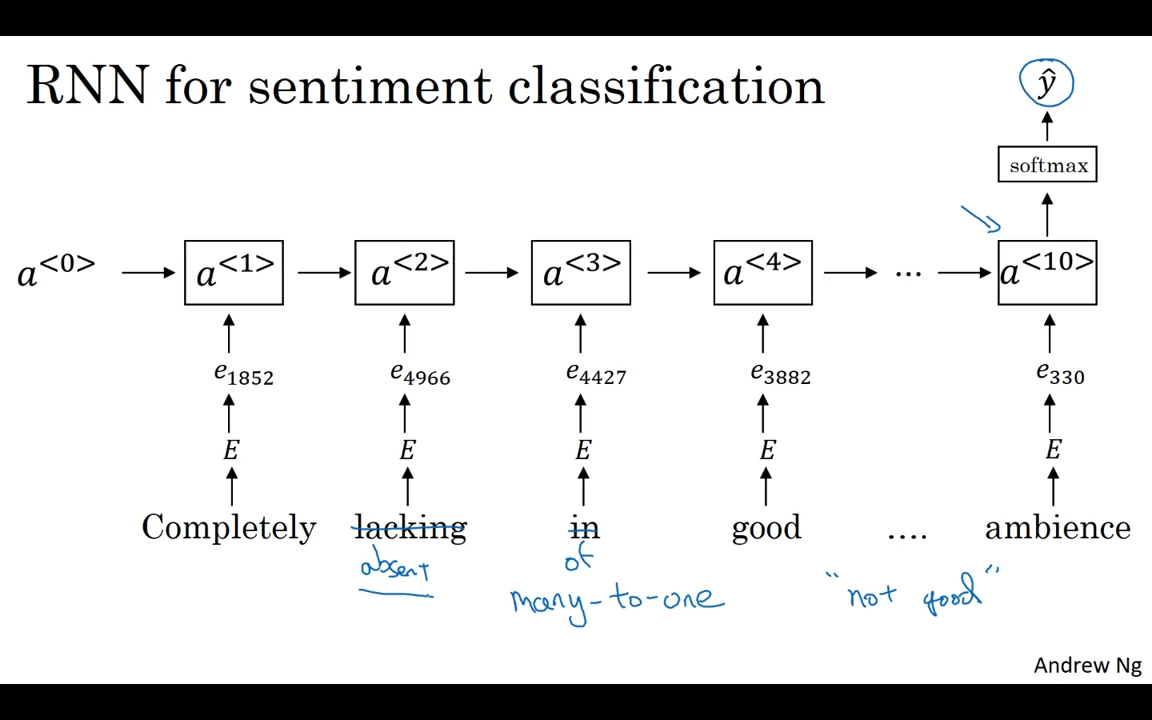
为了解决简单加和方法忽略词序的问题,可以采用 RNN(循环神经网络) 来进行情感分类。RNN 在处理文本时能够捕捉到词序信息,从而更准确地理解句子的语义。
- 词向量表示 🔠 与之前的方法相同,我们首先将每个词转换为 one-hot 向量,然后通过词向量矩阵 E 获取每个词的嵌入向量。
- 输入 RNN 🧠 将所有词的词向量输入到 RNN 中,RNN 会根据每个词的顺序处理信息,并在最后一个时间步(last timestep)输出一个代表整句话情感的向量。
- 情感预测 🔮 RNN 输出的特征向量将传递给 Softmax 分类器,进行情感评分的预测。
这种方法能够有效捕捉到句子中的负面词汇,比如 "not good" 或 "lacking in taste",从而准确区分正面和负面的情感。
RNN 方法的优势
- 考虑词序:与简单的加和方法不同,RNN 可以考虑词语的顺序,从而更准确地判断句子的整体情感。例如,“not good” 和 “good” 在情感上的含义完全不同,RNN 能够识别这种差异。
- 更好的泛化能力:通过预训练的词向量,RNN 能够利用大规模语料库的知识进行情感分类,即使在测试集中遇到未见过的词汇,它也能够根据上下文进行推断。
结论
通过构建情感分类模型,尤其是借助 词向量 技术,我们能够高效地分析文本中的情感,并将其转化为量化的评分。无论是简单的加和方法,还是更加复杂的 RNN 方法,都能在不同的场景下发挥重要作用。尽管简单的加和方法忽略了词序信息,但通过 RNN 这类更复杂的模型,我们可以更好地捕捉句子中的语义关系,从而提升情感分类的准确性。
希望这些内容能帮助大家理解如何使用 词向量 和不同的算法构建有效的情感分类系统!📊