Module 03 · Sequence Models & Attention Mechanism
Picking the Most Likely Sentence选择最可能的句子
在本视频中,我们将探讨 序列到序列(Sequence-to-Sequence)机器翻译模型 与你在课程第一周中接触过的 语言模型 之间的异同。虽然这两者之间有一些相似之处,但也存在显著的差异。让我们一起来看看!🔍
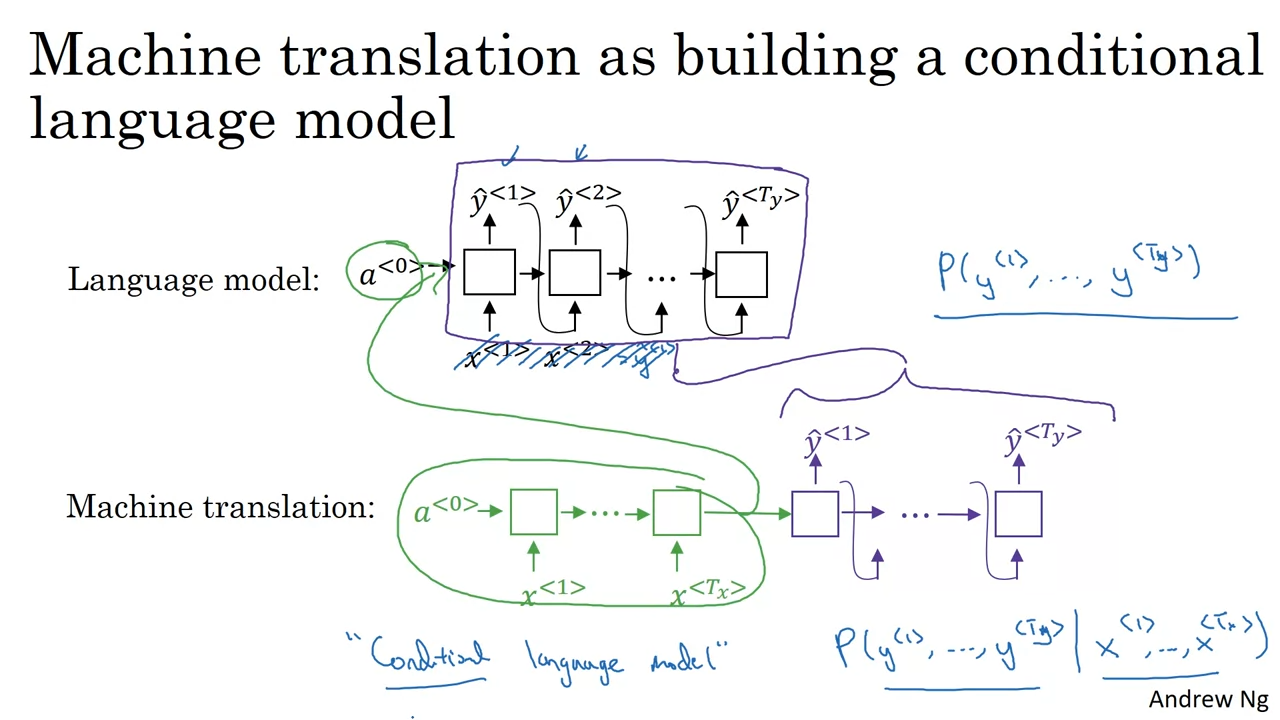
语言模型回顾
首先,回顾我们在第一周建立的语言模型。在语言建模中,网络的任务是估计一个句子的概率,这就是语言模型的作用。你还可以使用它来生成新的句子。
在语言模型中,我们通常会有以下结构:
- x1 到 xT 代表输入序列中的词汇。
- 网络基于前一个词汇(x1, x2, ...)来预测下一个最可能出现的词汇。
然而,在这个模型中,x1, x2, ... 的具体顺序并不重要,可以看作是对上一个词的反馈。为了简化说明,我们将 x1 设置为一个零向量,x2, x3 等是前一个词生成的输出。
机器翻译模型的架构
接下来,我们来看机器翻译模型。我们可以使用不同的颜色来区分模型的不同部分:
- 绿色 代表 编码器网络(Encoder Network)
- 紫色 代表 解码器网络(Decoder Network)
编码器与解码器的关系
机器翻译模型与语言模型非常相似,唯一的区别是:
- 语言模型 是从一个零向量开始,预测句子中的每个词。
- 机器翻译模型 则不再从零向量开始,而是利用编码器提取输入句子的表示,作为解码器的初始输入。
简言之,机器翻译模型是一个条件语言模型,它的任务是计算 给定输入法语句子,输出对应的英文翻译的概率。
条件语言模型定义
在这种模型中,你希望计算的是 英文翻译的条件概率,即:
- 给定 法语句子(例如 "Jane visite l'Afrique en septembre"),
- 求 英文翻译 的概率(例如 "Jane is visiting Africa in September")。
目标: 你不是在随机选择翻译,而是希望最大化条件概率,即给定法语句子后,找到最可能的英文翻译。
避免随机选择翻译
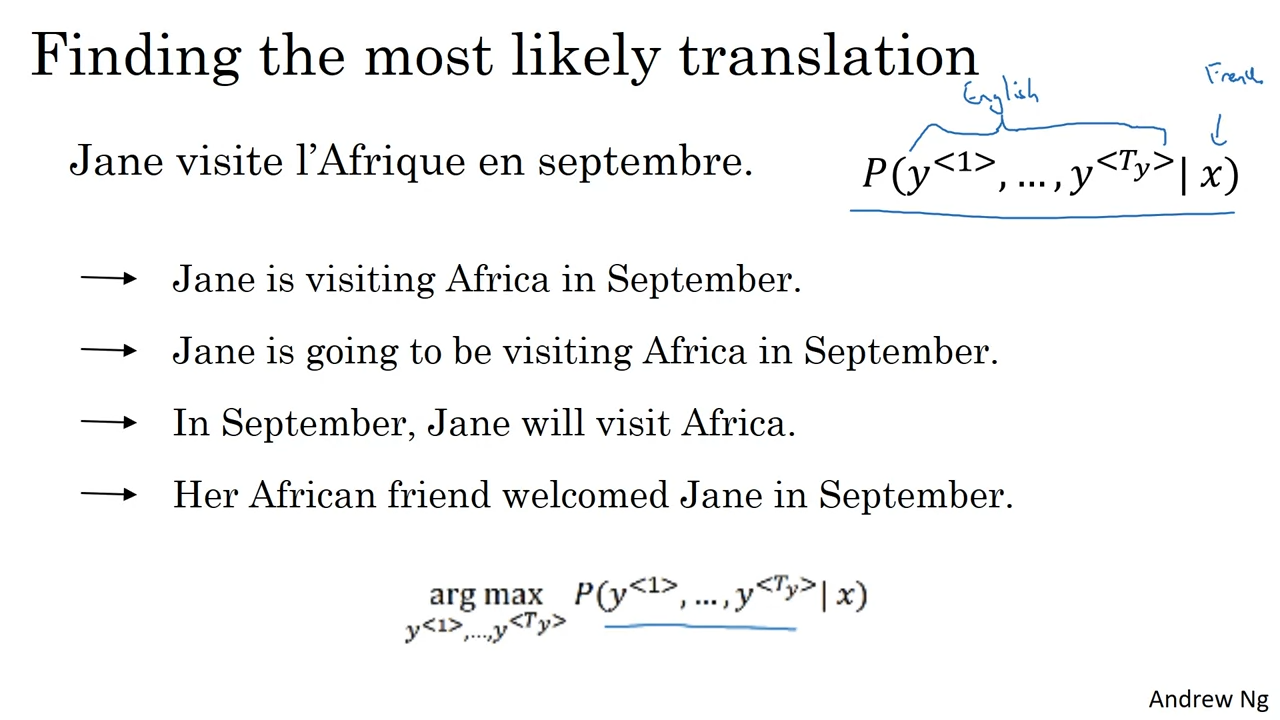
如果你从这个条件分布 P(y|x) 中随机抽取输出,你可能得到不同的翻译。例如:
- “Jane is visiting Africa in September.” 可能是一个不错的翻译。
- “Jane is going to be visiting Africa in September.” 可能有些生硬。
- “In September, Jane will visit Africa.” 可能也不是最优的。
- 偶尔可能得到一个不太准确的翻译:“Her African friend welcomed Jane in September.”
因此,我们的目标是 找到最大化条件概率的翻译,而不是随机选择输出。
贪心搜索与束搜索(Beam Search)
贪心搜索(Greedy Search)
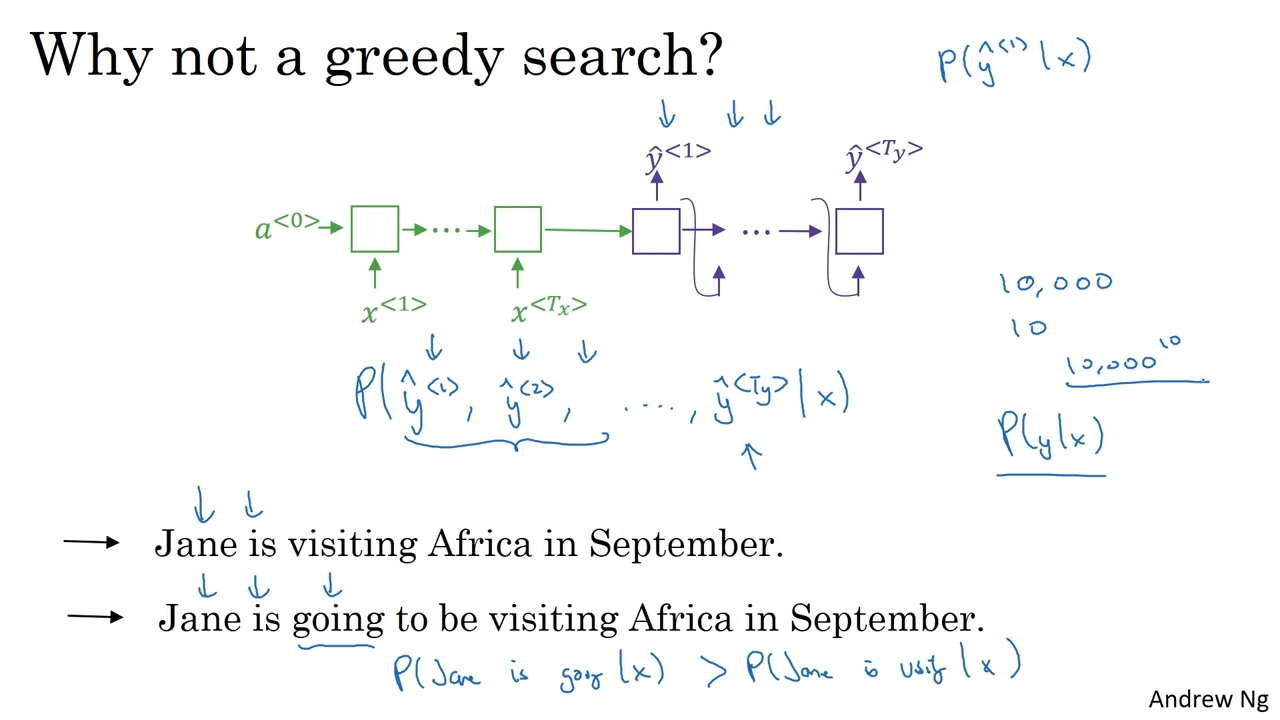
贪心搜索 是一种常见的计算机科学算法,其策略是:
- 生成第一个词:选择根据条件语言模型最可能的第一个词。
- 生成第二个词:根据已生成的第一个词,选择最可能的第二个词。
- 依此类推,生成后续的词。
然而,贪心搜索 的问题是,它只是局部最优的选择,不能保证全局最优。
为什么贪心搜索不可行?
让我们通过以下例子来说明:
- 假设翻译 "Jane is visiting Africa in September" 是最优的。
- 另一种翻译 “Jane is going to be visiting Africa in September” 虽然不是错误的,但会显得冗长。
如果贪心算法在选择第一个词时选择了 "Jane is"(因为 "going" 是一个更常见的单词),那么很可能后续选择的翻译就会是更冗长的表达形式,导致最终翻译效果不如直接选择 "Jane is visiting"。
搜索空间与优化问题
英语句子的组合数量是 指数级增加 的:
- 假设字典中有 10,000 个词汇,如果翻译句子的长度为 10 个词,那么可能的句子数量就是 10,000 的 10 次方。
- 显然,这个搜索空间是巨大的,不可能枚举所有可能的句子。
因此,我们需要使用 近似搜索算法 来从这个庞大的搜索空间中找到最优的句子。
束搜索(Beam Search)
为了解决贪心搜索的局限性,我们采用了 束搜索(Beam Search)。束搜索能够在大量可能的翻译中找到一个接近最优的解。束搜索会保持 多个候选翻译,而不是仅仅选择每个步骤中最可能的单词,从而避免陷入局部最优解。
束搜索会在每一步生成多个候选序列,并在后续步骤中继续扩展这些序列,最终选择最优的翻译。
总结与展望
本视频讲解了如何将 机器翻译问题 转化为 条件语言建模问题,并探讨了与语言建模的差异。特别是,机器翻译并不希望随机生成句子,而是希望通过搜索找到 最可能的英文翻译。
然而,由于可能的句子数量庞大,我们不能直接枚举所有翻译。因此,我们需要 束搜索 等近似搜索算法来找到最优解。接下来的视频将深入介绍 束搜索算法 的具体实现,敬请期待!🔍