Module 03 · Sequence Models & Attention Mechanism
Speech Recognition语音识别
序列到序列模型(Sequence-to-sequence models)的一项令人兴奋的进展是非常准确的语音识别技术的崛起。在本课程即将结束之际,我们将用几段视频来介绍这些模型是如何应用到音频数据中的,特别是语音识别。
什么是语音识别问题?
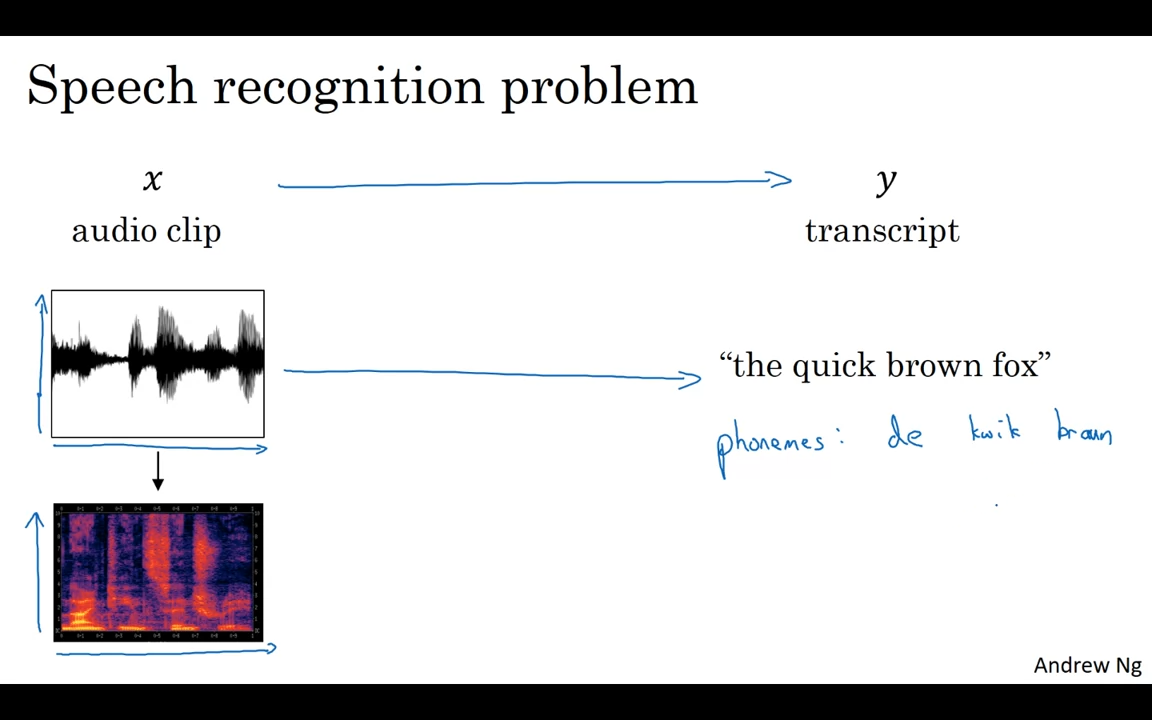
在语音识别中,任务是:给定一个音频片段 x,需要自动地生成它的文本转录 y。
- 音频数据的表现:
如果将音频片段绘制成图形,横轴表示时间,纵轴则是音频的频率或气压变化。
麦克风测量的是空气压强的微小变化,而人耳感知声音的方式也是通过检测空气压强的变化,通常这些变化是由扬声器或耳机产生的。
这种音频波形图描绘的是空气压强随着时间的变化。
例如,假设这段音频是我在说 "the quick brown fox",理想情况下,语音识别系统应该能够识别这段音频并输出相应的文本转录。
音频预处理:频谱图的生成
由于人耳并不会直接处理原始的音频波形,而是通过身体的结构感知不同频率的强度,因此常见的音频预处理步骤是:将原始音频转化为频谱图(Spectrogram)。
- 频谱图的表现:
- 横轴:表示时间
- 纵轴:表示频率
- 不同的颜色强度表示不同频率的音频强度,显示在不同时间上的能量变化。
这种频谱图的生成过程类似于人耳的听觉处理机制,通常在音频输入到语音识别系统之前进行。
传统语音识别与深度学习的转变
过去,语音识别系统通常依赖音素(phonemes),即手工设计的基本声音单元。举例来说,"the quick brown fox" 可以分解为以下音素:
- "the" → "de", "e"
- "quick" → "ku", "wu", "ik", "k"
- "brown" → 类似这样进一步拆解
语言学家曾认为,通过将音频拆解成音素来进行语音识别是最有效的方式。
然而,随着端到端深度学习(End-to-End Deep Learning)的出现,音素表示已经不再是必须的。现在的系统可以直接从音频片段输入,输出完整的文本转录,而不需要依赖这些手工设计的音素。
为什么深度学习可以更好地进行语音识别?
大数据集的引入是这一转变的关键因素之一。过去,学术界通常使用300小时的数据集进行语音识别,而现在,最好的商业系统已经在超过10,000小时,甚至超过100,000小时的音频数据上进行训练。
通过使用更大规模的转录音频数据集(其中包含输入音频 x 和对应的文本转录 y),结合深度学习算法,推动了语音识别的巨大进步。
如何构建一个语音识别系统?
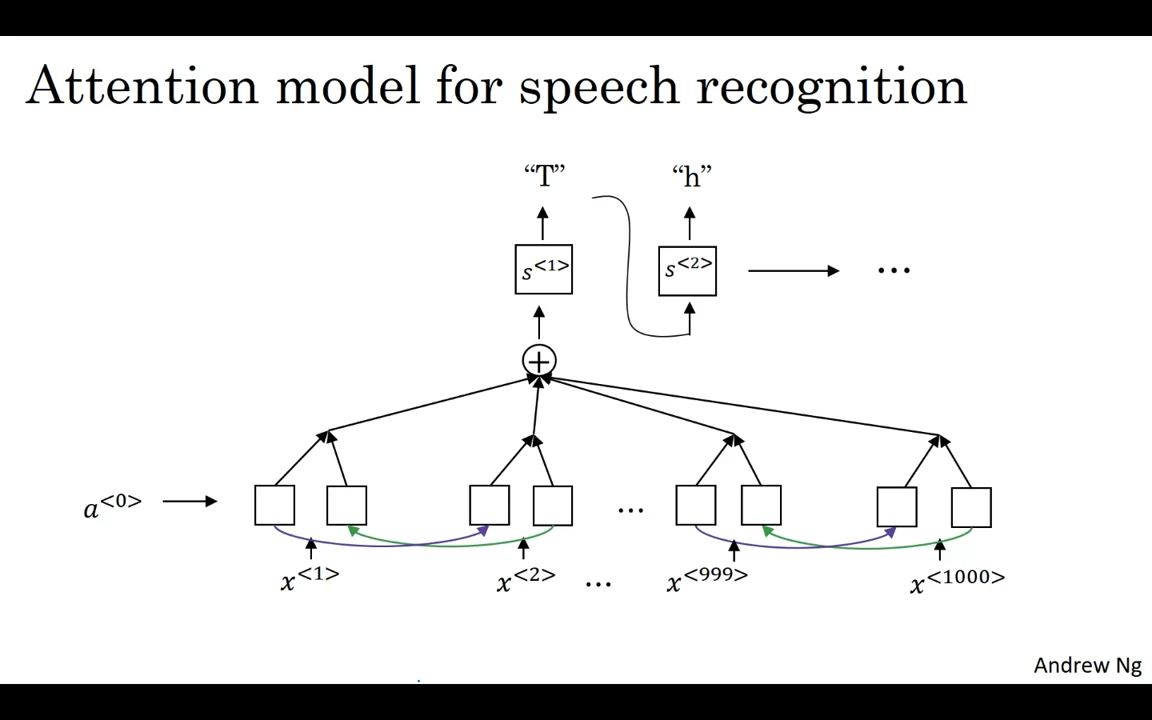
在前一视频中,我们介绍了Attention模型。对于语音识别问题,你可以使用Attention机制,基于音频输入的不同时间帧,输出相应的文本转录,例如 "the quick brown fox"。
然而,另一种有效的语音识别方法是使用CTC损失函数(CTC Loss)进行训练,这种方法由Alex Graves、Santiago Fernandes、Faustino Gomez 和 Jürgen Schmidhuber 提出。
CTC(Connectionist Temporal Classification)概念
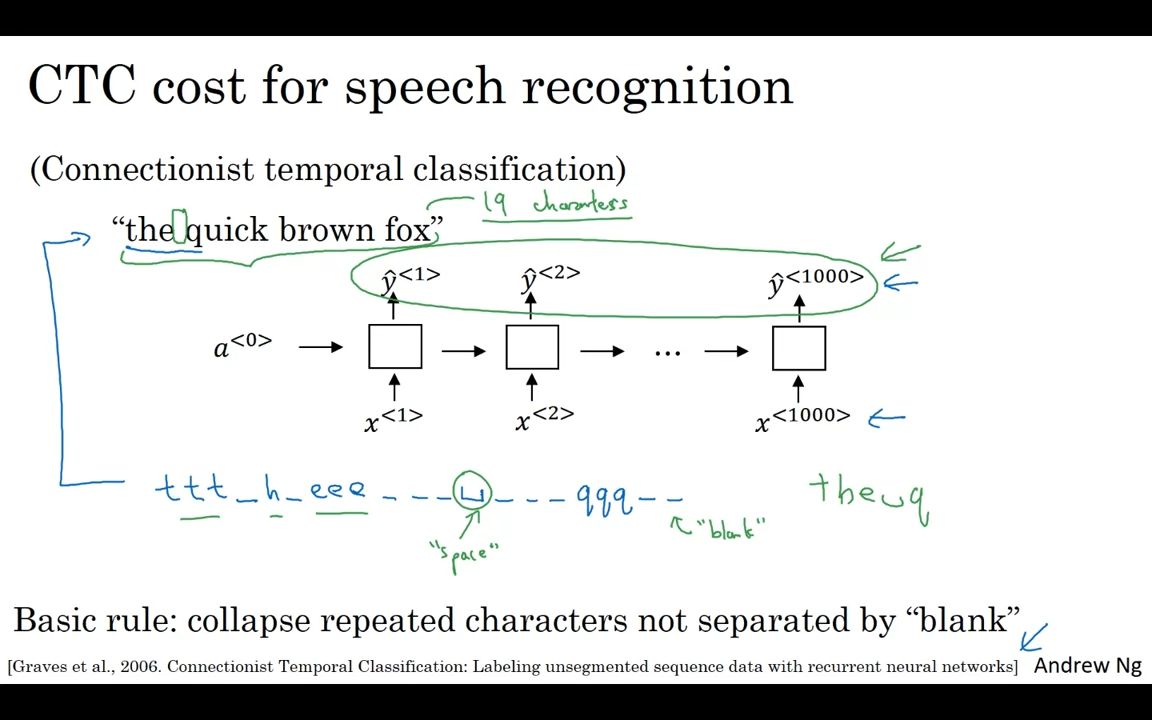
CTC的基本思路是,音频片段的输入时间步远远大于输出时间步。在语音识别中,通常输入时间步的数量比输出时间步多得多。
假设你有一个10秒钟的音频,采样率为100赫兹(即每秒100个采样点),那么该音频将有1000个输入(100Hz × 10秒)。但是,你的输出不一定有1000个字符。
CTC损失函数允许神经网络生成如下输出:
t t t _ h _ e e e _ _ _ _ q q q _
这里,_ 表示一个空白字符(blank character),它的作用是省略重复字符。例如,在“the quick brown fox”中,重复的 t、e、q 等字符,会被压缩成单一字符。
CTC规则:
- 重复字符(不被空白字符分隔)会被合并,形成正确的输出。
- 例如,
ttt会被合并为t,eee会合并为e,这样可以将输入时间步的大量信息压缩成较短的输出文本。
通过这种方式,即使输出字符较少,也可以通过插入空白字符来“填充”出原本冗长的输入序列。
**举例:**对于“the quick brown fox”这句话,包含19个字符,但通过CTC损失函数,网络可以生成一个包含1000个字符的输出,最终通过空白字符合并重复字符,生成正确的文本。
实践中的应用:CTC与商业语音识别系统
- 论文:Alex Graves提出的CTC方法,以及百度的Deep Speech系统,都采用了这种方法来构建有效的语音识别系统。
总结:语音识别的两种方法
目前,语音识别有两种主要的方式:
- Attention模型:
通过将不同时间帧的音频输入,利用Attention机制直接生成文本转录。 - CTC损失函数:
利用**CTC(Connectionist Temporal Classification)**损失函数,解决音频输入时间步与输出时间步不一致的问题。
这两种方法各有优势,且都已广泛应用于实际的语音识别系统中。
未来展望:触发词检测
目前,构建一个有效的大规模语音识别系统需要大量的数据集和计算资源。然而,在下一个视频中,我将介绍如何构建一个简单的触发词检测系统(Trigger Word Detection),这种系统可以在较小的数据集上实现,且相比大规模语音识别系统更为简单。
敬请期待!