Module 04 · Transformer Network
Transformer Network IntuitionTransformer 网络直观理解
在深度学习领域,最令人兴奋的发展之一就是 Transformer 网络(有时也称为 Transformers)。这种架构在 自然语言处理(NLP) 领域掀起了革命,许多最有效的 NLP 算法今天都基于 Transformer 架构。虽然 Transformer 架构相对复杂,但在接下来的四个视频中,我们将逐步深入探讨,使你对其工作原理有一个全面的理解,并能够应用到自己的问题中。
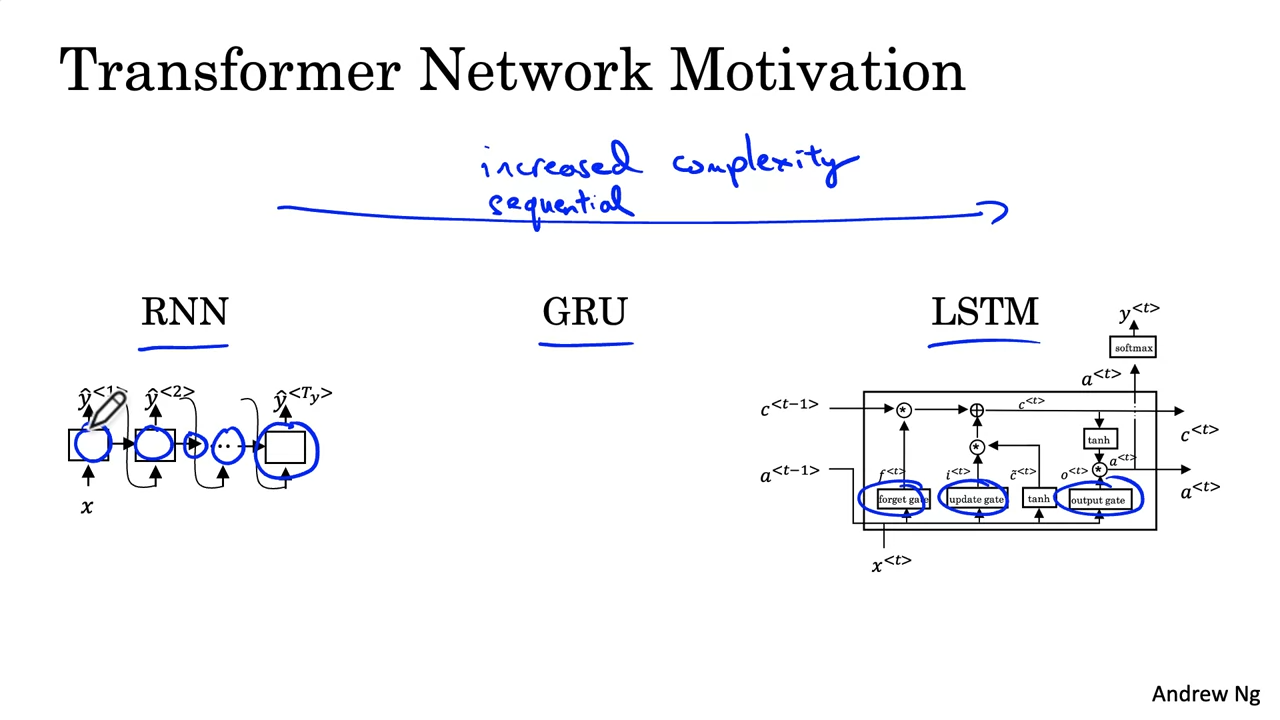
序列任务的复杂性与模型的演变
随着你的序列任务的复杂性增加,模型的复杂性也会相应增加。在本课程开始时,我们从 RNN(循环神经网络)开始,发现它存在 梯度消失 问题,这使得它很难捕捉序列中的长程依赖关系。随后,我们介绍了 GRU(门控循环单元)和 LSTM(长短期记忆网络),这两种模型通过使用门控机制来控制信息流动,解决了许多问题。
虽然这些更新的模型改善了信息流动的控制,但它们也带来了 更高的复杂性。因此,随着我们从 RNN 到 GRU 再到 LSTM,模型变得越来越复杂。而所有这些模型仍然是 序列模型,因为它们处理输入时,通常是一次处理一个词或一个标记(token)。每个单元都像是信息流动的瓶颈 —— 例如,为了计算最终单元的输出,你必须先计算所有之前单元的输出。
Transformer:并行计算的革命
在这一视频中,我们介绍了 Transformer 架构,它允许你并行处理整个序列的计算。这意味着你可以 同时处理整个句子,而不是像以前那样逐个词地从左到右处理。
Transformer 架构的核心创新
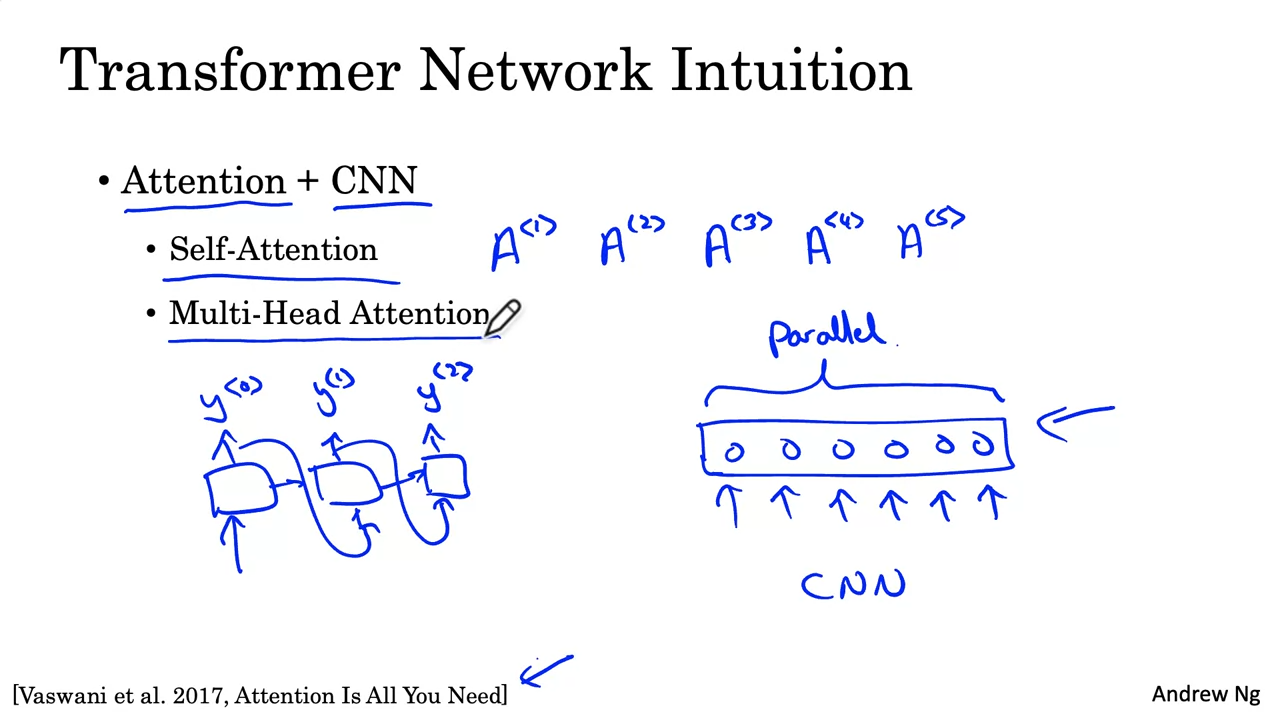
Transformer 架构的主要创新在于将 基于注意力机制(Attention) 的表示方法与 卷积神经网络(CNN) 风格的处理方式结合起来。
- RNN 是逐步处理输出的,每次计算一个输出,先计算 y(0),然后使用它来计算 y(1),再计算 y(2),依此类推。这是处理标记的 顺序方式。
- 与之相对的,CNN 可以同时处理多个输入,如大量的像素或多个词,并行计算表示。
在 注意力网络(Attention Network) 中,你会看到一种计算非常丰富、非常有用的词表示的方法,并且这种方法更类似于 CNN 的并行处理。
注意力机制的关键概念
为了理解注意力网络,接下来有两个关键概念将帮助你深入了解:
- 自注意力(Self-Attention)
- 自注意力的目标是,如果你有一个包含 5 个词的句子,你将最终为这 5 个词计算出 5 个表示(表示为 A1, A2, A3, A4, A5)。这是一个基于注意力的方式,用来 并行计算句子中所有词的表示。
- 多头注意力(Multi-Headed Attention)
- 多头注意力其实是对 自注意力 过程的一个 循环,所以你最终会得到多个版本的这些表示。这些表示是非常丰富的,可以用来解决 机器翻译 或其他 NLP 任务,效果非常好。
后续学习安排
接下来的几个视频中,我们将分别讲解:
- 自注意力(Self-Attention):计算这些丰富的词表示。
- 多头注意力(Multi-Headed Attention):深入探讨如何利用多头注意力进一步增强模型的表现。
- 最终,我们将把这些概念整合起来,全面解析 Transformer 架构的工作原理。
总结
- 在本课程中,你已经了解了 Transformer 网络 这一深度学习的革命性架构。
- 接下来的学习将帮助你更深入理解 Transformer 网络,并能够将其应用于 NLP 任务。
让我们继续在下一个视频中深入学习 自注意力(Self-Attention)!