Module 01 · Recurrent Neural Networks
Backpropagation Through Time通过时间的反向传播
在本视频中,我们将深入探讨 递归神经网络(RNN) 中反向传播的工作原理。尽管在实际编程中,许多深度学习框架会自动处理反向传播的过程,但理解其背后的机制对加深我们对 RNN 的理解依然至关重要。让我们来详细了解反向传播的过程吧!🧠
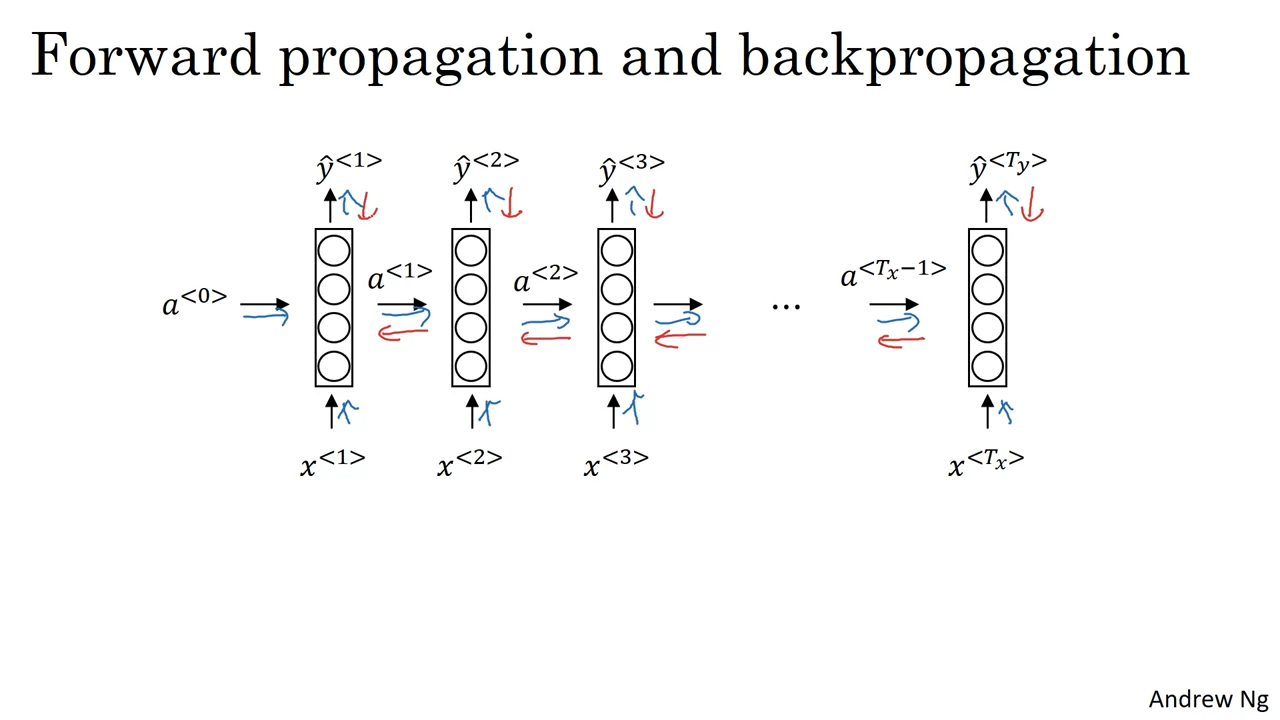
1.正向传播回顾
在理解反向传播之前,首先回顾一下 正向传播 的过程。
给定输入序列 ,神经网络通过以下步骤计算每一时刻的激活值:
- 使用 和 计算激活值 。
- 使用 和 计算 ,依此类推,直到最后一个时刻 。
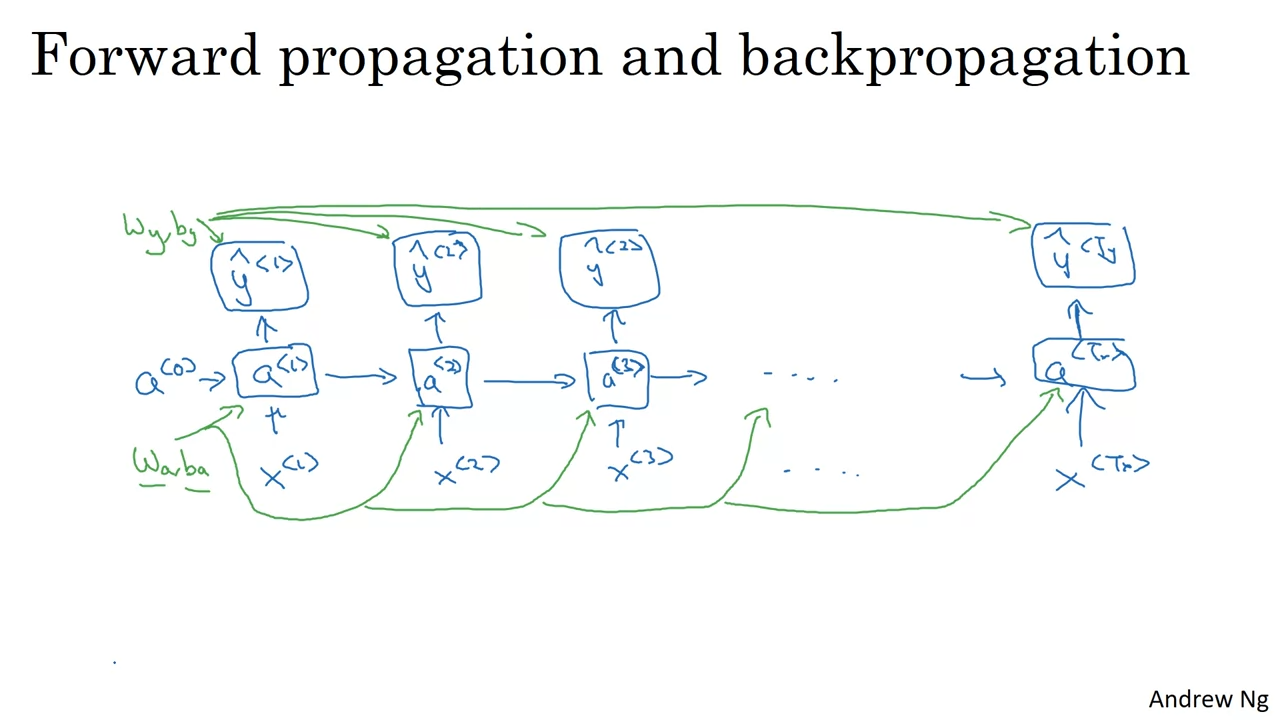
每个时间步的计算都依赖于一组参数 和 ,这些参数在每个时间步中都是相同的,即它们在整个序列的每个时间步上共享。
激活值与预测
- 给定每个时刻的激活值 ,神经网络会计算每个时刻的预测值。
- 计算预测 需要用到参数 和 ,这些也是在每个时间步共享的。
2.反向传播的计算
反向传播的目标是根据最终的 损失函数 计算梯度,并更新神经网络的参数。反向传播实际上是正向传播的反向过程,计算方向正好相反。
2.1损失函数定义
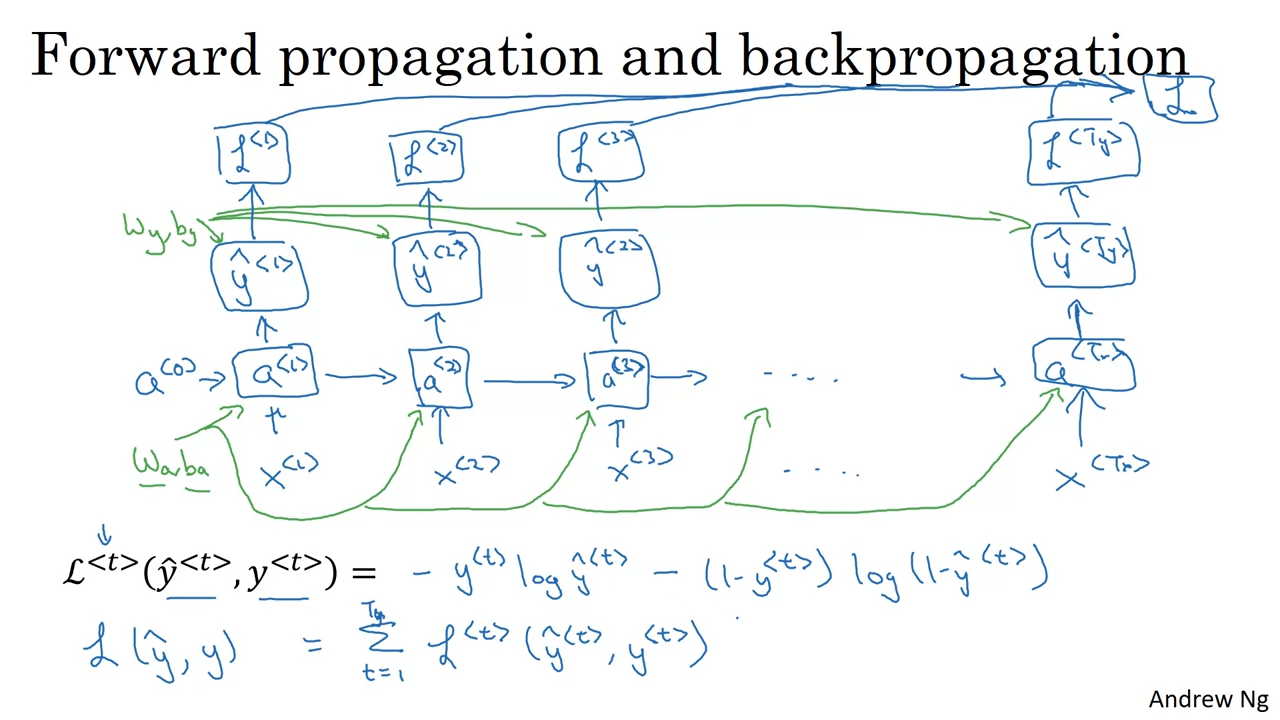
在反向传播之前,首先定义损失函数。假设我们有一个单词序列,目标是判断某个单词是否属于一个人名。对于某个特定的时间步 t,我们定义:
- 如果 ,表示这个单词是人名。
- 网络输出的 可能是一个概率值(例如 0.1),表示该单词是人名的概率。
这种损失通常采用 逻辑回归损失(也叫 交叉熵损失),用于衡量预测与真实标签之间的差异。
2.2序列总损失
为了计算整个序列的损失,我们将每个时间步的损失累加起来:
其中, 是序列的输出长度。总损失是各时间步损失的总和。
3.反向传播步骤
在反向传播过程中,我们需要计算每个参数的梯度并更新它们。这个过程就是通过梯度下降算法进行优化的。反向传播的关键步骤包括:
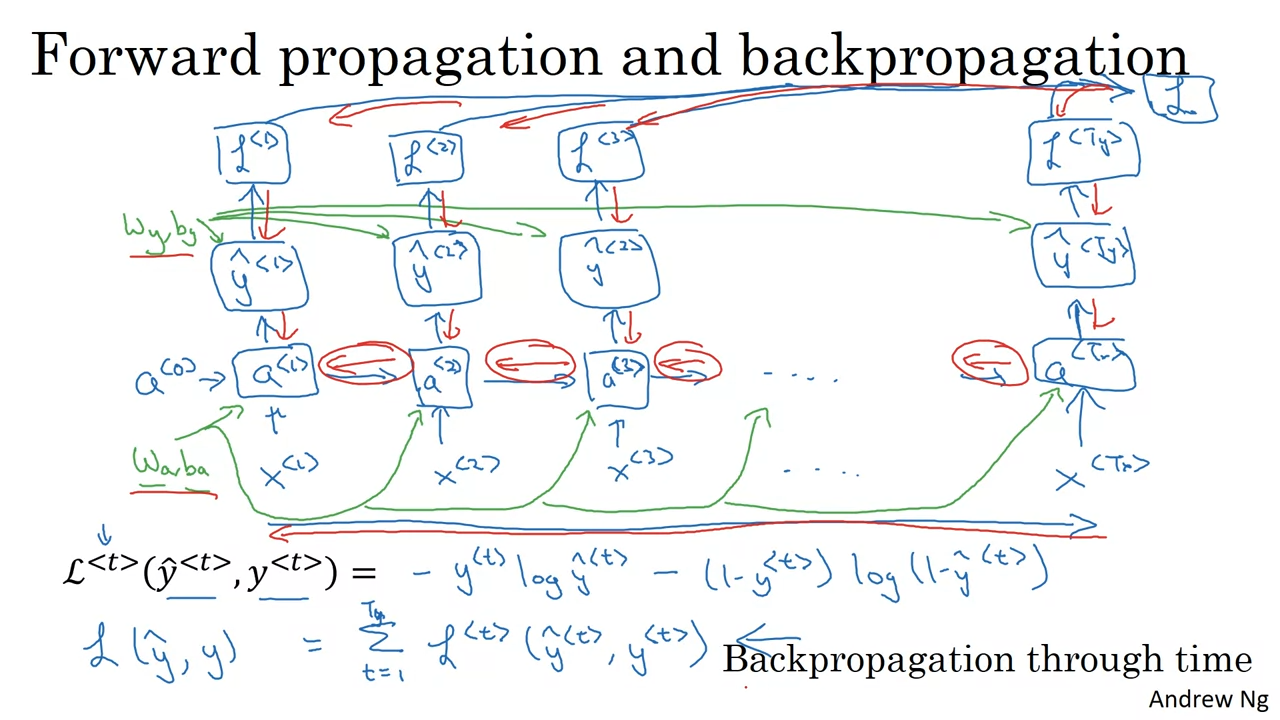
- 计算每个时间步的梯度:从最后一个时间步 开始,逐步计算每个时间步的梯度,并向前传递。
- 更新参数:根据计算出的梯度,使用梯度下降算法更新参数 、 和 、。
4.通过时间的反向传播(BPTT)
这个算法的名称为 通过时间的反向传播(Backpropagation Through Time, BPTT)。其命名的原因在于:
- 正向传播 是从左到右、时间步逐渐增加的过程。
- 反向传播 则是从右到左,时间步逐渐减小。
因此,反向传播就像是倒退时间,从最后的时间步开始计算梯度,并依次传递到前面每个时间步。
BPTT 的过程
- 正向传播:网络通过每个时间步的输入计算激活值和预测输出。
- 反向传播:从最后一个时间步开始计算误差并传递到前面,最终得到每个参数的梯度。
这种时间上的反向操作使得反向传播算法非常适合于序列数据的学习。
5.实现反向传播的优势
尽管深度学习框架通常会自动实现反向传播,但理解 BPTT 的工作原理有助于我们更好地理解模型的行为和优化过程。
- 梯度计算:BPTT 允许我们通过计算误差的梯度来更新网络中的每个参数,逐步优化模型。
- 时间序列处理:这种方法特别适合处理时间序列数据和序列学习任务,如语言建模、机器翻译等。
总结
在本视频中,我们讨论了 递归神经网络(RNN) 中的反向传播(Backpropagation Through Time, BPTT)。这个过程是正向传播的反向操作,通过计算梯度并更新参数来优化模型。
尽管许多现代深度学习框架会自动处理反向传播的细节,但理解其背后的原理仍然对深入学习和调优模型至关重要。
接下来,我们将扩展介绍更多 RNN 架构,让你能够处理更广泛的应用任务。让我们进入下一期视频吧!🎥