Module 03 · Sequence Models & Attention Mechanism
Error Analysis in Beam Search束搜索的错误分析
在深度学习课程的第三部分,我们讨论了 错误分析 如何帮助你聚焦于对项目最有价值的工作。而在本视频中,我们将深入探讨如何使用错误分析来识别 束搜索(Beam Search) 算法的潜在问题,帮助你决定是应该优化束搜索,还是应该将更多时间投入到改进 RNN 模型 中。
束搜索:近似搜索算法
束搜索是一种 近似搜索算法,也可以被称为 启发式搜索算法,因此它并不总是输出最可能的句子。束搜索只会保持 B=3、10 或 100 个最有可能的候选句子。那么,假如束搜索出现了错误,应该如何判断是束搜索本身出了问题,还是模型的问题呢?下面我们通过一个具体例子来看看如何使用错误分析来识别问题的根源。
错误分析的步骤与实例
假设我们有一个翻译示例:
- 源句子: Jane visite l'Afrique en septembre (法语)
- 人类翻译: Jane visits Africa in September (英文)
我们将这个人类翻译称作 ,它是一个高质量的翻译。
接着,假设我们运行了 束搜索,使用训练好的 RNN 模型 进行翻译,得到的翻译是 ŷ:Jane visited Africa last September,它显然是一个较差的翻译,甚至改变了原句的含义。这个翻译 ŷ 显然不是最优的翻译。
如何通过错误分析定位问题
在进行错误分析时,我们希望能够将错误归因于以下两个可能的来源之一:
- RNN 模型(负责计算 P(y|x))
- 束搜索算法(负责寻找最大化 P(y|x) 的句子)
RNN 模型和束搜索算法的工作原理
- RNN 模型:它是一个 序列到序列模型(Encoder-Decoder),用来计算给定源句子 x 的条件概率 P(y | x)。
- 束搜索:它的任务是从多个候选翻译中选择 最可能的句子,其输出是最大化 P(y | x) 的 ŷ。
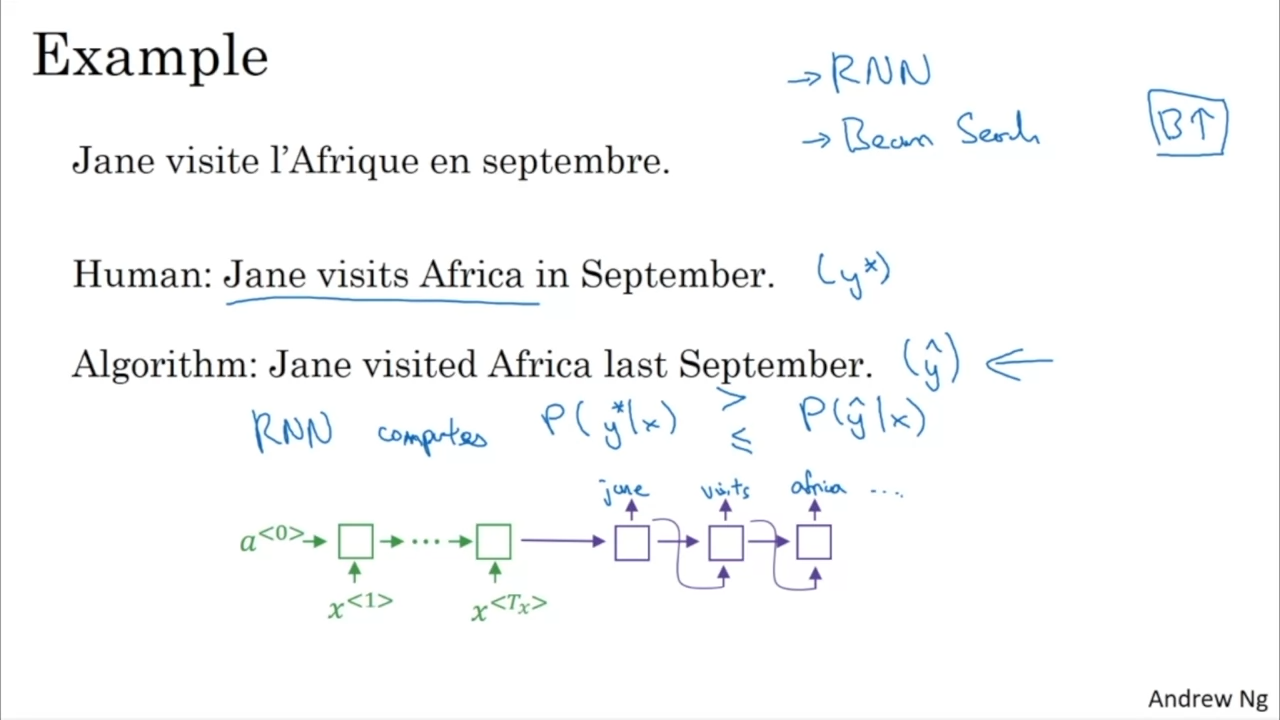
步骤:计算与
- 使用 RNN 模型 分别计算 和 ŷ 的概率。
- 对比 和 ,看看哪个更大。
错误分析的两种情况
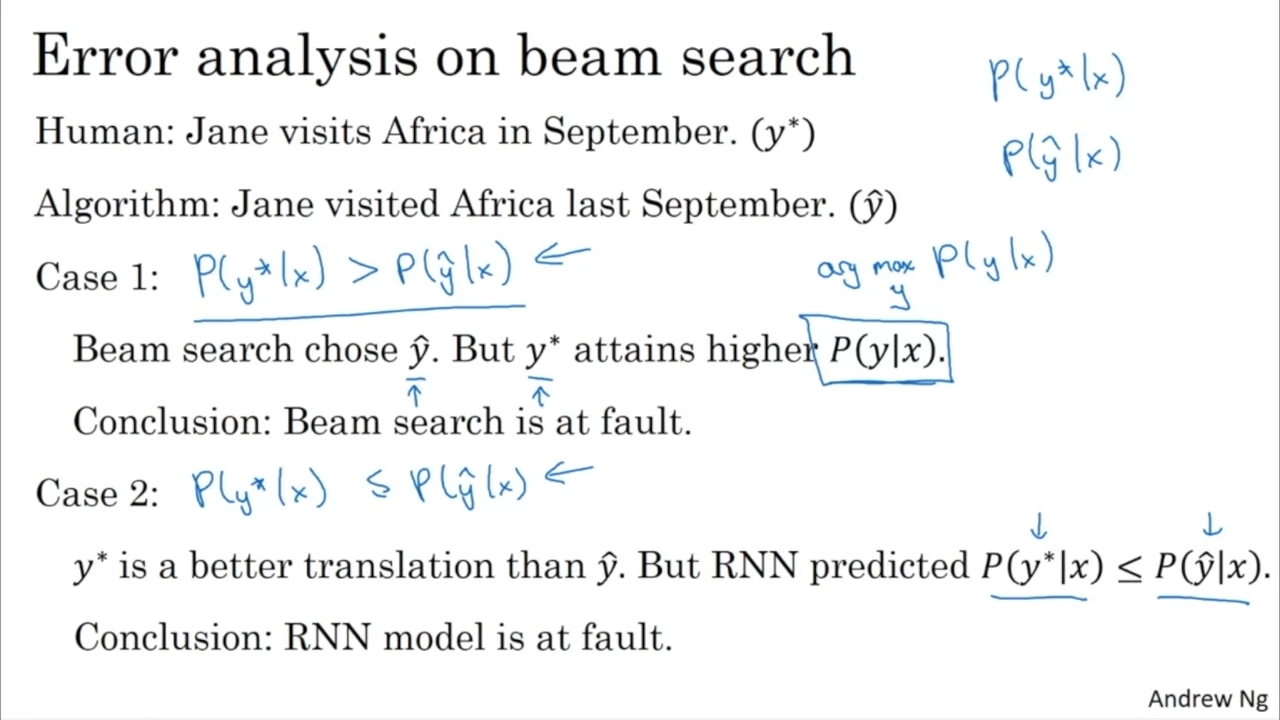
情况 1
如果 y* 的概率大于 ŷ,但束搜索选择了 ŷ,那么可以得出结论:
- 束搜索失败:束搜索应该选择 ,因为 实际上给出了更大的 P(y | x)。然而,束搜索却错误地选择了 ŷ,这表明束搜索没有成功找到最大化 P(y | x) 的句子。
- 结论:这个错误应该归咎于束搜索算法。
情况 2
如果 y* 的概率小于或等于 ŷ,说明 RNN 模型将 的概率评估为较低。
- 模型问题:尽管 是一个更好的翻译,RNN 却给它分配了较低的概率。这表明问题出在 RNN 模型,而不是束搜索。
错误分析的过程
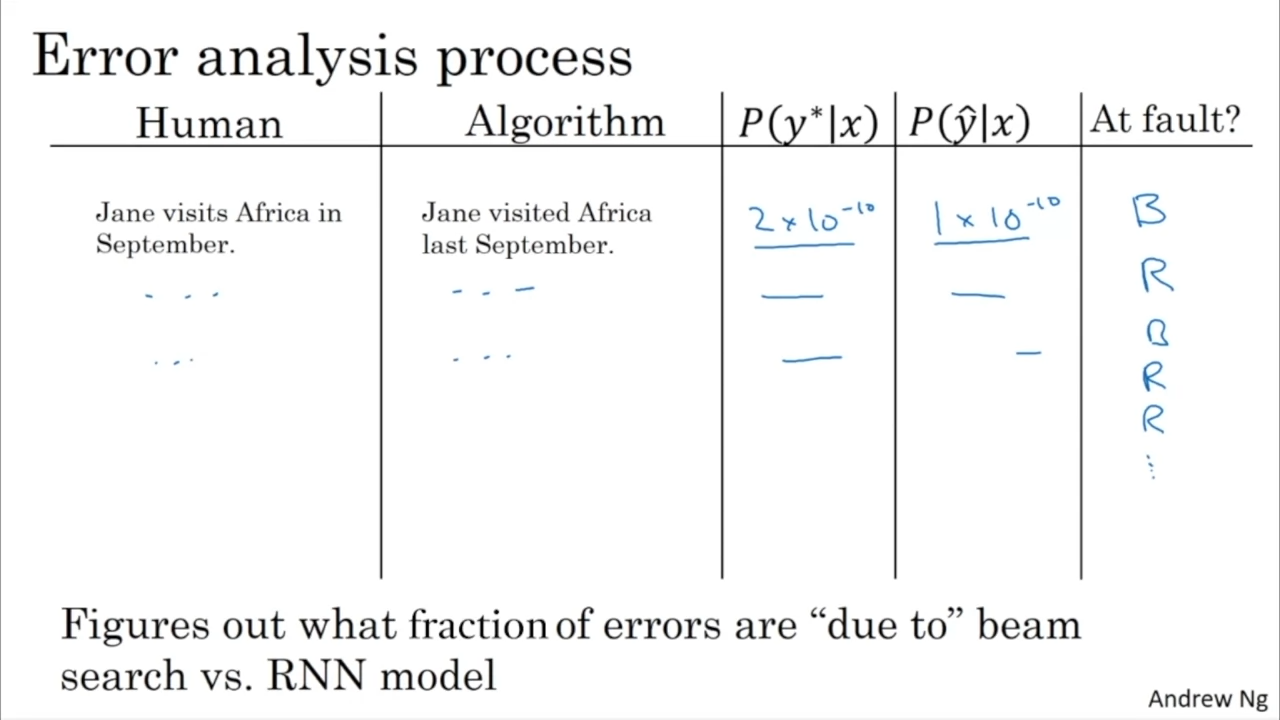
我们通过开发集(dev set)上的错误分析来进一步理解问题来源:
示例 1:束搜索的错误
假设在开发集中, 的概率是 ,ŷ 的概率是 。
- 在这种情况下,束搜索选择了概率较低的 ŷ,因此我们可以得出结论:束搜索出错了。
- 我们将这个错误归为 B,表示束搜索出了问题。
示例 2:RNN 模型的错误
在另一个例子中,假设模型将 的概率计算为 ,而 ŷ 的概率是 。
- 在这种情况下,虽然 是更好的翻译,但 RNN 模型 计算出 的概率比 ŷ 低,因此我们得出结论:RNN 模型出错了。
- 我们将这个错误归为 R,表示是 RNN 模型 出现了问题。
总结:如何进行有效的错误分析
- 分析开发集中的错误:通过对比每个句子的概率,确定是 束搜索 还是 RNN 模型 导致了错误。
- 识别问题来源:通过计算和比较不同翻译的概率,我们可以判断问题源自 束搜索 还是 RNN 模型。
- 确定优化方向:如果发现 束搜索 是问题的根源,可以通过调整 束宽度(Beam Width) 来优化。如果是 RNN 模型 出错,则可以考虑添加正则化、增加训练数据或尝试不同的网络架构。
提升模型性能的关键
- 通过系统的错误分析,你能够找出束搜索与 RNN 模型 在翻译过程中的优缺点,从而决定如何针对性地进行优化。
- 如果发现束搜索的表现欠佳,增加 束宽度 可能有助于提升翻译质量。然而,如果是模型本身的问题,则可能需要从 训练数据 或 模型结构 入手进行优化。
错误分析的应用场景
- 错误分析不仅对于 束搜索 适用,对于其他 近似优化算法(例如,在 序列到序列 模型中的成本函数优化)同样有效。通过这种分析方法,你可以提高算法的 鲁棒性 和 翻译质量。
通过这种方法,你可以更加高效地优化模型,提升其在实际应用中的表现。希望这个错误分析过程能够帮助你在 机器翻译 或其他 深度学习应用 中取得更好的结果。