Module 02 · Natural Language Processing & Word Embeddings
Debiasing Word Embeddings词嵌入去偏
随着机器学习和人工智能算法在社会中发挥越来越重要的作用,它们被广泛应用于做出一些非常关键的决策。因此,我们需要确保这些算法尽可能不受不良偏见的影响,例如性别偏见、种族偏见等。在这段视频中,我将展示一些减少或消除词向量中偏见的思路。
什么是偏见?
在这个视频中,当我提到偏见时,指的是性别偏见、种族偏见、性取向偏见等,而不是通常在机器学习技术讨论中所提到的偏差-方差(bias-variance)中的偏差——这种偏见反映了某些社会观念在数据中的体现。
词向量中的偏见问题
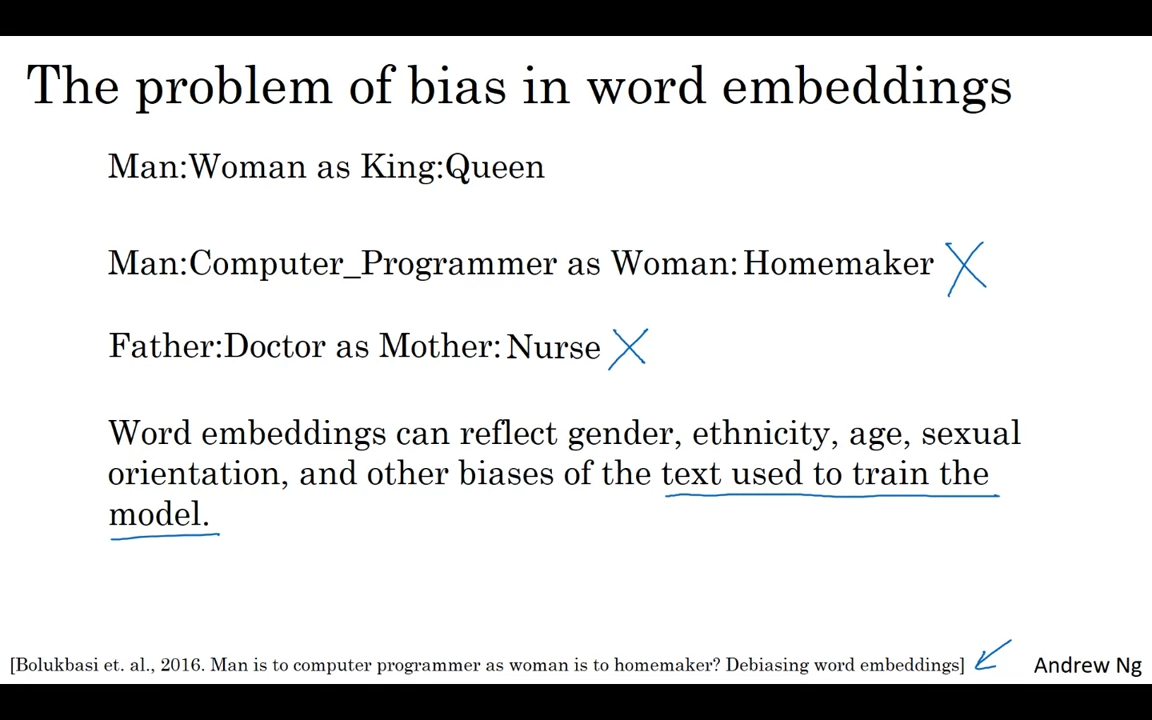
我们已经讨论过,词向量能够学习类比关系,例如:man is to woman as king is to queen。但如果我们问:“man is to computer programmer as woman is to what?”,结果可能让人震惊。研究者 Tolga Bolukbasi, Kai-Wei Chang, James Zou, Venkatesh Saligrama 和 Adam Kalai 发现,某些训练好的词向量可能会输出 man:computer_programmer as woman:homemaker。这显然是错误的,并强化了有害的性别刻板印象。
理想的输出应该是 man is to computer programmer as woman is to computer programmer。此外,类似的偏见还体现在父亲与母亲的职业上,例如:father:doctor as mother:nurse。这种结果表明,词向量能够反映出数据中的性别、种族、年龄、性取向等偏见。
社会经济地位偏见
我个人特别关心的是与社会经济地位相关的偏见。我认为,不论一个人来自富裕家庭、低收入家庭,还是介于两者之间的任何地方,每个人都应该有平等的机会。因为机器学习算法被用来做出至关重要的决策,例如大学招生、求职、贷款申请、甚至刑事司法中的判刑标准。这些算法正在影响我们的生活,因此,尽量减少或消除这些不良偏见非常重要。
如何减少词向量中的偏见?
以下是通过 Bolukbasi 等人提出的一些方法来减少词向量中的偏见。
步骤一:识别偏见方向
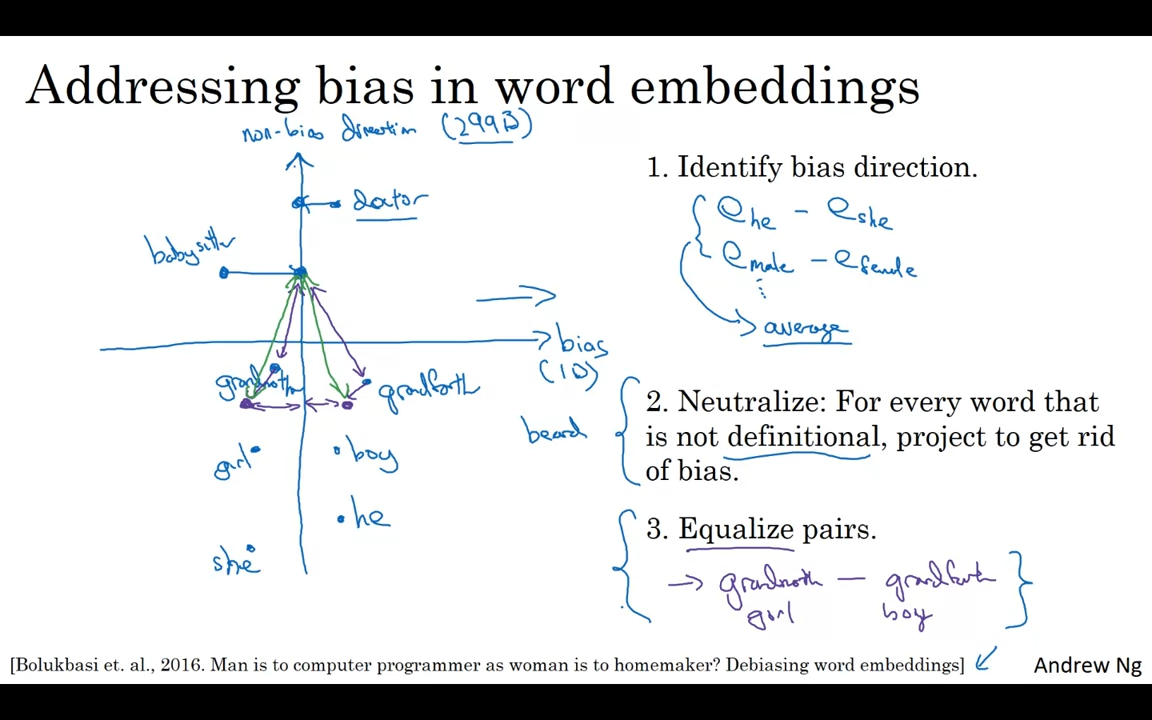
假设我们已经训练了一个词向量模型,其中包含了如 babysitter、doctor、grandmother、grandfather、girl、boy 等词。我们希望减少或消除性别偏见。第一步是识别与偏见相关的方向。
如何识别偏见方向?
在性别偏见的案例中,我们可以通过计算 he 和 she 的词向量差异来找出偏见方向。具体步骤如下:
- 取 he 和 she 的词向量,并计算它们之间的差异。
- 计算 male 和 female 词向量的差异。
- 通过平均这些差异向量,得到一个代表性别偏见的方向。
这样,我们就能识别出与性别偏见相关的方向。这个方向将是 1维的子空间,而与偏见无关的方向则构成 299维的子空间。
步骤二:中立化(Neutralization)步骤
对于那些不是定义性词汇(即不固有包含性别、种族等属性的词汇),我们需要通过中立化步骤消除偏见。定义性词汇,如 grandmother(祖母)和 grandfather(祖父),本身就包含性别信息,因此不需要中立化。对于其他词汇,比如 doctor(医生)和 babysitter(保姆),我们希望将它们中立化,消除它们在性别偏见方向上的分量。
如何进行中立化?
通过将词向量投影到 非偏见方向,我们可以消除或减少词汇在偏见方向上的分量。例如,将 doctor 和 babysitter 的词向量投影到去除性别偏见的方向上,从而使这些词更加中立。
步骤三:平等化(Equalization)步骤
接下来是平等化步骤。对于一些具有性别差异的词对,例如 grandmother 和 grandfather,girl 和 boy,我们希望它们之间的唯一区别是性别。因此,我们希望在训练后的词向量中,grandmother 和 grandfather 与 doctor 或 babysitter 的距离相同。
为什么要进行平等化?
假设 babysitter 和 grandmother 之间的距离小于 babysitter 和 grandfather 之间的距离,这可能会强化一个不健康的偏见:即 grandmothers 更可能担任保姆,而 grandfathers 更少担任这一角色。通过平等化,我们可以确保 grandmother 和 grandfather 与 doctor 或 babysitter 的距离相等,从而消除性别偏见。
如何选择需要中立化的词汇?
并非所有词汇都需要中立化。比如,doctor 是一个非定义性词汇,应该中立化。而像 grandmother 和 grandfather 这样的词汇,由于它们本身就带有性别特征,不应该被中立化。
另外,像 beard 这样的词,由于男性比女性更有可能拥有胡子,因此 beard 更接近男性而非女性,这样的词汇也无需中立化。
算法实现与应用
研究者们使用了 分类器 来识别哪些词汇是定义性词汇、哪些应该进行性别中立化。大部分英语单词不是定义性的,只有像 grandmother、girl、boy 这样的词才需要保持性别特征。
总结
减少或消除学习算法中的偏见是一个非常重要的问题,因为这些算法正在做出越来越多影响社会的重要决策。在本视频中,我分享了一些减少词向量中性别偏见的想法,这些方法也可以扩展到其他偏见类型。虽然这个领域的研究还在进行,但我们已经有了一些有效的策略来减少 AI 中的偏见。
编程练习与后续探索
在编程练习中,你将有机会应用这些想法,进一步探索如何减少词向量中的偏见。希望这段内容能启发你更深入地理解并参与到这一重要研究领域中。
感谢大家观看本周的视频,祝大家编程顺利,期待下周与大家的分享!🌟