Module 03 · Sequence Models & Attention Mechanism
Attention Model注意力模型
在上一视频中,我们了解了Attention模型如何让神经网络在生成翻译时,只关注输入句子的一部分,这种方式与人类翻译者的工作方式类似。接下来,我们将详细阐述如何将这个直觉转化为可实现的Attention模型细节。
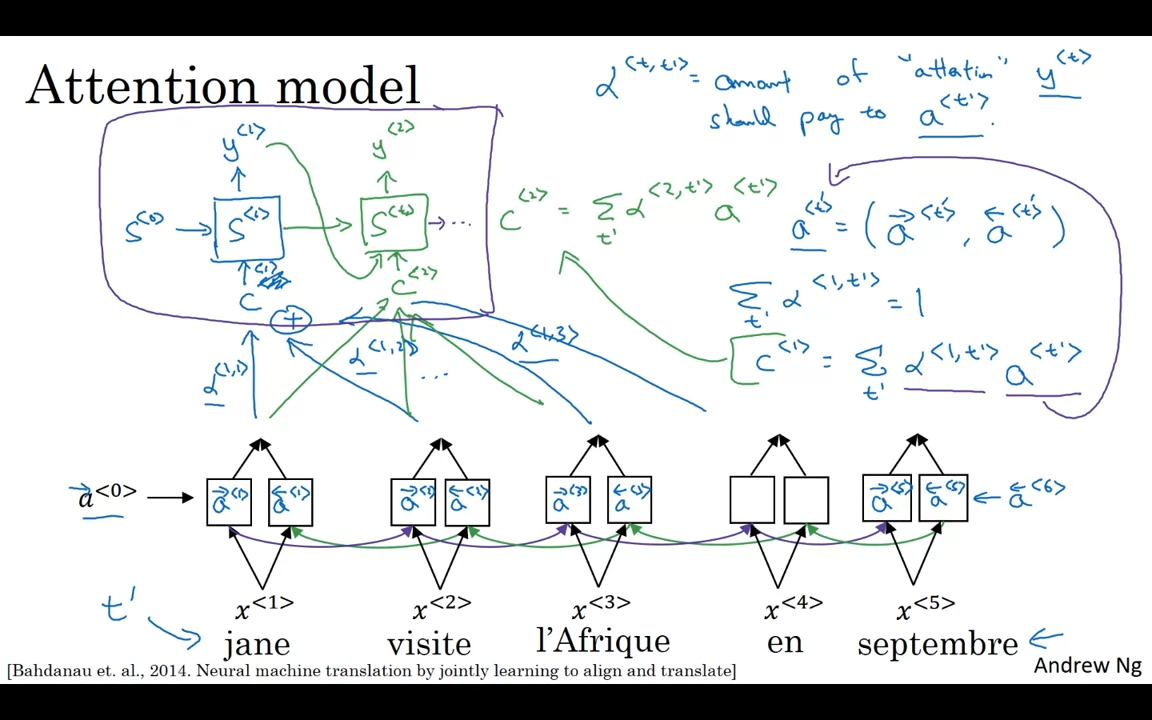
回顾:Bidirectional RNN的应用
如同之前的介绍,我们假设有一个输入句子,使用双向RNN(Bidirectional RNN)、双向GRU或双向LSTM来计算每个单词的特征。在实践中,GRU和LSTM更常被使用,尤其是LSTM。
- 对于正向序列(Forward Sequence),你会在每个时间步生成激活值。
- 同理,对于反向序列(Backward Sequence),也会有类似的操作。
在简化符号后,每个时间步的特征将会被表示为 a(t),其中 t 表示时间步的索引,而 a(t) 是该时间步的特征向量。
构建解码器:生成翻译
接下来,我们定义一个正向RNN来生成翻译。假设我们生成第一个单词 y₁,这时解码器将依赖某个上下文 C₁ 来帮助生成。
- Attention权重(α₁₁, α₁₂等)决定了该时间步生成翻译时,输入句子中哪些部分对输出单词的重要性。
具体过程:
- 生成第一个单词:
使用 C₁ 作为输入生成第一个英文单词,并计算相关的Attention权重。 - 生成第二个单词:
重复这个过程,通过新的Attention权重生成下一个单词 y₂,并更新上下文 C₂。
关键公式:
- 上下文计算:
上下文 C₁ 是通过对所有时间步的激活值进行加权求和得到的:
其中 α(t', t) 是在生成第 t 个单词时,注意力应该集中在哪些时间步的输入特征。
Attention权重的计算
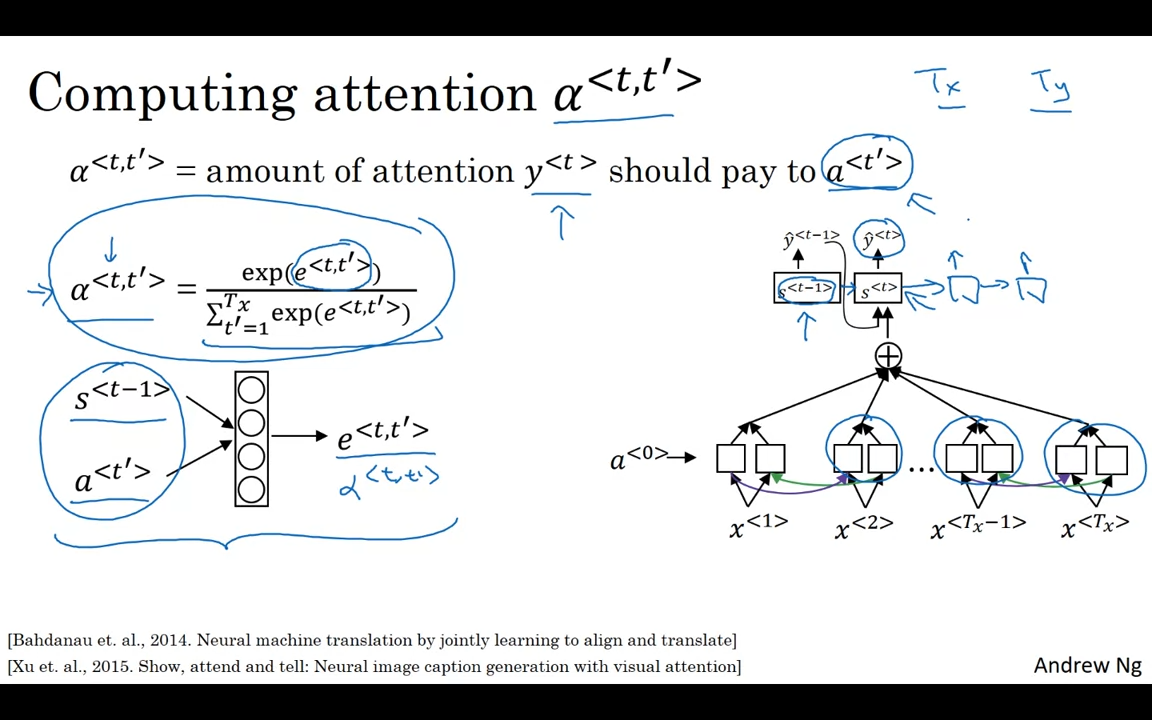
注意力权重的计算是实现Attention模型的核心。我们需要计算 α(t, t'),表示在生成第 t 个输出单词时,应该关注输入句子中的哪个部分。
计算公式
- 计算 e(t, t'):
为了计算 α(t, t'),我们需要首先计算每个时间步的相关性得分 e(t, t')。 - Softmax 归一化:
为确保所有权重的总和为1,我们使用Softmax来进行归一化处理:
这样做确保了 α(t, t') 的值总和为1。
如何计算相关性得分
计算 e(t, t') 的方式通常是使用一个小型神经网络来完成。这个神经网络的输入包括:
- st-1:上一个时间步的隐藏状态。
- a(t'):输入句子中第 t' 个单词的特征。
神经网络的工作原理:
- 隐藏状态:当前输出的生成依赖于上一步的隐藏状态(st-1)。
- 输入特征:每个单词的输入特征(a(t'))决定了与当前输出的相关性。
通过训练神经网络,我们可以学习出如何根据上一步的状态和当前单词的特征来计算 e(t, t'),进而得到 α(t, t')。
训练与优化
使用**反向传播(Backpropagation)和梯度下降(Gradient Descent)**方法,模型可以自动调整参数,使得Attention机制在生成翻译时能够正确地关注输入句子的相关部分。
尽管这一过程需要训练,但训练完成后,模型能够在翻译时自动学习应该关注哪些输入部分。
时间复杂度与限制
这个模型的一个主要缺点是计算复杂度较高,因为对于每一对输入和输出单词,都需要计算 Attention 权重:
- 时间复杂度:对于 tx 个输入单词和 ty 个输出单词,Attention参数的总数为 tx × ty,因此算法的运行成本是 O(tx * ty),即二次时间复杂度。
尽管如此,在机器翻译中,输入和输出句子的长度通常不会过长,所以这种复杂度通常是可以接受的。
Attention模型的应用
虽然我们在这次讨论中主要讲解了机器翻译,但Attention模型也已被广泛应用于其他领域。例如,在图像字幕生成(Image Captioning)中,系统可以查看图片并在生成描述时,逐步关注图片的不同部分。
参考论文:Kelvin Xu等人提出的论文,展示了如何将Attention模型应用于图像描述生成。您可以进一步阅读这篇论文以获得更多灵感。
编程练习与实践
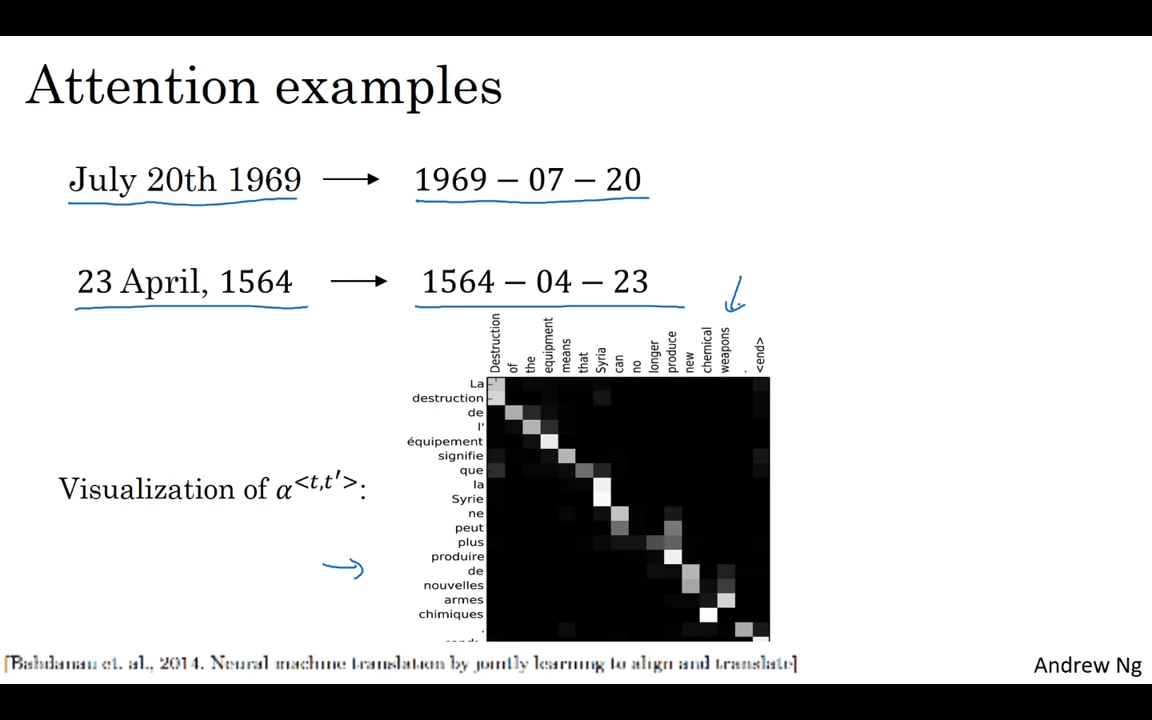
在本周的编程练习中,您将有机会实现和实践Attention模型。除了机器翻译问题,您还将应用Attention模型解决日期格式标准化问题。具体任务是将输入的日期格式(例如阿波罗登月日期或莎士比亚的生日)标准化为统一格式。
可视化 Attention 权重
在机器翻译中,我们也可以通过可视化Attention权重,观察神经网络在生成翻译时对输入句子各部分的关注程度。例如:
- 对应的输入和输出单词之间的Attention权重通常较高,这表明在生成某个特定输出单词时,模型确实关注了输入句子中相关的部分。
总结
Attention模型是深度学习中最具影响力的想法之一,它使得神经网络能够智能地聚焦于输入数据的关键部分,从而提高了机器翻译和其他任务的性能。
关键要点回顾
- Attention权重决定了在生成翻译时,模型应该关注输入句子中的哪些部分。
- 通过计算 e(t, t') 并使用 Softmax 归一化,确保所有Attention权重的和为1。
- 通过反向传播和梯度下降,模型能够自动调整Attention机制,学习到正确的关注点。
希望您在实践中能够享受实现并探索这些想法,进一步提升您的深度学习技能!