Module 04 · Transformer Network
Self-Attention自注意力
今天,我们将深入讨论 Transformer 网络中的自注意力机制。如果你能理解这个视频中的核心思想,你将掌握 Transformer 网络 运作的最重要概念。
自注意力的基本概念
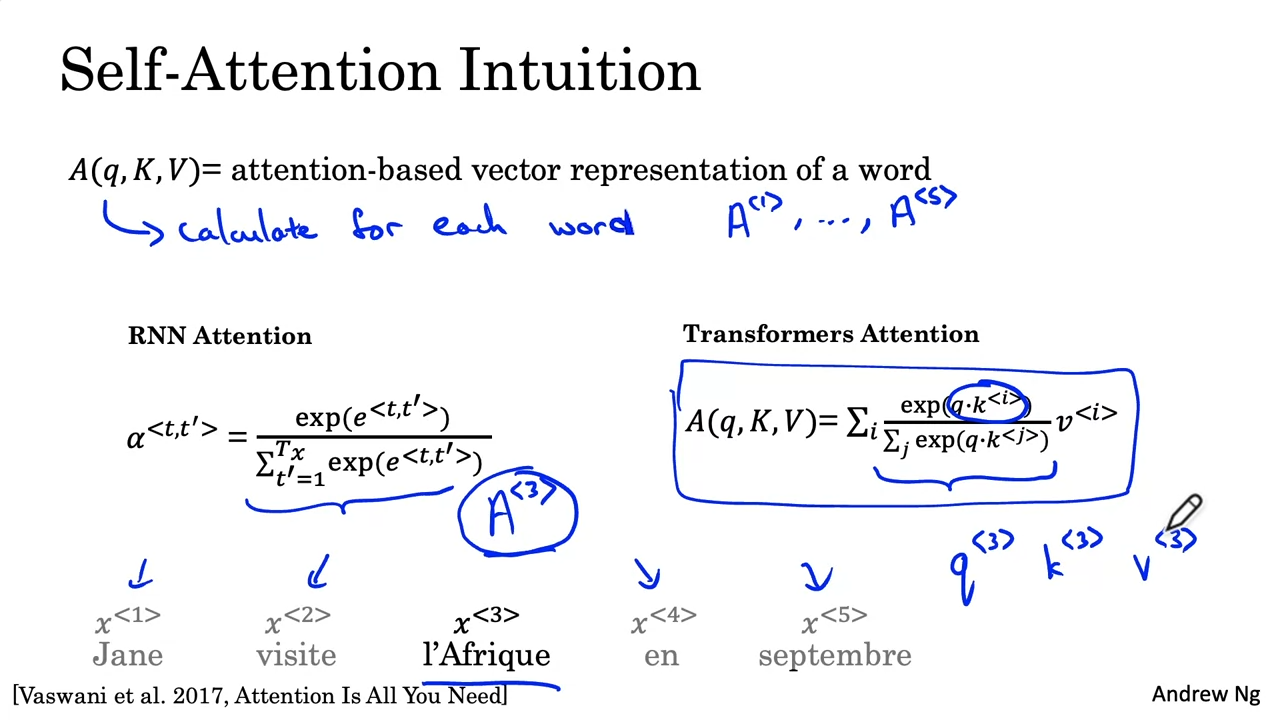
你已经看到过注意力(Attention)是如何与 循环神经网络(RNN) 一起使用的。而在 卷积神经网络(CNN) 的风格下使用注意力机制时,你需要计算 自注意力,在输入句子的每个词上创建基于注意力的表示。
我们以句子 “Jane visite l'Afrique en septembre” 作为例子,目标是为句子中的每个词计算一个基于注意力的表示。由于句子中有五个词,我们最终会得到五个表示,即 A1, A2, A3, A4, A5。
在这个过程中,你会看到一些符号,如 Q, K, 和 V。我们将在稍后的幻灯片中解释这些符号的意义,因此你暂时不必担心它们。
深入理解自注意力的计算过程
为了演示自注意力的计算,我们将以词 l'Afrique 为例,逐步分析如何计算其对应的表示 A3。同时,我们会用到之前提到的注意力机制。
自注意力的直觉
在之前,我们已经学习了 词嵌入(Word Embedding)。一种表示 l'Afrique 的方式是直接查找其对应的词嵌入。然而,根据上下文的不同,l'Afrique 可能有不同的意义,比如作为 历史遗址的非洲,还是作为 假期目的地的非洲,或是 世界第二大洲。
因此,基于上下文的不同,我们需要一个 动态的表示,这正是 自注意力机制 所要实现的。它会根据上下文的不同,计算出最合适的表示。
自注意力的计算步骤
接下来,我们将详细计算如何从词 l'Afrique 到其自注意力表示 A3。
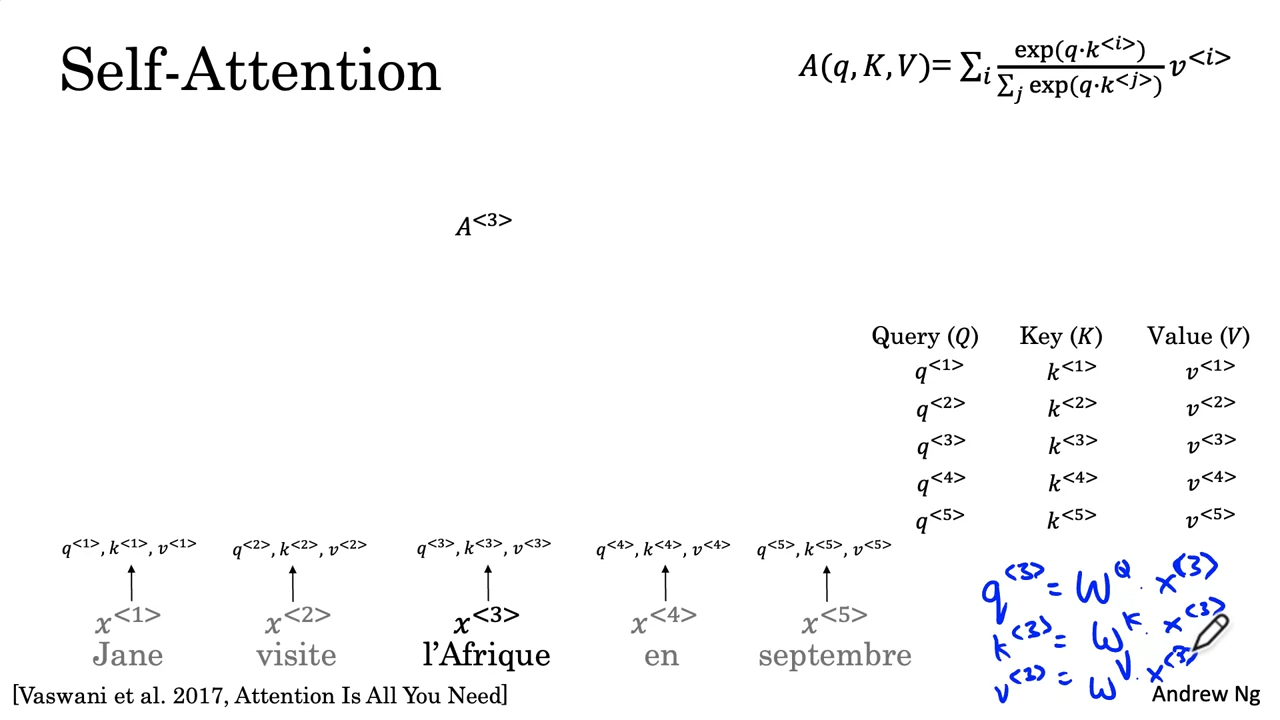
- 步骤 1:为每个词分配查询(Q)、键(K)和值(V)
对于每个词,我们将分配 查询(Query)、键(Key) 和 值(Value)。
假设 X3 是 l'Afrique 的词嵌入,则 查询 Q3 的计算方式为:
同理,键 K3 和 值 V3 也通过类似的矩阵运算来计算:
其中,WQ, WK, WV 是学习的参数矩阵,用于提取每个词的 查询、键和值 向量。
计算注意力值的过程
- 步骤 2:计算内积并得到注意力值
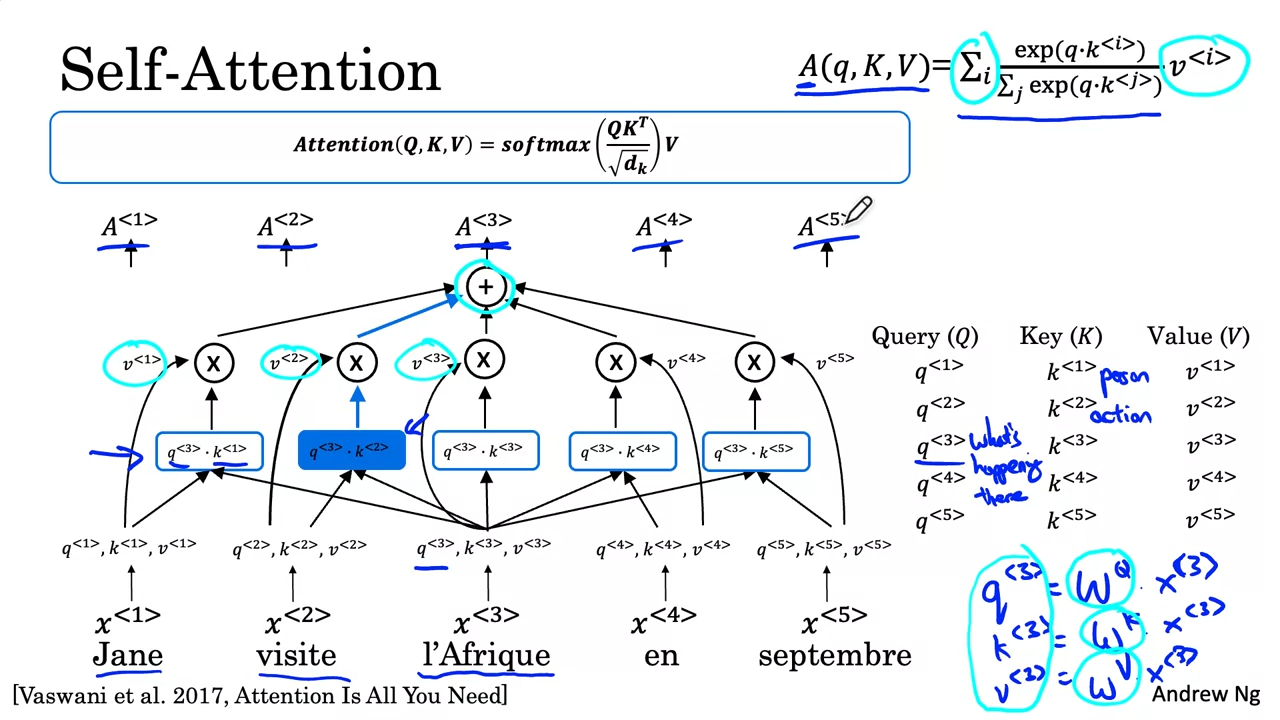
接下来,我们计算 查询 Q3 与其他词的 键 K1、K2、K3 等的内积,从而判断每个词与当前词的相关性。- 例如,计算 ,其结果表明 l'Afrique 与 Jane 的相关性如何。
- 然后,计算 ,判断 l'Afrique 与 visite 的相关性,以此类推。
- 步骤 3:计算 softmax
对所有内积值进行 softmax 运算,得到每个值的权重。最终,这些权重用于调整每个 值 V1、V2 对最终表示的贡献。 - 步骤 4:加权求和得到最终表示
将所有加权后的 值(例如 V1, V2, V3 等)相加,得到最终的自注意力表示 A3。
自注意力机制的直觉解释
- 查询(Query):是你想要对当前词(如 l'Afrique)提问的问题。比如:“在非洲发生了什么?”
- 键(Key):是句子中其他词的 特征,用于判断它们是否能为当前的查询提供有用的信息。
- 值(Value):是每个词的 表示,最终用来回答查询问题。
例如,在我们的例子中:
- Jane 的键可能表示 “人”,而 visite 的键则表示 “动作”。
- 如果 l'Afrique 的查询与 visite 的键最相关,那么 visite 就是回答 “在非洲发生了什么” 的最佳词。
总结:自注意力机制的优势
自注意力的关键优势在于,词 l'Afrique 的表示不是一个固定的词嵌入,而是根据上下文动态计算出来的。例如,l'Afrique 作为一个旅游目的地的表示与其作为历史遗址的表示是不同的。通过自注意力机制,我们能够为每个词计算出更为丰富的 上下文相关表示。
下一步:多头注意力机制
到目前为止,我们已经了解了 自注意力机制。接下来,我们将进一步探讨 多头注意力机制(Multi-Head Attention),它通过多个并行的自注意力计算来增强模型的表达能力。
让我们在下一个视频中深入学习多头注意力机制!