Module 04 · Transformer Network
Multi-Head Attention多头注意力
今天,我们将深入探讨 多头注意力机制。这个机制的符号可能有些复杂,但我们要记住的核心思想就是:它实际上是对 自注意力机制 的多次重复运算。
多头注意力机制:基本概念
- 每当你为一个序列计算 自注意力 时,这个过程叫做 一个头(head)。
- 多头注意力(Multi-Head Attention) 机制意味着将 自注意力机制 反复执行多次,每次得到一个新的“头”,然后将这些头的输出合并。
简单来说,多头注意力 就是对 自注意力机制 进行多次并行计算,得到多个不同的表示,然后将它们拼接在一起,形成一个更丰富的表示。
多头注意力的运算过程
- 输入向量:Q、K 和 V
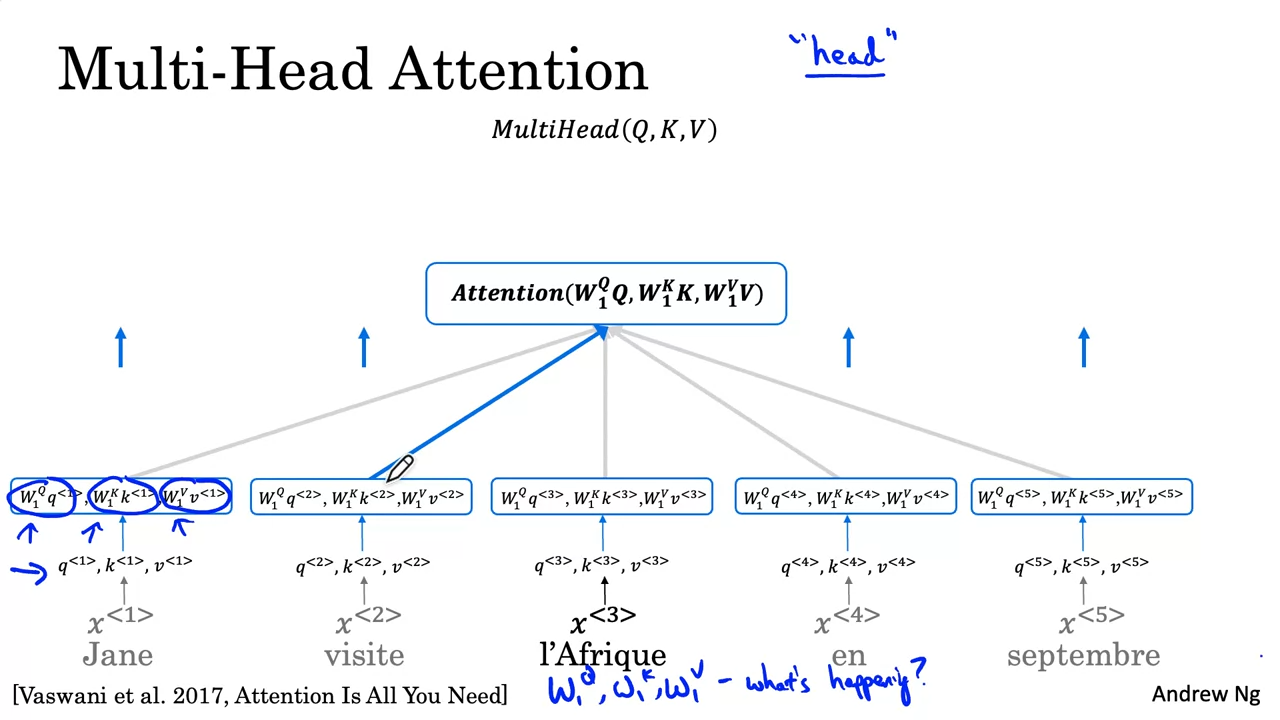
与 自注意力机制 中一样,Q(查询)、K(键)、V(值)向量是通过与学习矩阵 W_Q, W_K, W_V 相乘得到的。 - 计算自注意力
对每个词,我们都通过 Q、K、V 计算自注意力表示。
每个头的计算过程与我们在上一期视频中所讲的自注意力完全相同,只不过每次使用的矩阵不同。
计算每个头的自注意力
假设我们有一个包含五个单词的句子:“Jane visite l'Afrique en septembre”。我们将逐步计算每个词的表示。
- 第一个头(Head 1)
- 我们为每个词分别计算查询、键和值。
- 假设 Visite 是最能回答“发生了什么?”这个问题的词,因此在该头下,Visite 会对表示 l'Afrique 的自注意力有最大贡献。
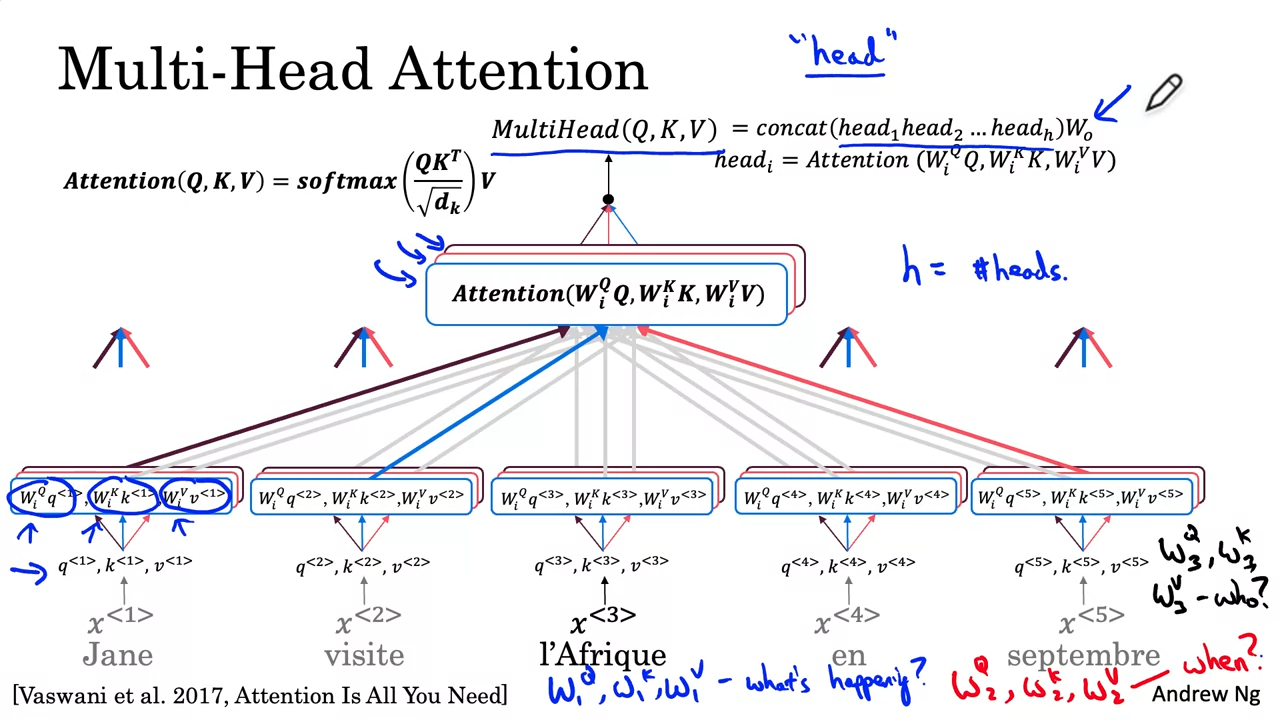
对于每个头,我们都按照类似的方式计算并得到相应的表示。第一头的计算将得到一组表示(例如,A_1, A_2, A_3, A_4, A_5),这些表示反映了每个词的不同维度。
- 第二个头(Head 2)
- 第二个头使用新的 Q、K、V 矩阵,可能会问不同的问题。例如,“什么时候发生的?”
- 这次计算将会让 “Septembre”(九月)在表示 l'Afrique 时占据更大的权重。
- 第三个头(Head 3)
- 第三个头可能会问:“谁与非洲有关?”
- 结果可能是 “Jane” 对 l'Afrique 的表示贡献最大。
多头并行计算与拼接
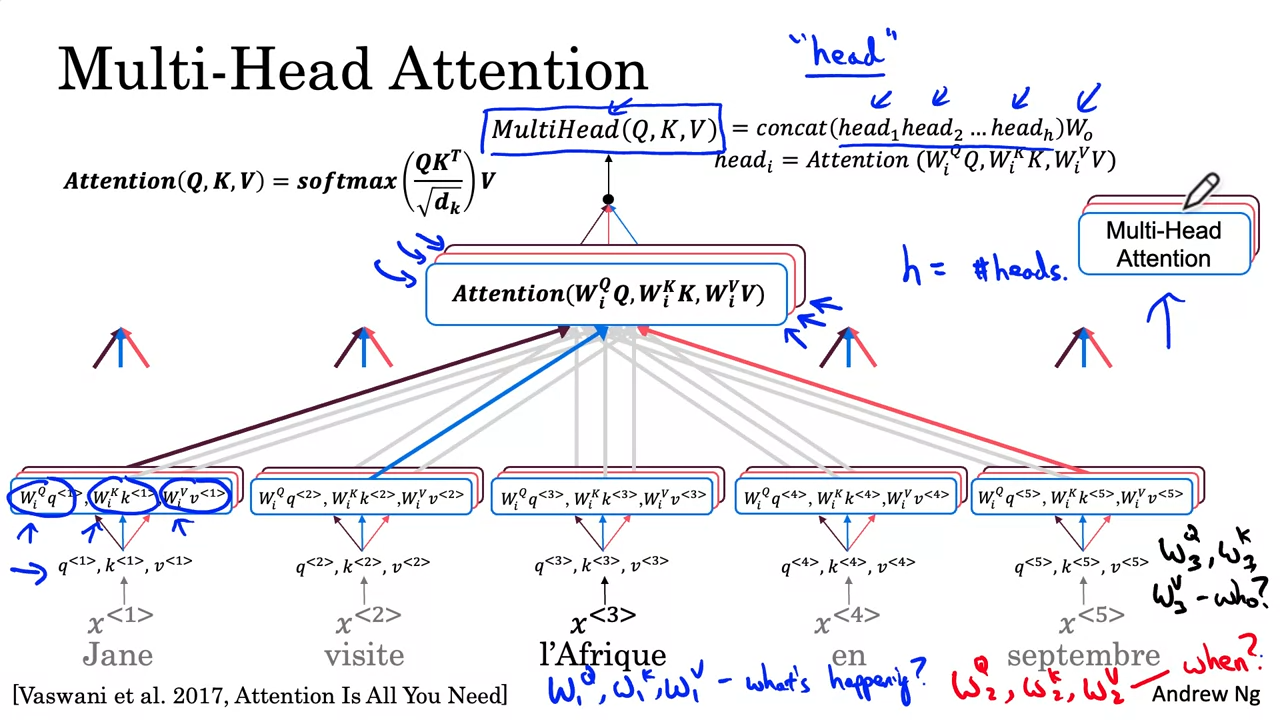
当我们计算完所有的头之后,得到的 H 个表示将会被拼接在一起,形成一个更为丰富的表示。接着,我们将这个拼接后的表示乘以一个权重矩阵 W_0,得到最终的 多头注意力 输出。
| 头数 H | 计算方式 |
|---|---|
| H = 1 | 使用单一的 Q、K、V 计算一个头 |
| H > 1 | 重复上述过程,使用多个不同的矩阵计算多个头 |
| 最终输出 | 拼接所有头的输出并乘以 W_0 |
并行计算与效率
尽管我们将计算过程描述成多个头按顺序执行,但在实际操作中,可以通过 并行计算 来加速这个过程。由于每个头的计算是相互独立的,我们可以同时计算所有的头,而不是顺序执行。
这使得 多头注意力机制 既能处理多维度的信息,又能保持高效的计算。
总结:多头注意力的优势
- 多样化的问题:每个头可以提出不同的问题,如“发生了什么”、“什么时候发生”、“谁与此有关”等,从而获取更多的信息。
- 丰富的表示:通过多个头的计算,我们可以为每个词学习到更丰富、更细致的表示。
- 并行计算:多个头的计算可以并行进行,提高了模型的效率。
下一步:构建Transformer网络
到此,你已经掌握了 自注意力机制 和 多头注意力机制 的核心概念。下一步,我们将把这些知识结合起来,构建完整的 Transformer 网络。
在下一个视频中,我们将看到如何将这些机制整合,构建出一个强大的模型。