Module 02 · Natural Language Processing & Word Embeddings
Word Representation词汇表示
欢迎回来!上周我们学习了 RNN、GRU 和 LSTM 等模型,本周,我们将探讨这些概念如何应用于 自然语言处理(NLP),这是人工智能中的一个重要领域,正在被深度学习技术彻底革新。我们将重点学习 词向量(Word Embeddings),它是一种表示单词的方式。词向量的一个重要特点是,它能使算法自动理解类似 “男人” 和 “女人” 之间的关系,就像 “国王” 和 “女王” 之间的关系一样。通过使用这些词向量的概念,您将能够构建强大的 NLP 应用,即便是使用相对较小的标签训练集。最后,在本周的结束部分,您还将学习如何去除词向量中的 偏见,例如减少性别、种族或其他类型的偏见,这些偏见有时会在学习过程中被算法所吸收。
词表示的介绍
传统的单词表示法:一热向量(One-Hot Encoding)
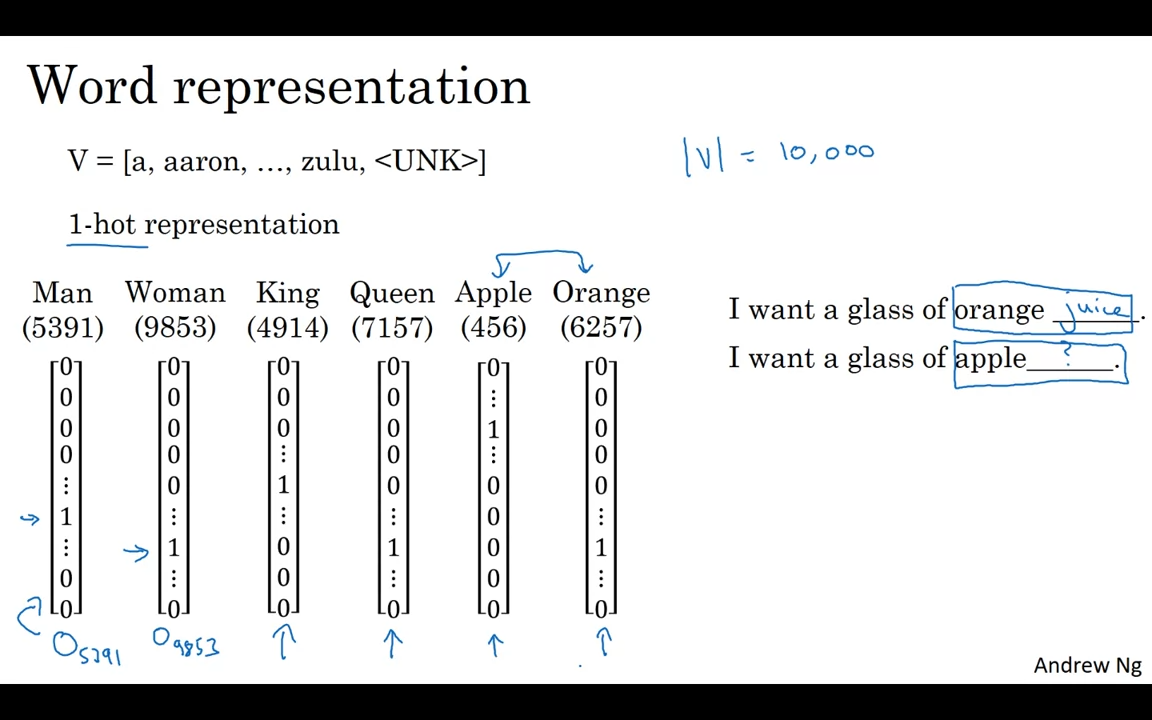
到目前为止,我们一直使用 词汇表(Vocabulary) 来表示单词,例如上一周的词汇表可能包含 10,000个单词。这些单词通过 一热向量(One-Hot Encoding) 来表示。例如:
- 假设“man”是词汇表中的第 5391 个词,那么它将被表示为一个向量,其中 5391 位置为 1,其他位置为 0,即:
- 类似地,如果“woman”是词汇表中的第 9853 个词,它的表示是:
这种 一热向量 的表示方式简单,但存在一些明显的缺点。
一热向量的缺点与局限性
一热向量 的主要缺点是,它将每个单词视为独立的个体,无法为算法提供单词之间的语义联系。例如,如果我们有一个语言模型,学习到 "I want a glass of orange ___" 这样的句子,那么预测下一个词最可能是 “juice”。但是,如果算法看到 "I want a glass of apple ___",由于 “apple” 和 “orange” 在一热表示中没有任何关联,算法很难推断出 “apple juice” 也是一个常见短语。这是因为任何两个不同的一热向量的点积为 0,例如:
- “queen” 和 “king” 的点积为 0。
- “apple” 和 “orange” 的点积也是 0。
这意味着算法无法理解像 “apple” 和 “orange” 之间的关系,比 “king” 和 “orange” 或 “queen” 和 “orange” 更加接近。
引入词向量表示:特征化表示
通过特征化来表示单词
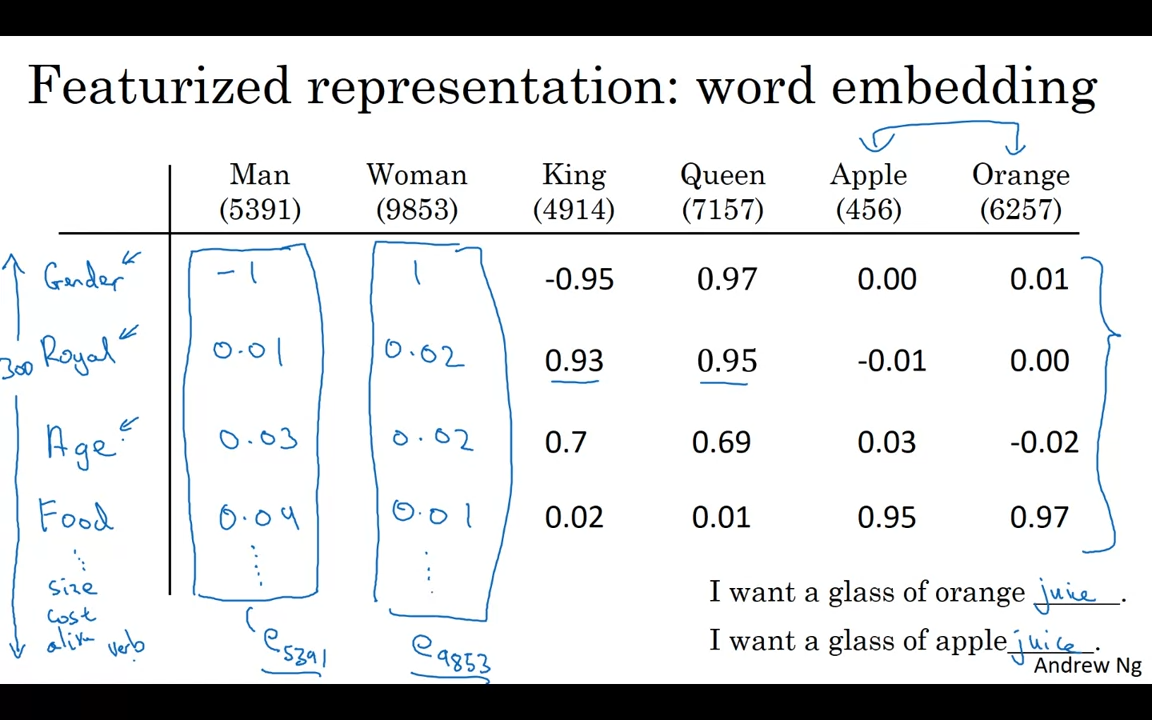
为了克服 一热向量 的问题,我们希望通过 特征化表示 来表示每个单词。例如:
- 我们为每个单词学习一组特征和对应的数值。每个特征可以代表一个不同的属性,例如性别、年龄、是否是食物等。
性别特征
- “man” 可能表示为 -1(男性),“woman” 可能表示为 +1(女性)。
- “king” 可能表示为 -0.95,“queen” 为 +0.97,而 “apple” 和 “orange” 可能没有性别特征。
皇家特征
- “king” 和 “queen” 会有较高的皇家特征值。
- “apple” 和 “orange” 则接近于零,因为它们没有皇家特征。
年龄特征
- “man” 和 “woman” 可能表示为接近 0(没有特定年龄)。
- “king” 和 “queen” 由于通常代表成年人,可能会有较高的年龄特征。
是否为食物特征
- “apple” 和 “orange” 被视为食物,因此它们会有较高的食物特征值。
- “man”、“woman”、“king” 和 “queen” 不是食物,因此它们的食物特征值接近于零。
多维特征表示:300维向量
通过这种方式,我们为每个单词学习 300个不同的特征,然后将这些特征组合成一个 300维的向量 来表示每个单词。例如:
- “man” 可能被表示为:
- “woman” 也将有类似的表示,但会有不同的特征值。
通过这种表示,“apple” 和 “orange” 的向量将变得更加相似,因为它们在许多特征上具有相似的值。
学习词向量:如何通过特征化提高泛化能力
这种 特征化表示 能帮助学习算法更好地理解不同单词之间的关系。例如,当模型学到 “orange juice” 是一个常见短语时,它也能很容易地推测 “apple juice” 也是一个常见的短语。这是因为 “apple” 和 “orange” 的词向量在高维空间中较为接近,从而增加了算法的 泛化能力。
词向量的可视化:t-SNE 降维方法
一旦我们得到了每个单词的 高维特征向量(例如 300 维),我们通常会使用降维技术将这些向量映射到 2维空间,以便可视化。例如,常用的降维算法是 t-SNE(由 Laurens van der Maaten 和 Geoff Hinton 提出)。通过 t-SNE,我们可以将这些高维数据压缩到二维空间,并生成可视化图表。
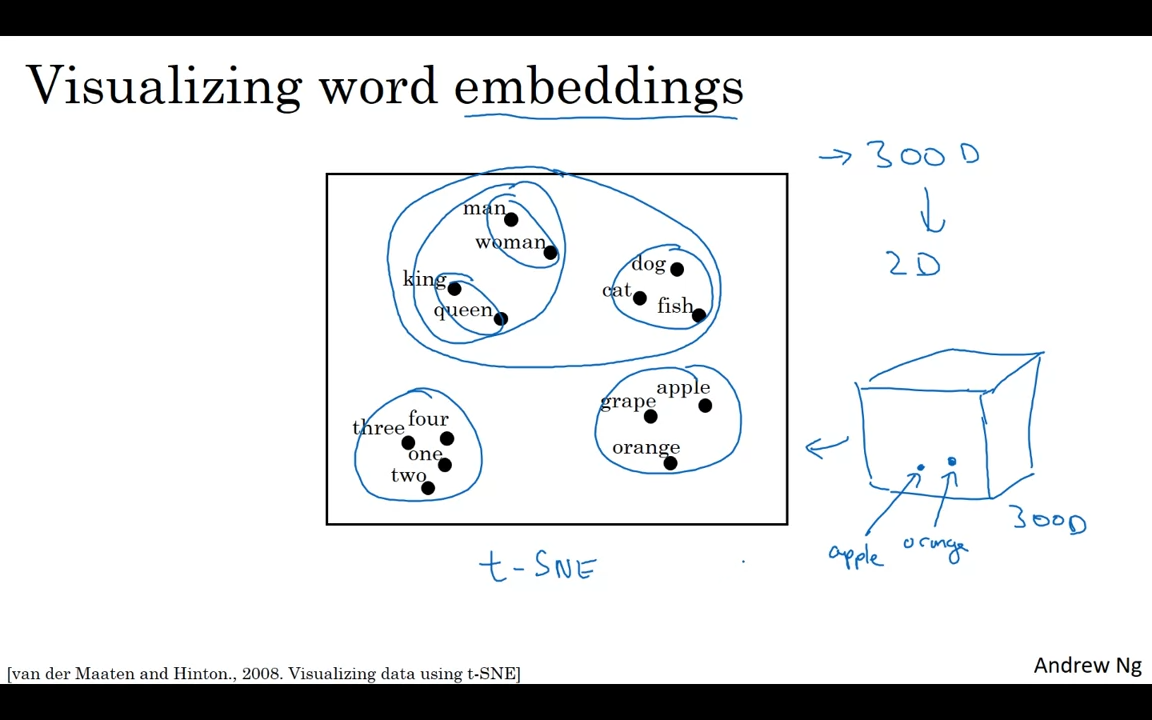
在这些图表中,我们会看到类似的单词(例如 “man” 和 “woman”,“king” 和 “queen”)会被聚集在一起,水果 类的单词也会靠近。通过这种方式,我们能够直观地看到单词之间的相似性和关系。
总结:词向量的重要性
词向量(Word Embeddings) 是 自然语言处理(NLP) 中的核心概念之一。在这节课中,我们学习了:
- 为什么我们需要 词向量 来更好地表示单词。
- 如何通过 特征化表示 来提高算法的 泛化能力。
- 使用 t-SNE 等降维技术可视化词向量。
在接下来的课程中,我们将更深入地探讨如何使用这些词向量来构建实际的 NLP 应用。敬请期待!🚀