Module 03 · Sequence Models & Attention Mechanism
Basic Models序列到序列基本模型
本周,我们将讨论 序列到序列模型(Sequence-to-Sequence Models),这种模型在从机器翻译到语音识别等多个领域都具有广泛的应用。我们将从基本模型讲起,稍后还会介绍 束搜索(Beam Search)、注意力机制(Attention Mechanism) 等高级内容,并最终讨论用于音频数据(如语音)的模型。让我们开始吧!🚀
基本模型:机器翻译示例
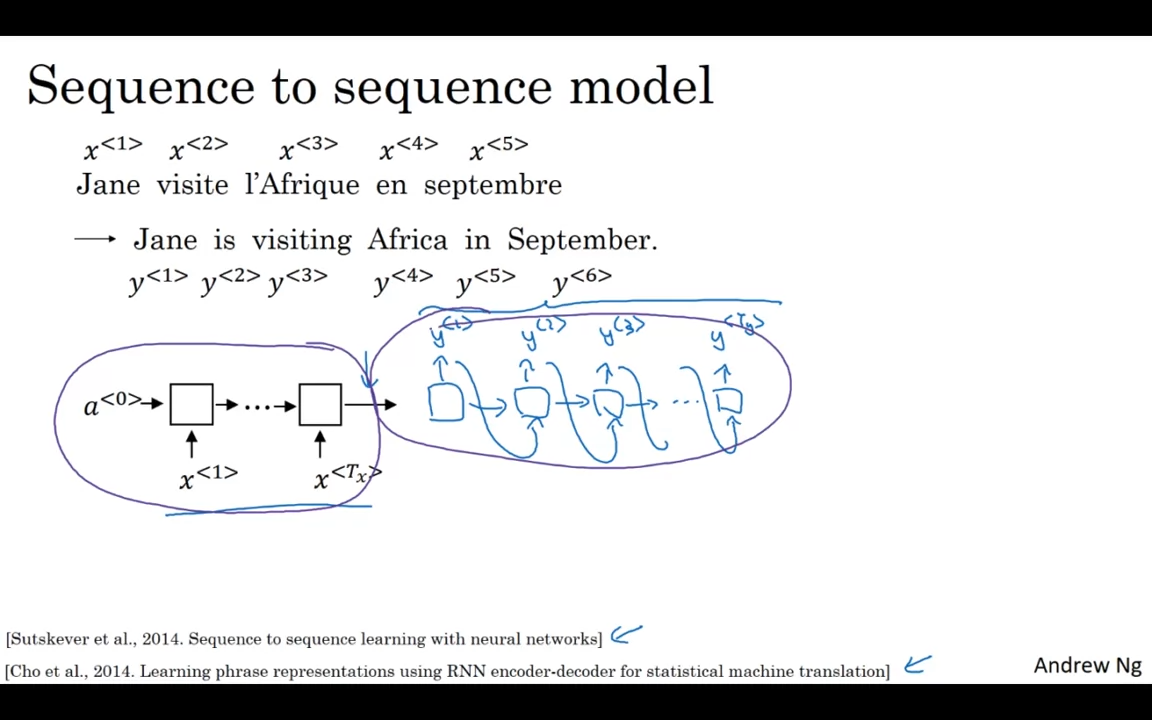
假设你想将法语句子 "Jane visite l'Afrique en septembre" 翻译成英文 "Jane is visiting Africa in September"。我们将使用 x1 到 x5 来表示输入序列中的单词,并使用 y1 到 y6 来表示输出序列中的单词。那么,如何训练一个神经网络将输入序列转换为输出序列呢?
模型架构与训练方法
我们可以采用以下方法来实现这一任务。以下想法主要来源于 Ilya Sutskever、Vinyals Oriol、V. Le Quoc 等的论文,及 Kyunghyun Cho、Bart van Merriënboer、Caglar Gulcehre、Dzmitry Bahdanau 等人的研究。
- 编码器(Encoder)网络:
首先,构建一个 RNN(循环神经网络)作为编码器网络,可能是 GRU 或 LSTM(长短期记忆网络)。编码器将法语单词逐个输入,并最终输出一个向量,代表整个输入句子的含义。 - 解码器(Decoder)网络:
接下来,我们需要构建一个解码器网络,它接收编码器输出的向量作为输入,并开始逐字生成翻译后的英文句子。解码器将按顺序生成翻译单词,直到生成 end-of-sequence 标记为止,表示翻译过程的结束。
模型的实际应用
这个模型的一个显著成果是,给定足够的法语和英语句子对,如果你训练一个模型将法语句子输入并输出对应的英语翻译,它实际上能够较好地工作。
通过这种方式,编码器网络负责将法语句子编码成向量表示,解码器网络则负责基于这个编码生成相应的英语翻译。
图像描述模型(Image Captioning)
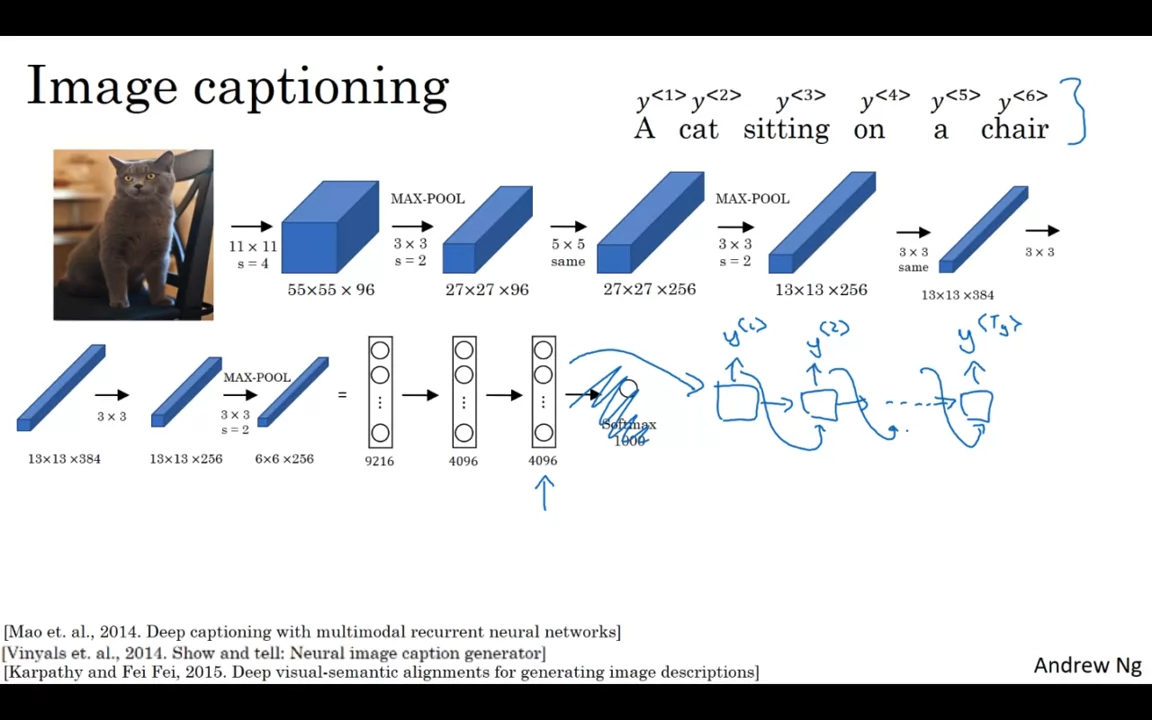
类似于机器翻译,图像描述(Image Captioning)模型也采用了序列到序列的架构。假设你有一张图片,可能你希望系统自动为这张图生成描述,例如:“一只猫坐在椅子上”。
如何训练图像描述模型?
- 图像编码器:
你可以使用 卷积神经网络(CNN),如预训练的 AlexNet,将图像输入并提取其特征。假设我们使用预训练的 AlexNet,其最终输出的 4,096维特征向量 可以作为图像的编码表示。 - 图像描述生成器:
接下来,将这些图像特征输入到 RNN 网络,RNN 网络的任务是生成描述每张图像的句子。与机器翻译类似,我们输入一个特征向量,然后让模型生成一个输出序列 —— 一次生成一个词。
研究背景与进展
这种图像到序列的模型最早由 Jin Hwan Mao、Wei Xu、Yong Chung Wang 等人提出,虽然多组研究人员在相似的时间独立地提出了类似的模型,其中包括 Junhua Mao、Fei-Fei Li、Andrej Karpathy 等。
模型与语言模型的差异
虽然你已经了解了基本的序列到序列模型和图像描述模型,但这与用语言模型生成新文本的方式是有所不同的。一个关键的区别是:
选择最优翻译或描述
- 在机器翻译中,你可能不希望随机选择翻译结果,而是希望选择最可能的翻译。
- 在图像描述中,你也不希望随机生成描述,而是希望生成最合适、最可能的描述。
接下来的视频将介绍如何生成这些最优的翻译和描述。
总结
我们已经介绍了基本的 序列到序列模型,并通过机器翻译和图像描述模型展示了其应用。通过这种架构,模型能够输入一个序列(无论是文本还是图像)并生成相应的输出序列。随着研究的深入,这些模型已经能够在多个领域中取得很好的效果。
在接下来的学习中,我们将继续深入探讨 束搜索(Beam Search)、注意力机制(Attention Mechanism) 等内容,进一步提升模型的性能和输出质量。🎯